ANOVA

Inférence pour des données numériques en R

Mine Cetinkaya-Rundel

Associate Professor of the Practice, Duke University
Coureurs

Inférence pour des données numériques en R

ANOVA : scores de vocabulaire vs. classe sociale auto-déclarée

$H_0$: Le score moyen de vocabulaire est le même dans toutes les classes sociales, $\mu_{lower} = \mu_{working} = \mu_{middle} = \mu_{upper}$.

$H_A$: Les scores moyens de vocabulaire diffèrent pour au moins une paire de classes sociales.

Inférence pour des données numériques en R

Partition de la variabilité

Variabilité totale du score de vocabulaire :

  • Variabilité due aux différences de classe sociale – variabilité intergroupe
  • Variabilité due à tous les autres facteurs – variabilité intragroupe
Inférence pour des données numériques en R

Sortie ANOVA

library(broom)

aov(wordsum ~ class, gss) %>%
  tidy()
term        df     sumsq    meansq   statistic p.value
class        3   236.5644  78.854810  21.73467       0
Residuals  791  2869.8003   3.628066        NA      NA
Inférence pour des données numériques en R

Sommes des carrés

term        df     sumsq    meansq   statistic p.value
class        3   236.5644  78.854810  21.73467       0
Residuals  791  2869.8003   3.628066        NA      NA
  • $SST = 236.5644 + 2869.8003 = 3106.365$ – mesure la variabilité totale de la variable réponse
  • Calculé très semblablement à la variance (mais sans mise à l'échelle par la taille d'échantillon)
  • Pourcentage de variabilité expliquée = $\frac{236.5644}{3106.365} = 7.6\%$
Inférence pour des données numériques en R

Statistique F

term        df     sumsq    meansq   statistic p.value
class        3   236.5644  78.854810  21.73467       0
Residuals  791  2869.8003   3.628066        NA      NA

Statistique F = 21.73467 = $\frac{between~group~var}{within~group~var}$
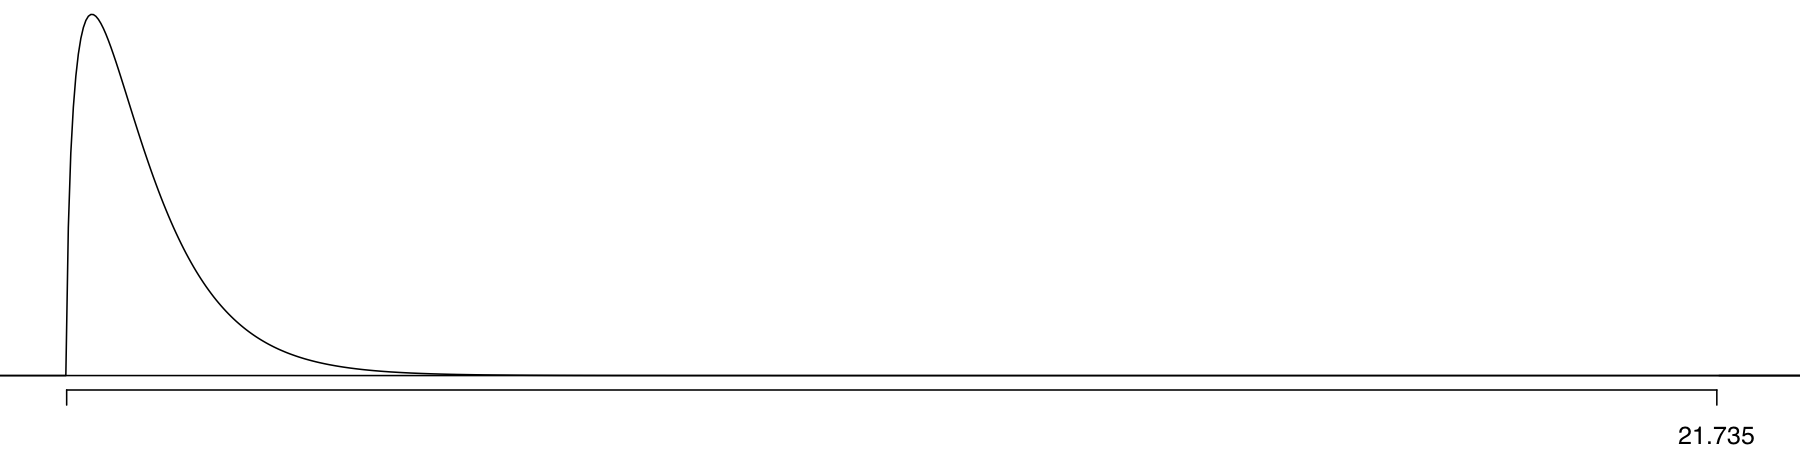
Statistique F et valeur p

Inférence pour des données numériques en R

Passons à la pratique!

Inférence pour des données numériques en R

Preparing Video For Download...