Pipelines en apprentissage supervisé
Concevoir des workflows de Machine Learning en Python

Dr. Chris Anagnostopoulos
Honorary Associate Professor
Données étiquetées
- Variables de caractéristiques (abrégé :
X) - Labels ou classe (abrégé :
y)
credit_scoring.head(4)
  checking_status  duration  ...  foreign_worker class
0            '<0'         6  ...             yes  good
1      '0<=X<200'        48  ...             yes   bad
2   'no checking'        12  ...             yes  good
3            '<0'        42  ...             yes  good
Ingénierie des caractéristiques
- La plupart des classifieurs attendent des caractéristiques numériques
- Il faut convertir les colonnes texte en nombres
Prétraiter avec LabelEncoder de sklearn.preprocessing :
le = LabelEncoder()
le.fit_transform(credit_scoring['checking_status'])[:4]
array([1, 0, 3, 1])
Ajustement du modèle
.fit(features, labels).predict(features)
features, labels = credit_scoring.drop('class', 1), credit_scoring['class']model_nb = GaussianNB() model_nb.fit(features, labels) model_nb.predict(features.head(5))
['good' 'bad' 'good' 'bad' 'good']
60 % de précision sur les 5 premiers exemples.
Sélection de modèle
.fit()optimise les paramètres du modèle donné- Et pour d'autres modèles ?
AdaBoostClassifier surpasse GaussianNB sur les cinq premiers points :
model_ab = AdaBoostClassifier()
model_ab.fit(features, labels)
model_ab.predict(features.head(5))
numpy.array(labels[0:5])
['good' 'bad' 'good' 'good' 'bad']
['good' 'bad' 'good' 'good' 'bad']
Mesure de performance
Plus l’échantillon est grand $\Rightarrow$ meilleures estimations de la précision :
from sklearn.metrics import accuracy_score
accuracy_score(labels, model_nb.predict(features)) # naive bayes
0.706
accuracy_score(labels, model_ab.predict(features)) # adaboost
0.802
Quel est le problème avec ce calcul ?
Surapprentissage et division des données
Surapprentissage : un modèle sera toujours meilleur sur ses données d’entraînment que sur des données jamais vues.
Entraîner sur X_train, y_train, évaluer la précision sur X_test, y_test :
from sklearn.model_selection import train_test_split X_train, X_test, y_train, y_test = train_test_split(X, y, test_size=0.2)GaussianNB().fit(X_train, y_train).predict(X_test)
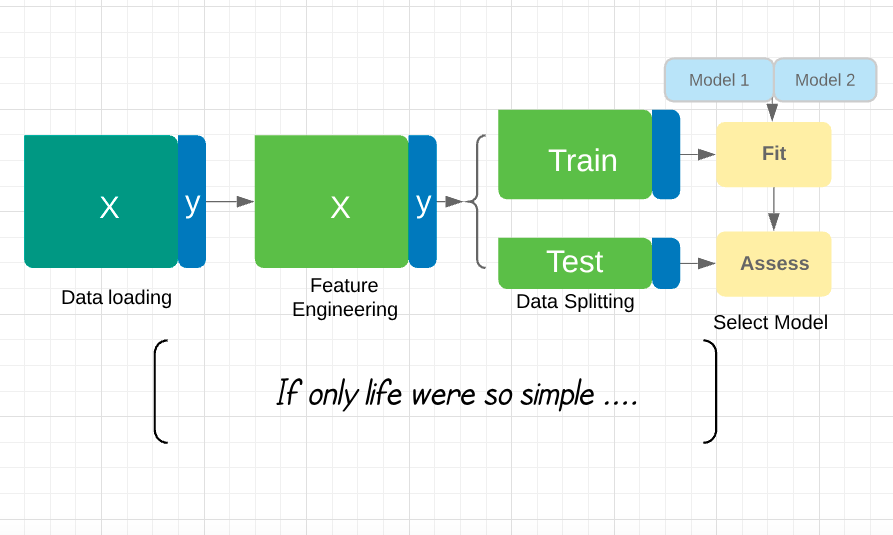
Alors, de quoi parle ce cours ?
- Des moyens extensibles pour régler votre pipeline.
- Garantir la pertinence des prédictions avec des experts métier.
- S’assurer que le modèle reste performant dans le temps.
- Ajuster des modèles quand vous avez peu de labels.
Auriez-vous pu éviter la crise des subprimes ?
Concevoir des workflows de Machine Learning en Python

