Fonctions de perte : partie I

Concevoir des workflows de Machine Learning en Python

Dr. Chris Anagnostopoulos

Honorary Associate Professor

Jeu de données KDD '99 cup

kdd.iloc[0]
kdd.iloc[0]
duration                         51
protocol_type                   tcp
service                        smtp
flag                             SF
src_bytes                      1169
dst_bytes                       332
land                              0
...
dst_host_rerror_rate              0
dst_host_srv_rerror_rate          0
label                          good
Concevoir des workflows de Machine Learning en Python

Faux positifs vs faux négatifs

Binariser l'étiquette :

kdd['label'] = kdd['label'] == 'bad'

Ajuster un classifieur Naive Bayes gaussien :

clf = GaussianNB().fit(X_train, y_train)
predictions = clf.predict(X_test)
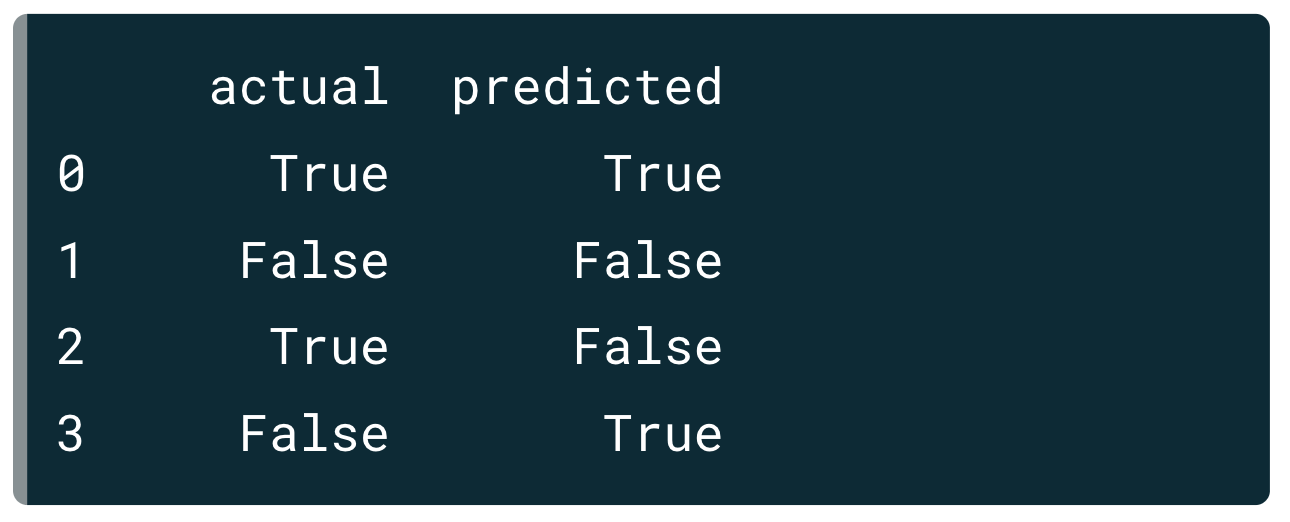
results = pd.DataFrame({
    'actual': y_test,
    'predicted': predictions
})

Concevoir des workflows de Machine Learning en Python

Faux positifs vs faux négatifs

Binariser l'étiquette :

kdd['label'] = kdd['label'] == 'bad'

Ajuster un classifieur Naive Bayes gaussien :

clf = GaussianNB().fit(X_train, y_train)
predictions = clf.predict(X_test)
results = pd.DataFrame({
    'actual': y_test,
    'predicted': predictions
})

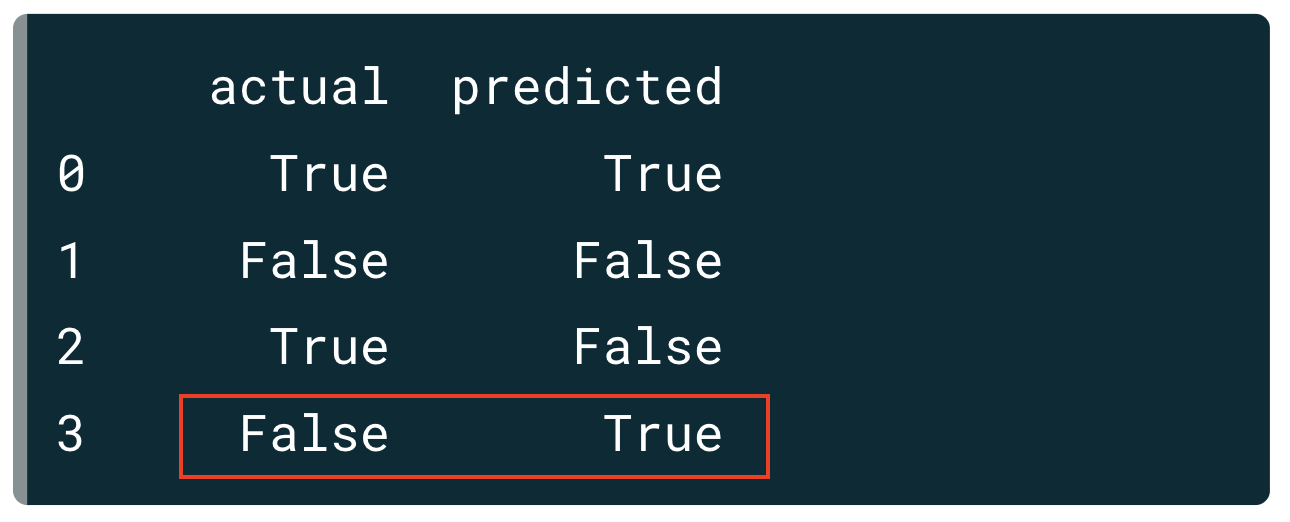
Quatre configurations possibles étiquette/prédiction : toutes deux Vrai, toutes deux Faux, étiquette Vrai avec prédiction Faux, et étiquette Faux avec prédiction Vrai. Cette dernière combinaison est ici mise en évidence.

Concevoir des workflows de Machine Learning en Python

Faux positifs vs faux négatifs

Binariser l'étiquette :

kdd['label'] = kdd['label'] == 'bad'

Ajuster un classifieur Naive Bayes gaussien :

clf = GaussianNB().fit(X_train, y_train)
predictions = clf.predict(X_test)
results = pd.DataFrame({
    'actual': y_test,
    'predicted': predictions
})

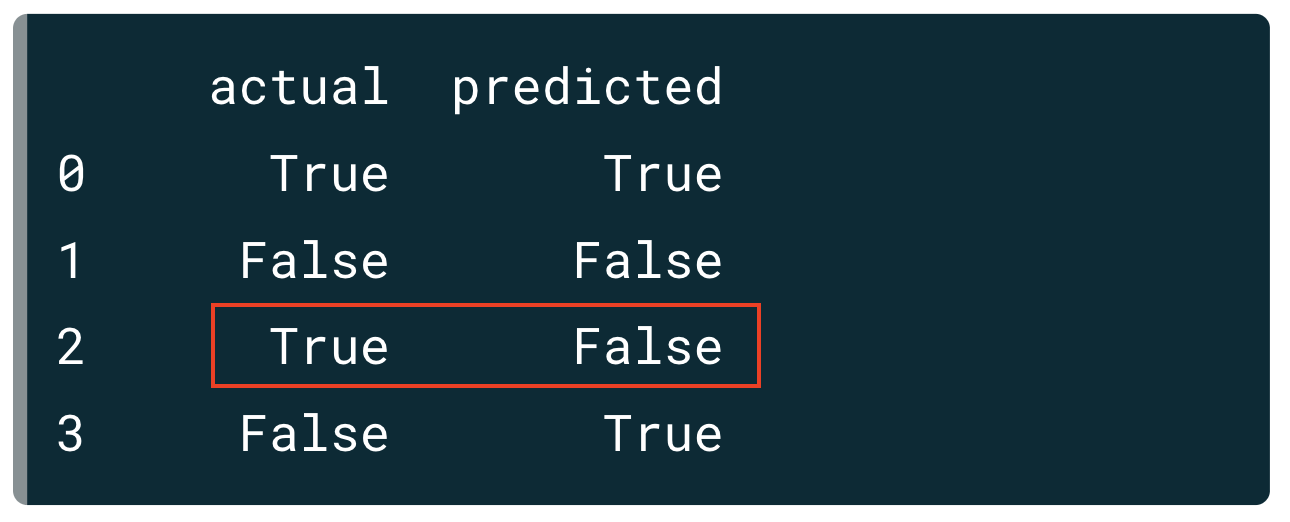
Ici, c'est la combinaison étiquette Vrai et prédiction Faux qui est mise en évidence.

Concevoir des workflows de Machine Learning en Python

Faux positifs vs faux négatifs

Binariser l'étiquette :

kdd['label'] = kdd['label'] == 'bad'

Ajuster un classifieur Naive Bayes gaussien :

clf = GaussianNB().fit(X_train, y_train)
predictions = clf.predict(X_test)
results = pd.DataFrame({
    'actual': y_test,
    'predicted': predictions
})

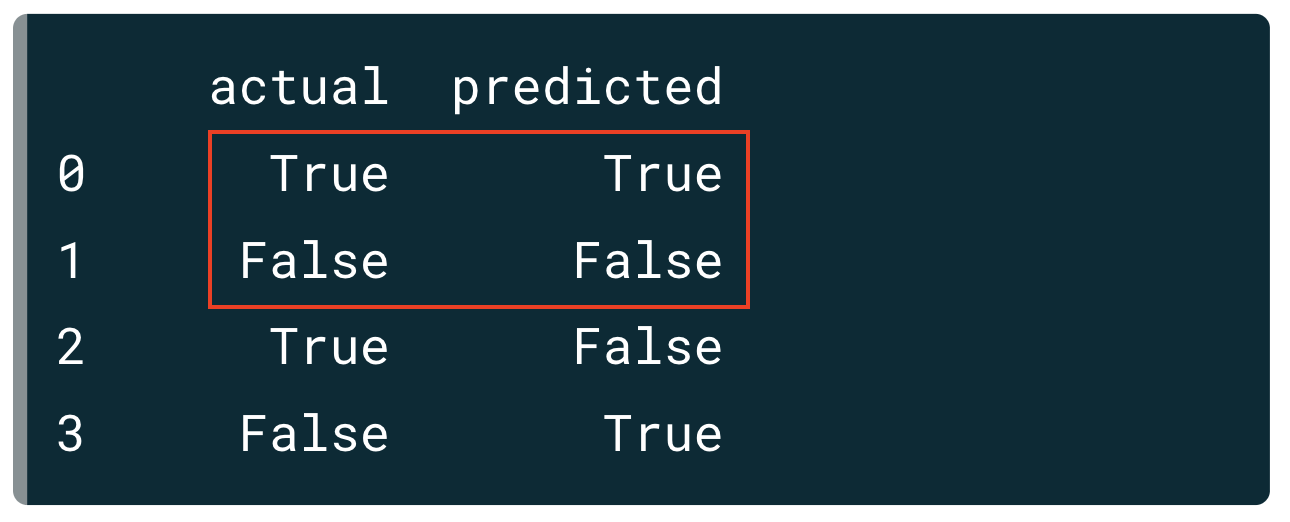
Les deux cas où la prédiction correspond à l'étiquette sont maintenant mis en évidence.

Concevoir des workflows de Machine Learning en Python

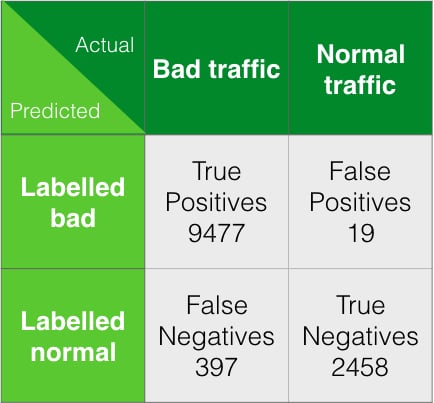
La matrice de confusion

conf_mat = confusion_matrix(
    ground_truth, predictions)
array([[9477,   19],
       [ 397, 2458]])
tn, fp, fn, tp = conf_mat.ravel()
(fp, fn)
(19, 397)

Une matrice de confusion comptant, pour ce jeu de données, les cas de chacune des quatre combinaisons évoquées.

Concevoir des workflows de Machine Learning en Python

Mesures de performance scalaires

accuracy = 1-(fp + fn)/len(ground_truth)

recall = tp/(tp+fn)
fpr = fp/(tn+fp)
precision = tp/(tp+fp)
f1 = 2*(precision*recall)/(precision+recall)
accuracy_score(ground_truth, predictions)
recall_score(ground_truth, predictions)
precision_score(ground_truth, predictions)
f1_score(ground_truth, predictions)
Concevoir des workflows de Machine Learning en Python

Faux positifs vs faux négatifs

Classifieur A :

tn, fp, fn, tp = confusion_matrix(
    ground_truth, predictions_A).ravel()
(fp,fn)
(3, 3)
cost = 10 * fp + fn
33

Classifieur B :

tn, fp, fn, tp = confusion_matrix(
    ground_truth, predictions_B).ravel()
(fp,fn)
(0, 26)

cost = 10 * fp + fn
26
Concevoir des workflows de Machine Learning en Python

Quel classifieur est le meilleur ?

Concevoir des workflows de Machine Learning en Python

Preparing Video For Download...