Les prédictions GARCH correspondent-elles bien aux rendements observés ?

Modèles GARCH en R

Kris Boudt

Professor of finance and econometrics

Critère d'évaluation

  • Cela dépend de ce que vous évaluez
    • la moyenne prédite
    • la variance prédite
    • la distribution prédite des rendements
Modèles GARCH en R

1) Qualité d'ajustement pour la prédiction de la moyenne

À partir du modèle GARCH estimé :
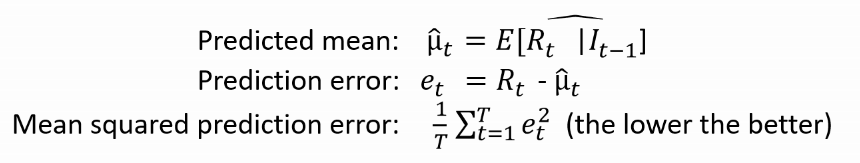
Mise en œuvre

e <- residuals(tgarchfit) 
mean(e ^ 2)
Modèles GARCH en R

2) Qualité d'ajustement pour la prédiction de la variance

Le modèle GARCH implique :
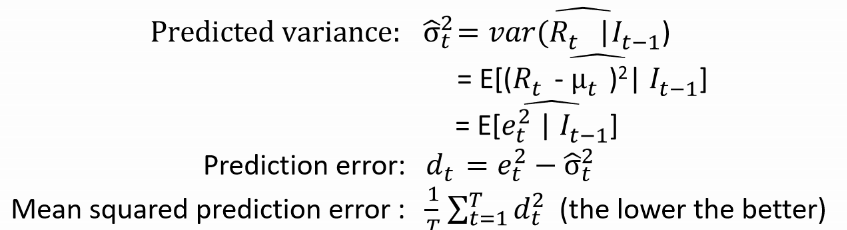
Mise en œuvre

e <- residuals(tgarchfit)
d <- e ^ 2 - sigma(tgarchfit) ^ 2 
mean(d ^ 2)
Modèles GARCH en R

Exemple : rendements EUR/USD

tgarchspec <- ugarchspec(mean.model = list(armaOrder = c(0, 0)),
   variance.model = list(model = "sGARCH", variance.targeting = TRUE),
   distribution.model = "std")
tgarchfit <- ugarchfit(data = EURUSDret, spec = tgarchspec)
# Compute mean squared prediction error for the mean
e <- residuals(tgarchfit) ^ 2
mean(e ^ 2) # 3.836205e-05
# Compute mean squared prediction error for the variance
d <- e ^ 2 - sigma(tgarchfit) ^ 2
mean(d ^ 2) # 5.662366e-09
Modèles GARCH en R

3) Qualité d'ajustement pour la distribution

  • Le modèle GARCH fournit une densité prédite pour tous les rendements de l'échantillon
    • Plus la densité est élevée, plus le rendement est probable sous le modèle GARCH estimé
    • La vraisemblance de l'échantillon est le produit de toutes ces densités ; elle mesure la probabilité que les rendements observés proviennent du modèle GARCH estimé
    • Plus la vraisemblance est élevée, meilleur est l'ajustement aux données
Modèles GARCH en R

Exemple : rendements EUR/USD

likelihood(tgarchfit) # returns 18528.58

Analyser en comparant avec d'autres modèles :

# Modèle complexe avec de nombreux paramètres
flexgarchspec <- ugarchspec(mean.model = list(armaOrder = c(1, 0)),
                            variance.model = list(model = "gjrGARCH"),
                            distribution.model = "sstd")
flexgarchfit <- ugarchfit(data = EURUSDret, spec = flexgarchspec)
likelihood(flexgarchfit) # returns 18530.49
Modèles GARCH en R

Risque de surapprentissage

Attention : nous utilisons une évaluation « in-sample », où l'échantillon d'estimation et celui d'évaluation coïncident.

Risque de surapprentissage :

Le surapprentissage consiste à choisir des modèles trop complexes qui s'ajustent bien aux rendements de l'échantillon d'estimation, mais pas aux rendements futurs hors échantillon.

Modèles GARCH en R

Solution : équilibrer l'ajustement et une pénalité de complexité

  • Un modèle GARCH est parcimonieux lorsqu'il a :
    • une vraisemblance élevée
    • et un nombre de paramètres relativement faible
Modèles GARCH en R

Critères d'information

  • La parcimonie se mesure par des critères d'information.

critères d'information = - vraisemblance + pénalité(nombre de paramètres)

  • Plus c'est faible, mieux c'est.

Règle pratique : Choisir le modèle au critère d'information le plus faible.

Modèles GARCH en R

Résultats des critères d'information

La méthode infocriteria() affiche les critères d'information pour diverses pénalités

infocriteria(tgarchfit)

out Akaike -7.468081 Bayes -7.462833 Shibata -7.468083 Hannan-Quinn -7.466241 `

L'interprétation nécessite une comparaison avec les critères d'autres modèles.

Modèles GARCH en R

Illustration sur les rendements EUR/USD

tgarchspec <- ugarchspec(mean.model = list(armaOrder = c(0, 0)),
   variance.model = list(model = "sGARCH", variance.targeting = TRUE),
   distribution.model = "std")
tgarchfit <- ugarchfit(data = EURUSDret, spec = tgarchspec)
length(coef(tgarchfit)) # only 5 parameters
likelihood(tgarchfit)   # equals 18528.58
flexgarchspec <- ugarchspec(mean.model = list(armaOrder = c(1, 0)),
   variance.model = list(model = "gjrGARCH"), distribution.model = "sstd")
flexgarchfit <- ugarchfit(data = EURUSDret, spec = flexgarchspec)
length(coef(flexgarchfit)) # we now have 8 parameters
likelihood(flexgarchfit) #  18530.49: likelihood increased
Modèles GARCH en R

Quel modèle est le plus parcimonieux pour les rendements EUR/USD ?

Vraisemblance plus élevée : mieux. Critère d'information plus faible : mieux.

infocriteria(tgarchfit) # Modèle simple
Akaike       -7.468435
Bayes        -7.464499
infocriteria(flexgarchfit) # Modèle complexe
Akaike       -7.467239
Bayes        -7.456742

Le modèle simple a le critère d'information le plus faible et doit donc être privilégié ici.

Modèles GARCH en R

Le résultat dépend du cas : rendements MSFT

tgarchfit <- ugarchfit(data = msftret, spec = tgarchspec)
flexgarchfit <- ugarchfit(data = msftret, spec = flexgarchspec)
infocriteria(tgarchfit)
Akaike       -5.481895
Bayes        -5.477833
infocriteria(flexgarchfit) 
Akaike       -5.489087
Bayes        -5.478255

Ici, le modèle complexe a le critère d'information le plus faible et doit donc être privilégié.

Modèles GARCH en R

KISS : Keep it Sophisticatedly Simple

Modèles GARCH en R

Preparing Video For Download...