Regroupement et modèles de clusters
Simulation d’événements discrets en Python

Diogo Costa (PhD, MSc)
Adjunct Professor, University of Saskatchewan, Canada & CEO of ImpactBLUE-Scientific
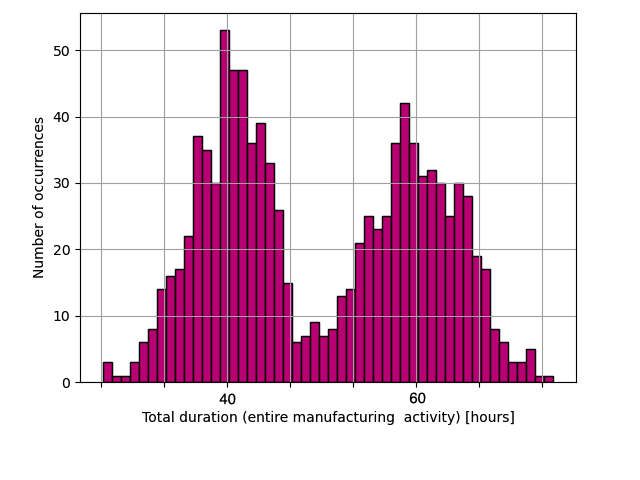
Histogrammes des résultats du modèle
Usage : Créer un histogramme du jeu data avec 50 bacs
plt.hist(data, bins=50)
Analyse de clusters et application aux modèles
- Applications
- Reconnaissance de formes (p. ex., résultats de modèle)
- Analyse d’images
- Compression de données
- Infographie
Apprentissage automatique
Dans les modèles à événements discrets
- Identifier les motifs de sortie du modèle
- Informations plus exploitables
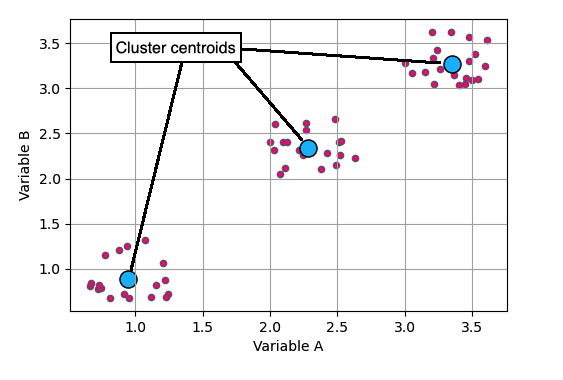
Regroupement k-means
Observations et centroïdes
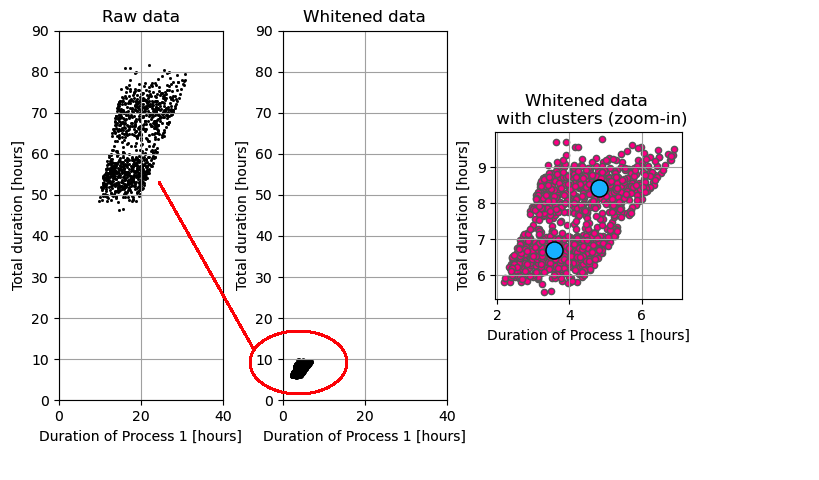
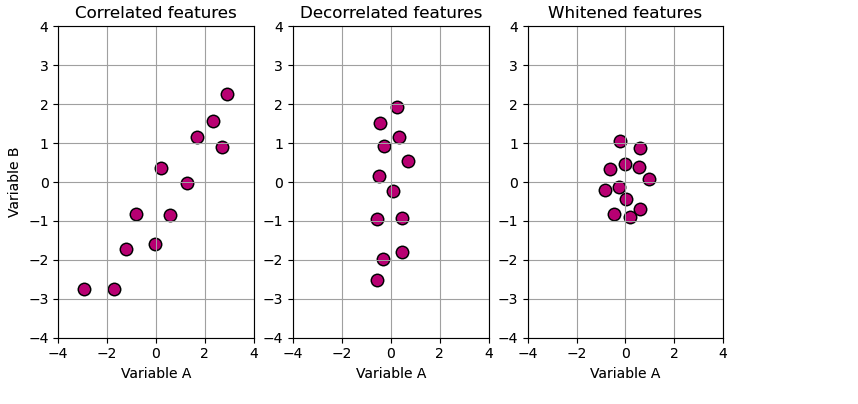
Blanchiment : décorrélation et rééchelonnage
Avant k-means : blanchiment des données
- Décorréler les données
obs - Rééchelonner chaque dimension de
obspar son écart-type
Exemple : blanchiment et k-means
- Activité manufacturière avec plusieurs processus
- Examinons l’impact de
Process 1