Créer des pipelines différés
Programmation parallèle avec Dask en Python

James Fulton
Climate Informatics Researcher
Blocs de données
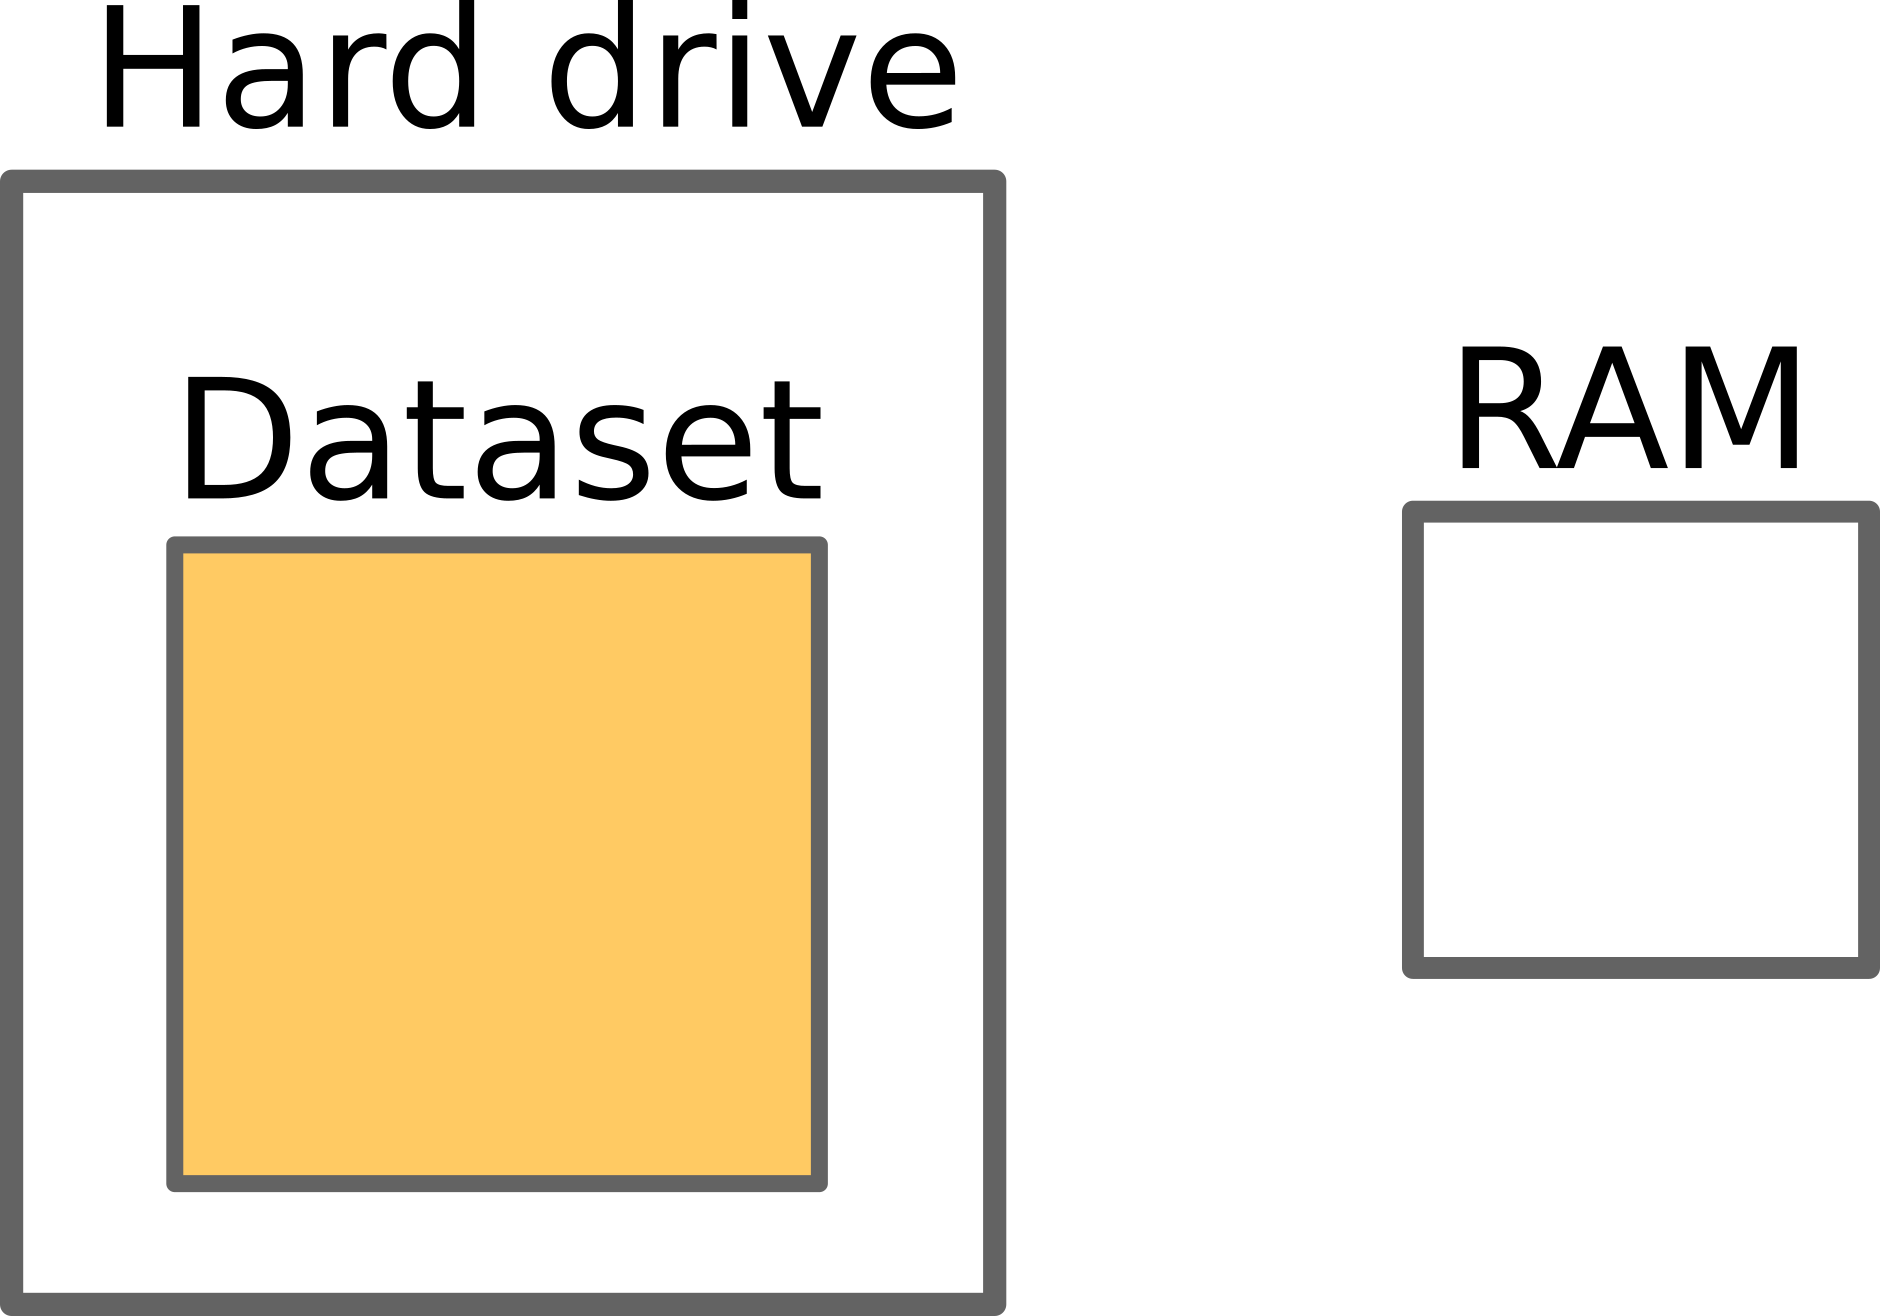
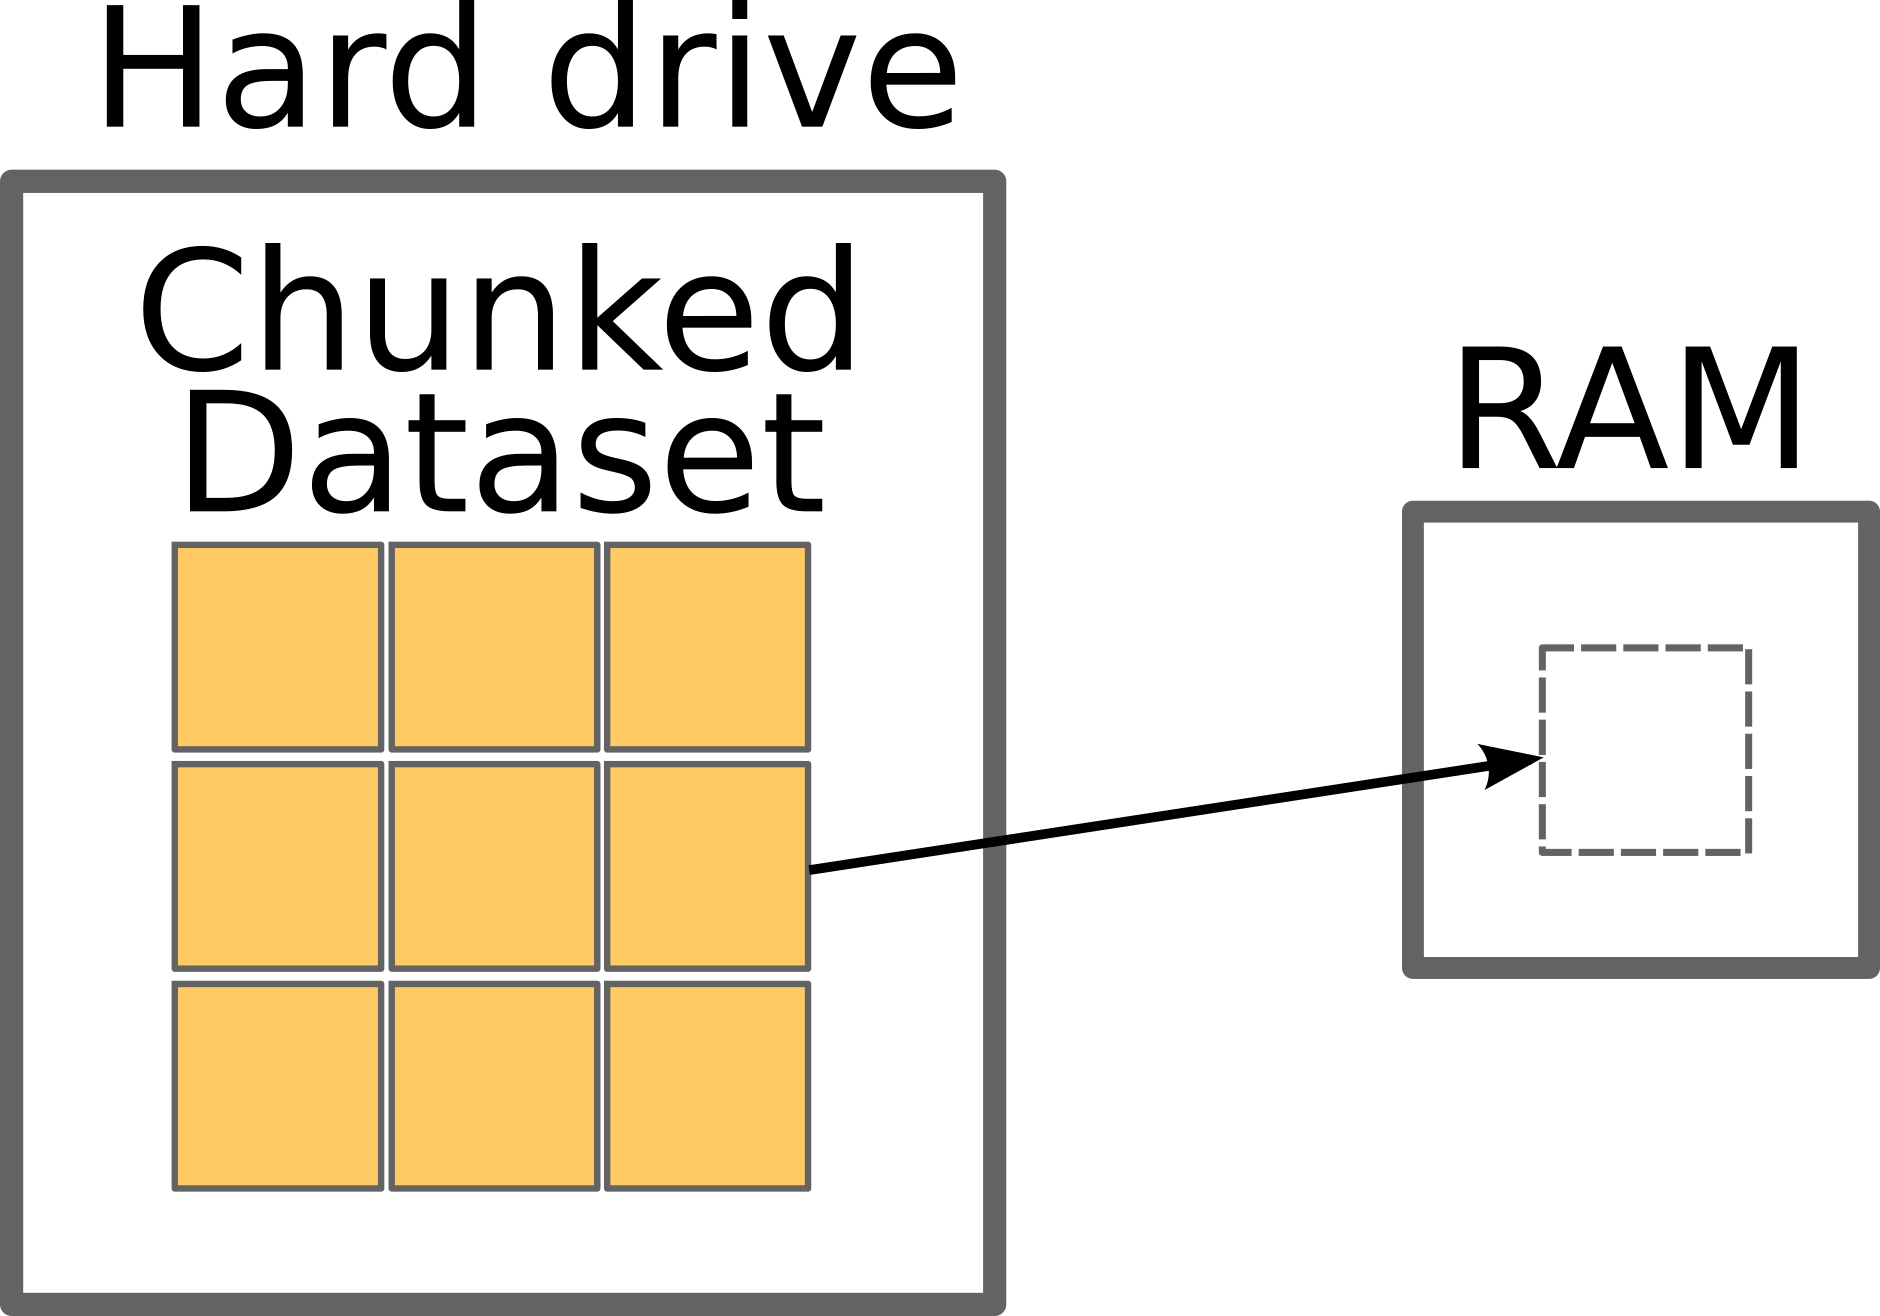
Jeu de données Spotify songs
files = [
  '2005_tracks.csv',
  '2006_tracks.csv',
  '2007_tracks.csv',
  '2008_tracks.csv',
  '2009_tracks.csv',
  '2010_tracks.csv',
  ...
  '2020_tracks.csv',
]
Jeu de données Spotify songs
                       name  duration_ms release_date  ...
0     Aldrig (feat. Carmon)       247869   2019-01-01  ...
2  2019 - The Year to Build       288105   2019-01-01  ...
3                 Na zawsze       186812   2019-01-01  ...
4         Humo en la Trampa       258354   2019-01-01  ...
5                     Au Au       176000   2019-01-01  ...
...                     ...          ...          ...  ...
Analyser les données
import pandas as pd maximums = [] for file in files: # Charger chaque fichier df = pd.read_csv(file)# Trouver la durée max par fichier max_length = df['duration_ms'].max()# Enregistrer ce maximum maximums.append(max_length)# Trouver le maximum de tous les maxima absolute_maximum = max(maximums)
Analyser les données
import pandas as pd

maximums = []

for file in files:
    # Charger chaque fichier
    df = delayed(pd.read_csv)(file) # <------- retarder le chargement
    # Trouver la durée max par fichier
    max_length = df['duration_ms'].max()
    # Enregistrer ce maximum
    maximums.append(max_length)

# Trouver le maximum de tous les maxima
absolute_maximum = max(maximums)
Analyser les données
import pandas as pd

maximums = []

for file in files:
    # Charger chaque fichier
    df = delayed(pd.read_csv)(file) # <------- retarder le chargement
    # Trouver la durée max par fichier
    max_length = df['duration_ms'].max()
    # Enregistrer ce maximum
    maximums.append(max_length)

# Trouver le maximum de tous les maxima
absolute_maximum = delayed(max)(maximums) # <------- retarder la fonction max()
Utiliser les méthodes d'un objet différé
import pandas as pd

maximums = []

for file in files:
    df = delayed(pd.read_csv)(file)
    # Utiliser la méthode .max()
    max_length = df['duration_ms'].max()

    maximums.append(max_length)


absolute_maximum = delayed(max)(maximums)
print(max_length)
Delayed('max-0602855d-3ee6-4c43-a4d2-...')
- Les méthodes et propriétés d'un objet différé renvoient de nouveaux objets différés
print(df.shape)
print(df.shape.compute())
Delayed('getattr-bc1e8838ab...')
(11907, 12)
Utiliser les méthodes d'un objet différé
import pandas as pd

maximums = []

for file in files:
    df = delayed(pd.read_csv)(file)
    # Utiliser une méthode qui n'existe pas
    max_length = df['duration_ms'].fake()

    maximums.append(max_length)


absolute_maximum = delayed(max)(maximums)
print(max_length)
Delayed('max-6c026036-5daf-4b2-...')
- Les méthodes ne s'exécutent qu'après l'appel à
.compute()
print(max_length.compute())
...
AttributeError: 'Series' object has no
attribute 'fake'
Utiliser les méthodes d'un objet différé
import pandas as pd

maximums = []

for file in files:
    df = delayed(pd.read_csv)(file)

    max_length = df['duration_ms'].max()
    # Ajouter l'objet différé à la liste
    maximums.append(max_length)

# Lancer max différé sur une liste d'objets différés
absolute_maximum = delayed(max)(maximums)
maximums est une liste d'objets différés
print(maximums)
[Delayed('max-80b...'),
Delayed('max-fa15d...',
...]
Calculer des listes d'objets différés
import pandas as pd

maximums = []

for file in files:
    df = delayed(pd.read_csv)(file)

    max_length = df['duration_ms'].max()
    # Ajouter l'objet différé à la liste
    maximums.append(max_length)

# Calculer tous les maximums
all_maximums = dask.compute(maximums)
print(all_maximums)
([2539418, 4368000, ...
... 4511716, 4864333],)
Calculer des listes d'objets différés
import pandas as pd

maximums = []

for file in files:
    df = delayed(pd.read_csv)(file)

    max_length = df['duration_ms'].max()

    maximums.append(max_length)

# Calculer tous les maximums
all_maximums = dask.compute(maximums)[0]
print(all_maximums)
[2539418, 4368000, ...
... 4511716, 4864333]
Différer ou non
def get_max_track(df):
    return df['duration_ms'].max()

for file in files:
    df = delayed(pd.read_csv)(file)
    # Utiliser une fonction pour trouver le max
    max_length = get_max_track(df)

    maximums.append(max_length)


absolute_maximum = delayed(max)(maximums)
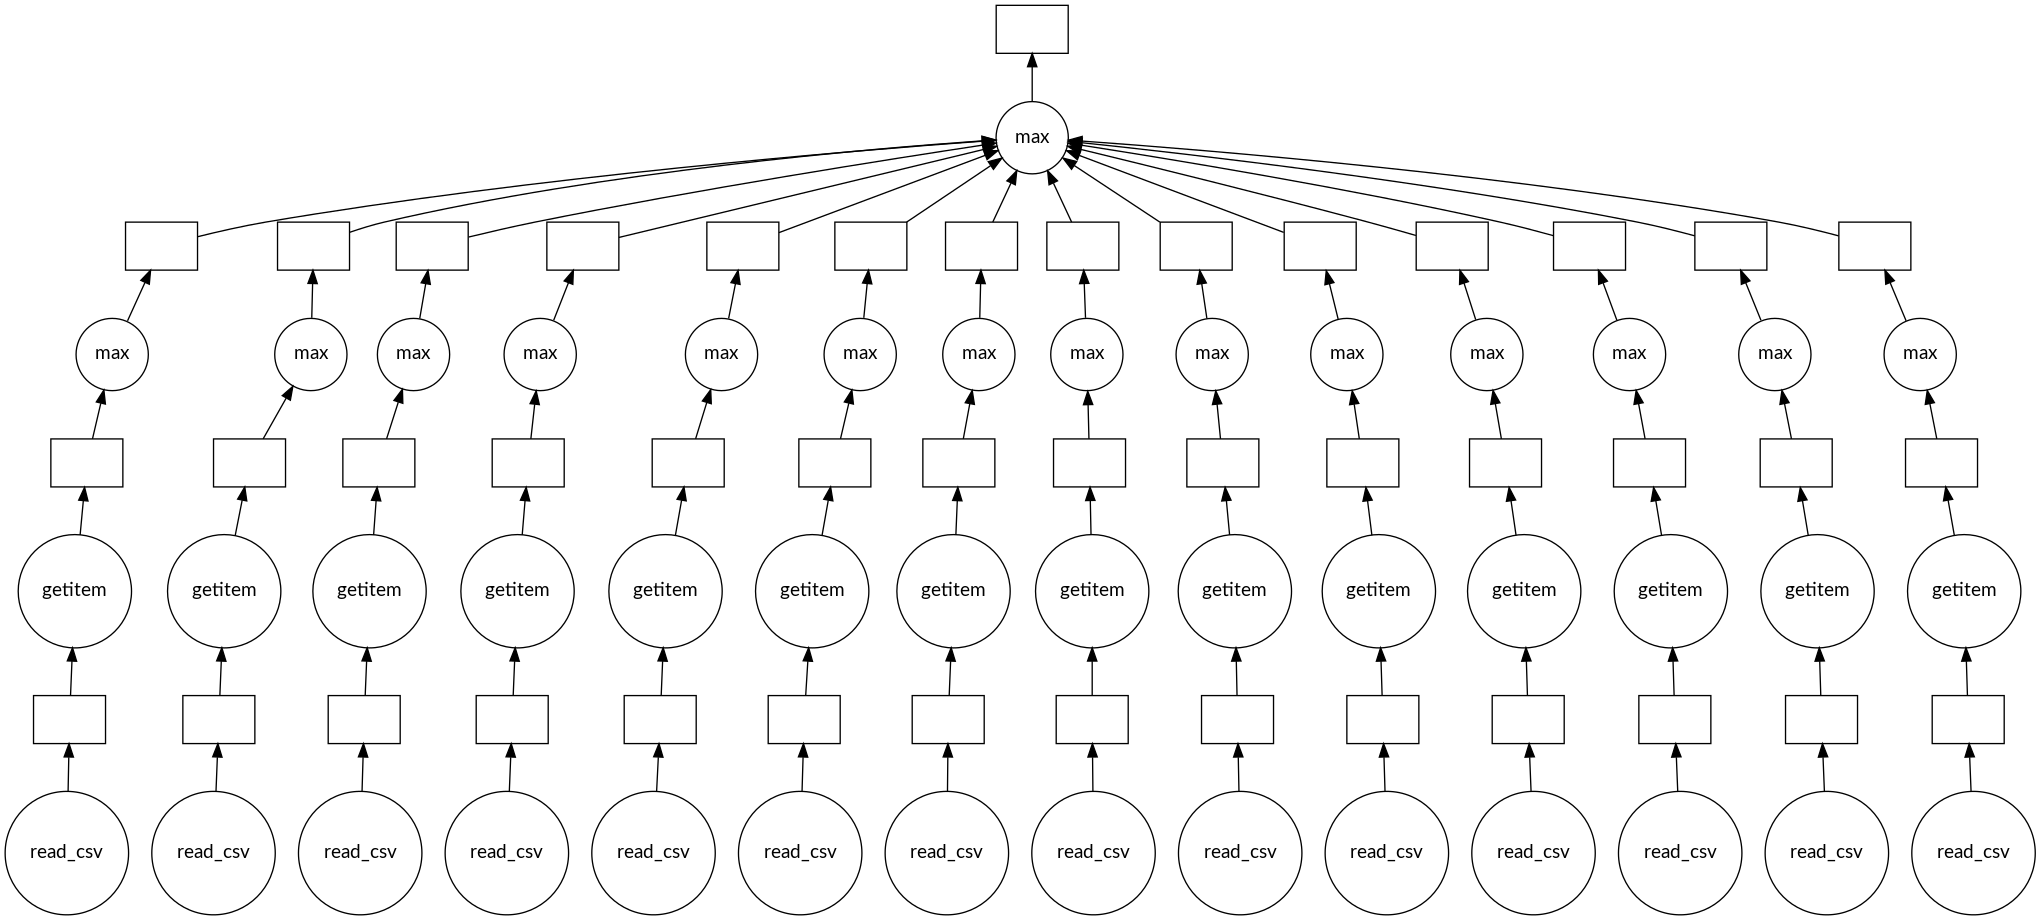
Graphe de tâches approfondi
absolute_maximum.visualize()
Passons à la pratique !
Programmation parallèle avec Dask en Python

