Imputation fondée sur un modèle

Gérer les données manquantes avec des imputations en R

Michal Oleszak

Machine Learning Engineer

Imputation fondée sur un modèle

  • Imputer chaque variable avec un modèle statistique adapté.
  • Tenir compte des relations connues dans les données.
Gérer les données manquantes avec des imputations en R

Procédure d'imputation fondée sur un modèle

  • Boucler sur les variables.
  • Pour chacune, créer un modèle qui l'explique.
  • Utiliser le modèle pour prédire les valeurs manquantes.
  • Répéter l'imputation aux emplacements initialement manquants.
Gérer les données manquantes avec des imputations en R

Imputation pas à pas fondée sur un modèle
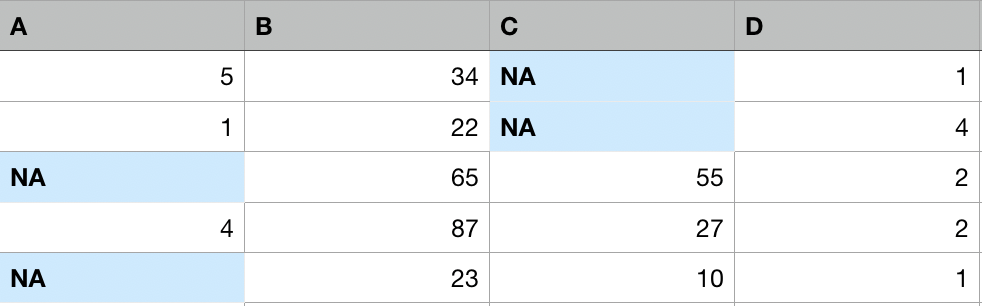
Une table avec quatre variables (A, B, C et D) et cinq lignes, remplie de données factices. Deux variables (A et C) ont deux valeurs manquantes chacune, toutes dans des lignes différentes.

Gérer les données manquantes avec des imputations en R

Imputation pas à pas fondée sur un modèle
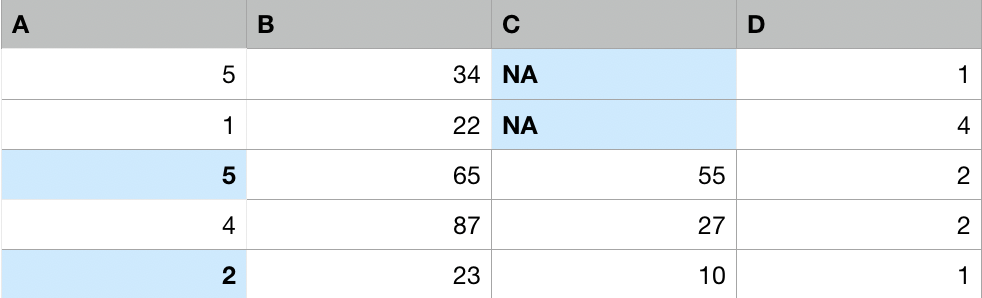
Une table avec quatre variables (A, B, C et D) et cinq lignes, remplie de données factices. Les valeurs manquantes de A ont été imputées.

  1. Prédire les valeurs manquantes de A.
Gérer les données manquantes avec des imputations en R

Imputation pas à pas fondée sur un modèle
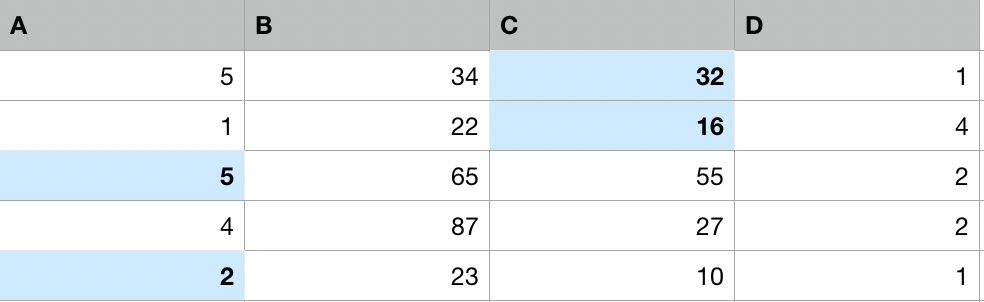
Une table avec quatre variables (A, B, C et D) et cinq lignes, remplie de données factices. Les valeurs manquantes de A et C ont été imputées.

  1. Prédire les valeurs manquantes de A.
  2. Considérer les données imputées de A comme observées et prédire les valeurs manquantes de C.
Gérer les données manquantes avec des imputations en R

Imputation pas à pas fondée sur un modèle
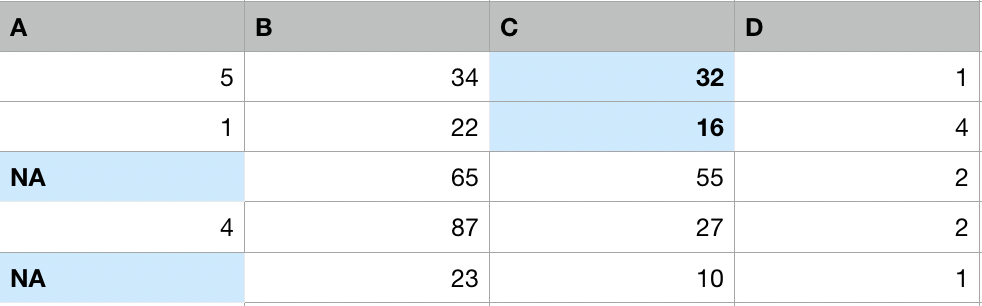
Une table avec quatre variables (A, B, C et D) et cinq lignes, remplie de données factices. Les valeurs manquantes de C ont été imputées.

  1. Prédire les valeurs manquantes de A.
  2. Considérer les données imputées de A comme observées et prédire les valeurs manquantes de C.
  3. Considérer les données imputées de C comme observées et re-prédire A là où elles manquaient au départ.
  4. Continuer jusqu'à convergence.
Gérer les données manquantes avec des imputations en R

Comment choisir le modèle

Le modèle pour chaque variable dépend de son type :

  • Variables continues : régression linéaire
  • Variables binaires : régression logistique
  • Variables catégorielles : régression logistique multinomiale
  • Variables de comptage : régression de Poisson
Gérer les données manquantes avec des imputations en R

Imputation par régression linéaire simple

Imputer Height et Weight dans nhanes avec un modèle linéaire :

library(simputation)
nhanes_imp <- impute_lm(nhanes, Height + Weight ~ .)

Vérifier qu'elles ont bien été imputées :

nhanes_imp %>% 
  is.na() %>% 
  colSums()
Age     Gender     Weight     Height   Diabetes    TotChol      Pulse PhysActive 
  0          0         32         30          1         85         32         26
Gérer les données manquantes avec des imputations en R

Imputation par régression linéaire en pratique

Initialiser les valeurs manquantes avec hotdeck et enregistrer leurs emplacements :

nhanes_imp <- hotdeck(nhanes)
missing_height <- nhanes_imp$Height_imp
missing_weight <- nhanes_imp$Weight_imp

Itérer 5 fois sur Height et Weight, en les imputant aux emplacements initialement manquants :

for (i in 1:5) {
  nhanes_imp$Height[missing_height] <- NA
  nhanes_imp <- impute_lm(nhanes_imp, Height ~ Age + Gender + Weight)
  nhanes_imp$Weight[missing_weight] <- NA
  nhanes_imp <- impute_lm(nhanes_imp, Weight ~ Age + Gender + Height)
}
Gérer les données manquantes avec des imputations en R

Détecter la convergence


for (i in 1:5) {

  nhanes_imp$Height[missing_height] <- NA
  nhanes_imp <- impute_lm(nhanes, Height ~ Age + Gender + Weight)
  nhanes_imp$Weight[missing_weight] <- NA
  nhanes_imp <- impute_lm(nhanes, Weight ~ Age + Gender + Height)


}
Gérer les données manquantes avec des imputations en R

Détecter la convergence

diff_height <- c()
diff_weight <- c()
for (i in 1:5) {

  nhanes_imp$Height[missing_height] <- NA
  nhanes_imp <- impute_lm(nhanes, Height ~ Age + Gender + Weight)
  nhanes_imp$Weight[missing_weight] <- NA
  nhanes_imp <- impute_lm(nhanes, Weight ~ Age + Gender + Height)


}
Gérer les données manquantes avec des imputations en R

Détecter la convergence

diff_height <- c()
diff_weight <- c()
for (i in 1:5) {
  prev_iter <- nhanes_imp
  nhanes_imp$Height[missing_height] <- NA
  nhanes_imp <- impute_lm(nhanes, Height ~ Age + Gender + Weight)
  nhanes_imp$Weight[missing_weight] <- NA
  nhanes_imp <- impute_lm(nhanes, Weight ~ Age + Gender + Height)


}
Gérer les données manquantes avec des imputations en R

Détecter la convergence

diff_height <- c()
diff_weight <- c()
for (i in 1:5) {
  prev_iter <- nhanes_imp
  nhanes_imp$Height[missing_height] <- NA
  nhanes_imp <- impute_lm(nhanes, Height ~ Age + Gender + Weight)
  nhanes_imp$Weight[missing_weight] <- NA
  nhanes_imp <- impute_lm(nhanes, Weight ~ Age + Gender + Height)
  diff_height <- c(diff_height, mapc(prev_iter$Height, nhanes_imp$Height))
  diff_weight <- c(diff_weight, mapc(prev_iter$Weight, nhanes_imp$Weight))
}
Gérer les données manquantes avec des imputations en R

Détecter la convergence

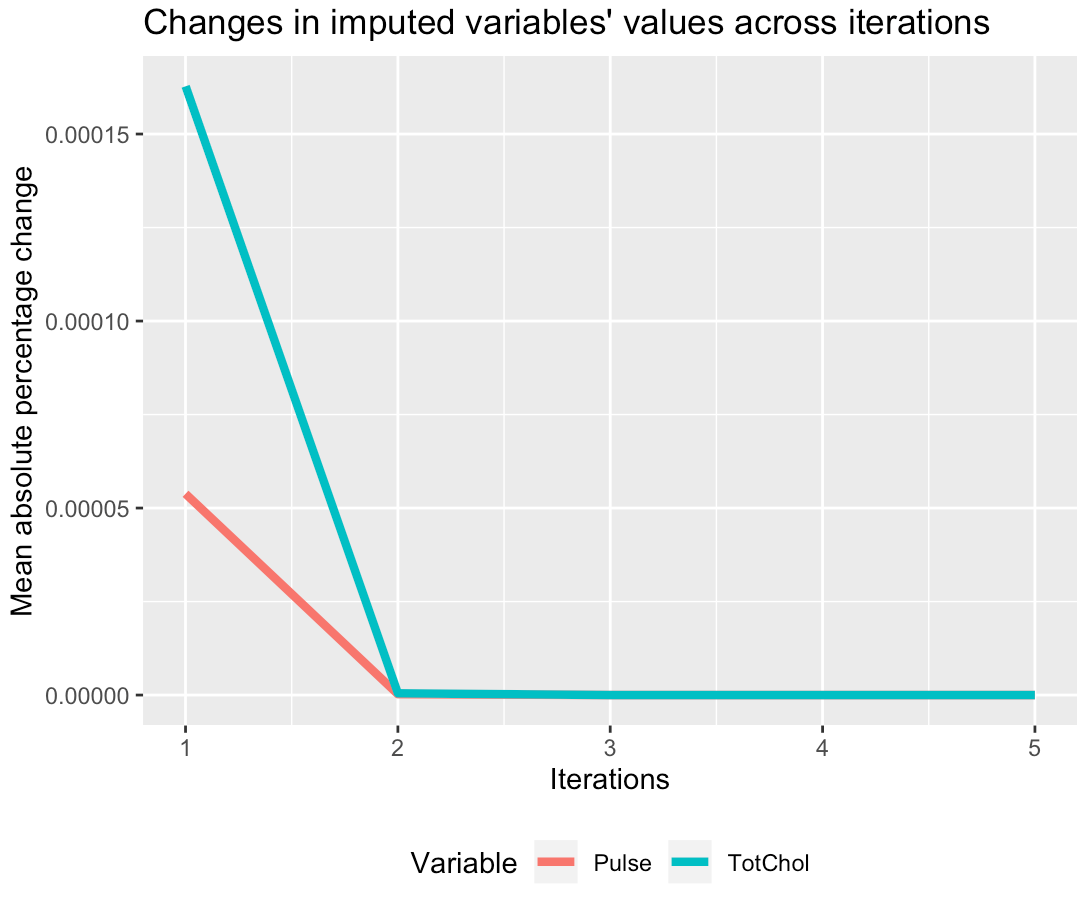
Un graphique de lignes avec deux courbes, pour les variables Pulse et TotChol. L'axe des x montre le nombre d'itérations, l'axe des y la variation moyenne absolue en pourcentage des valeurs imputées entre itérations. Après la première itération, les deux variables changent un peu. À partir de l'itération 2, elles ne changent plus.

Gérer les données manquantes avec des imputations en R

Passons à la pratique !

Gérer les données manquantes avec des imputations en R

Preparing Video For Download...