Imputation par arbres de décision
Gérer les données manquantes avec des imputations en R

Michal Oleszak
Machine Learning Engineer
Approche d'imputation par arbres
Utilisez des modèles de Machine Learning pour prédire les valeurs manquantes !
- Approche non paramétrique : aucune hypothèse sur les relations entre variables.
- Capte des schémas non linéaires complexes.
- Souvent plus performante que de simples modèles statistiques.
Dans ce cours : package missForest, basé sur randomForest
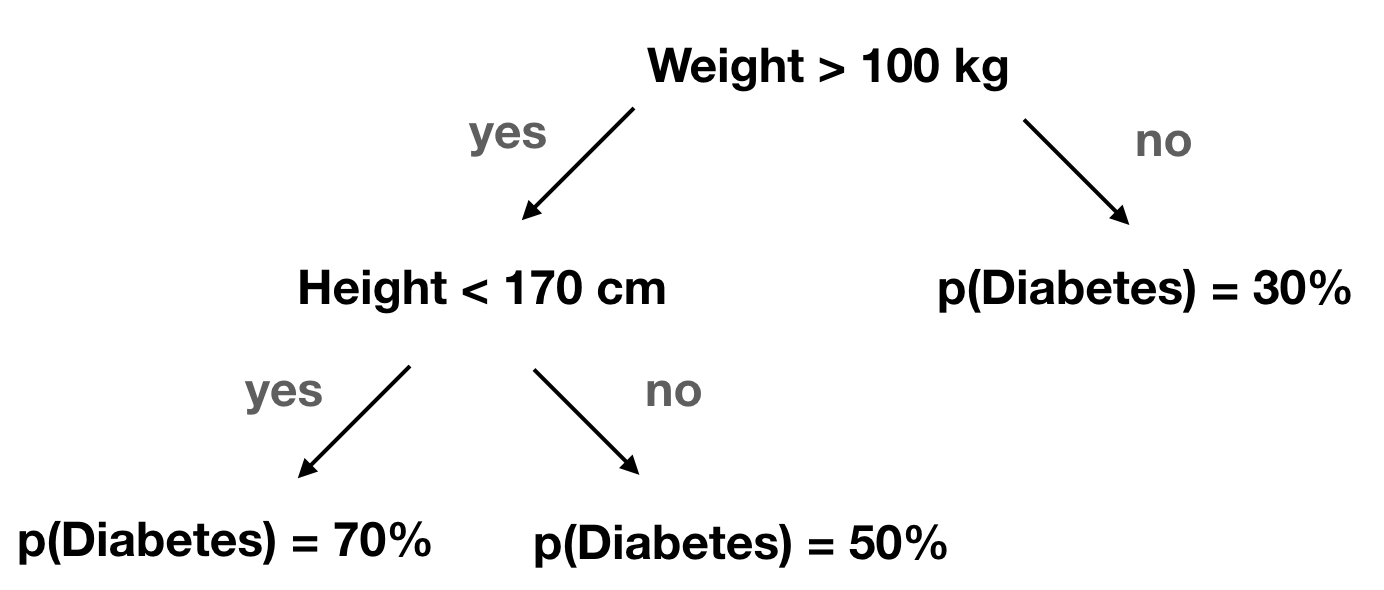
Arbres de décision
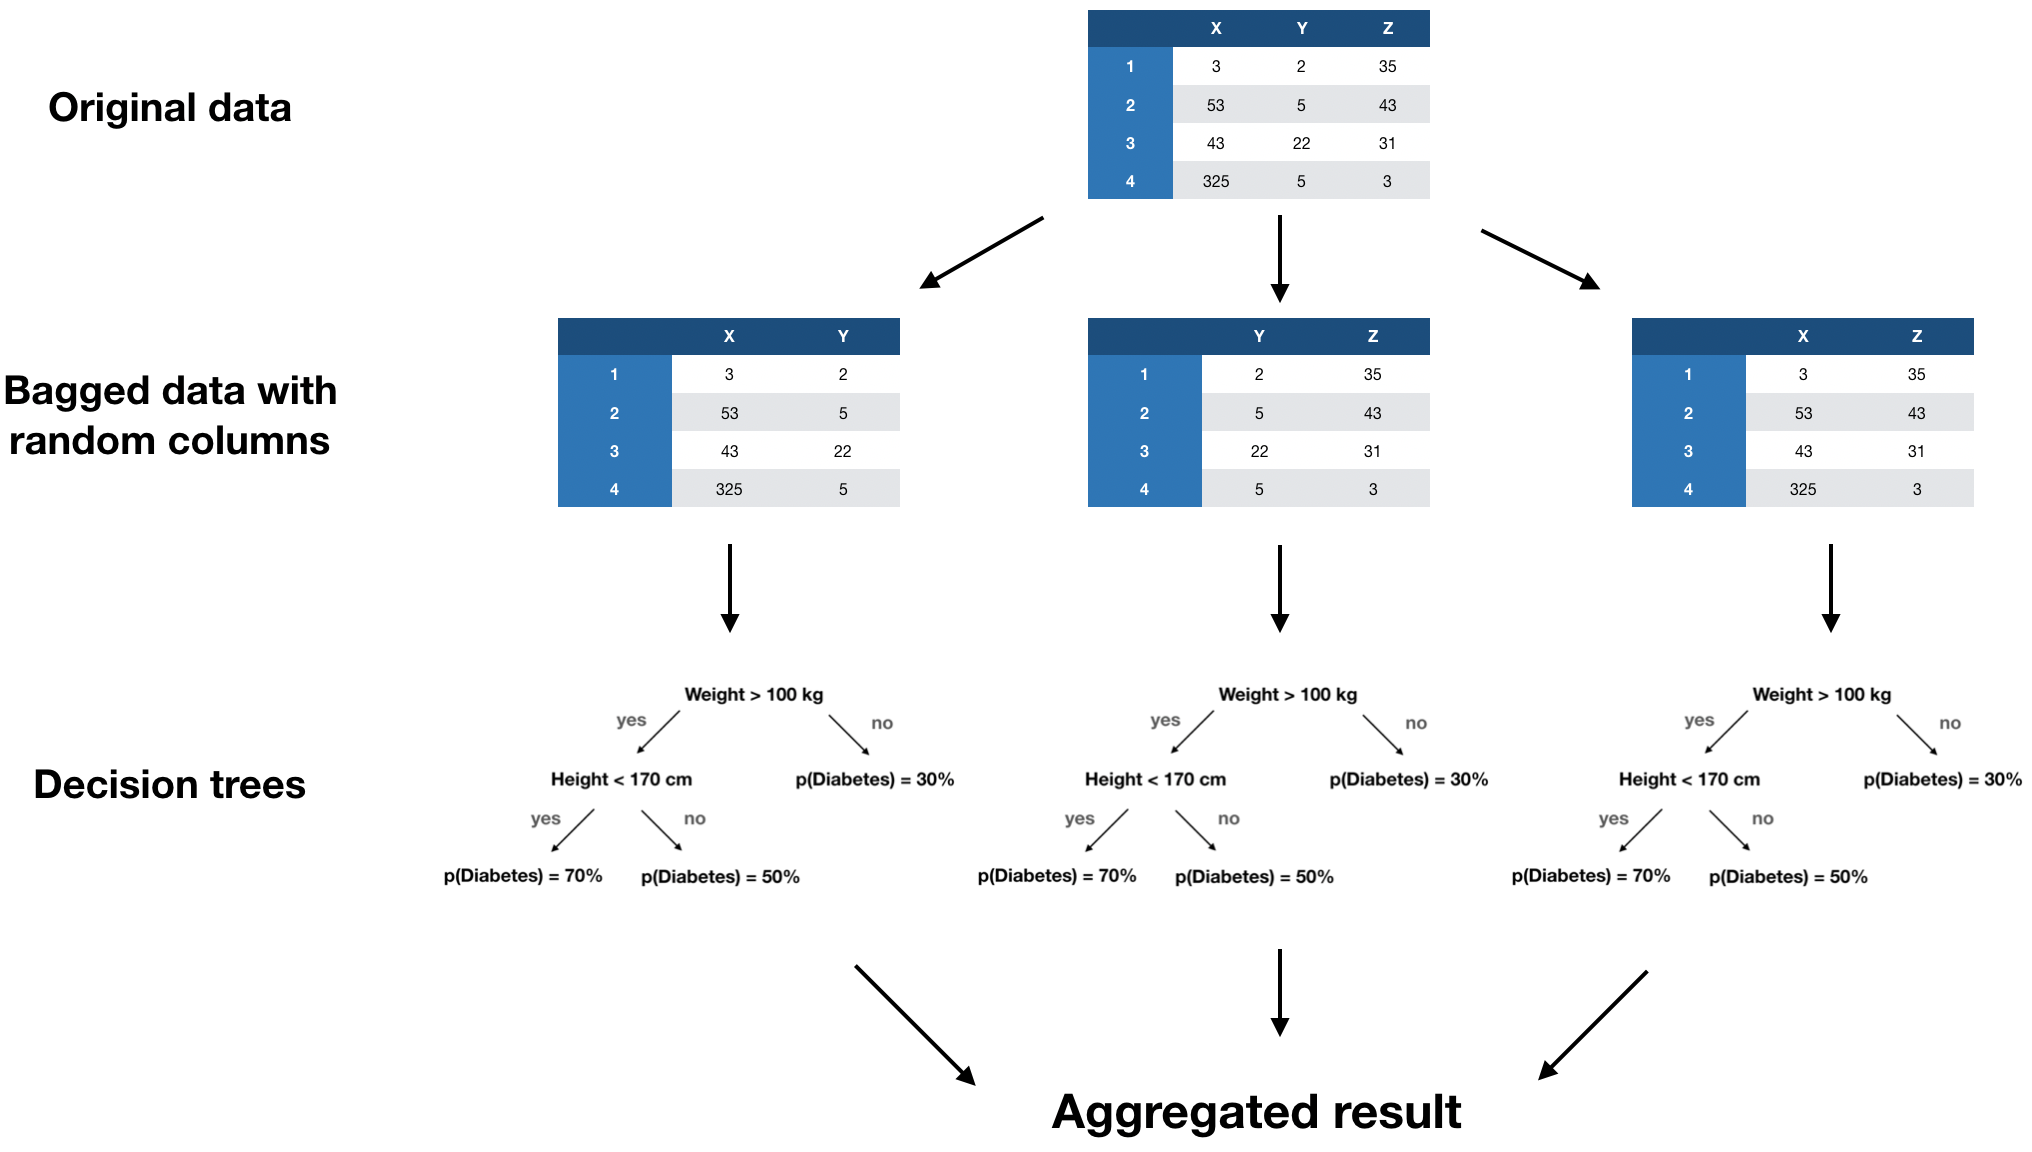
Forêts aléatoires
Algorithme missForest
- Faire une première estimation des valeurs manquantes par imputation par la moyenne.
- Trier les variables par ordre croissant de valeurs manquantes.
- Pour chaque variable x :
- Ajuster une forêt aléatoire sur la partie observée de x (en utilisant les autres variables comme prédicteurs).
- L'utiliser pour prédire la partie manquante de x.
- Répéter l'étape 3 jusqu'à ce que les valeurs imputées se stabilisent.
missForest en pratique
nhanes %>% is.na() %>% colSums()
Age     Gender     Weight     Height   Diabetes    TotChol      Pulse PhysActive
  0          0          9          8          1         85         32         26
library(missForest)
imp_res <- missForest(nhanes)
nhanes_imp  <- imp_res$ximp
nhanes_imp %>% is.na() %>% colSums()
Age     Gender     Weight     Height   Diabetes    TotChol      Pulse PhysActive
  0          0          0          0          0          0          0          0
Erreur d'imputation
missForest() fournit une estimation de l'erreur d'imputation « out-of-bag » (OOB) :
- NRMSE (erreur quadratique moyenne normalisée) pour les variables continues.
- PFC (proportion d'entrées mal classées) pour les variables catégorielles.
Dans les deux cas, de bonnes performances donnent une valeur proche de 0 ; autour de 1, le résultat est médiocre.
imp_res <- missForest(nhanes)
imp_res$OOBerror
      NRMSE         PFC
0.147687025 0.003676471
Erreur d'imputation
missForest() fournit une estimation de l'erreur d'imputation « out-of-bag » (OOB) :
- NRMSE (erreur quadratique moyenne normalisée) pour les variables continues.
- PFC (proportion d'entrées mal classées) pour les variables catégorielles.
Dans les deux cas, de bonnes performances donnent une valeur proche de 0 ; autour de 1, le résultat est médiocre.
imp_res <- missForest(nhanes, variablewise = TRUE)
imp_res$OOBerror
    MSE       PFC       MSE       MSE       PFC       MSE       MSE       MSE
0.00000   0.00000 285.79563  40.42142   0.00735   0.53444 129.03609   0.17576
Compromis vitesse–précision
Faire croître plusieurs forêts aléatoires peut être long.
Idée : sacrifier un peu de précision et réduire la taille de la forêt pour accélérer le calcul.
- Réduire le nombre d'arbres de chaque forêt (argument
ntree). - Réduire le nombre de variables candidates au split (argument
mtry).
L'impact sur le temps de calcul diffère :
- Réduire
ntreea un effet linéaire. - Réduire
mtryaccélère davantage quand il y a beaucoup de variables.
Compromis vitesse–précision en pratique
Paramètres par défaut :
start_time <- Sys.time()
imp_res <- missForest(nhanes)
end_time <- Sys.time()
print(imp_res$OOBerror)
print(end_time - start_time)
      NRMSE         PFC
0.147687025 0.003676471
Time difference of 5.496582 secs
Forêts réduites :
start_time <- Sys.time()
imp_res <- missForest(nhanes,
                      ntree = 10,
                      mtry = 2)
end_time <- Sys.time()
print(imp_res$OOBerror)
print(end_time - start_time)
      NRMSE         PFC
0.162420139 0.007425743
Time difference of 0.516367 secs
Passons à la pratique !
Gérer les données manquantes avec des imputations en R

