Imputation par la moyenne

Gérer les données manquantes avec des imputations en R

Michal Oleszak

Machine Learning Engineer

Vocabulaire de l'imputation

Imputation = estimer de façon informée les valeurs manquantes

  • Imputation par donneur : valeurs manquantes remplacées à partir d'autres observations complètes.
  • Imputation par modèle : valeurs manquantes prédites par un modèle statistique ou de machine learning.

Ce chapitre traite des méthodes par donneur :

  • Imputation par la moyenne
  • Imputation « hot-deck »
  • Imputation kNN
Gérer les données manquantes avec des imputations en R

Imputation par la moyenne

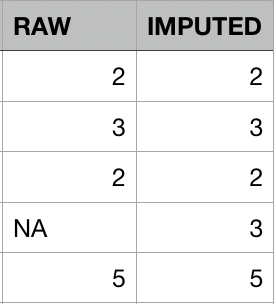
Un tableau à deux colonnes : données brutes avec une valeur manquante, et données imputées identiques mais avec cette valeur remplacée par la moyenne.

L'imputation par la moyenne fonctionne bien pour des séries chronologiques fluctuantes autour d'une moyenne de long terme.

Pour des données en coupe, c'est souvent un très mauvais choix :

  • Elle détruit les relations entre variables.
  • Aucune variance dans les valeurs imputées.
Gérer les données manquantes avec des imputations en R

Imputation par la moyenne : pratique

Tâche : imputer par la moyenne Height et Weight dans les données NHANES.

  • Créer des indicateurs binaires signalant si chaque valeur était manquante à l'origine.
nhanes <- nhanes %>% 
  mutate(Height_imp = ifelse(is.na(Height), TRUE, FALSE)) %>% 
  mutate(Weight_imp = ifelse(is.na(Weight), TRUE, FALSE))
  • Remplacer les valeurs manquantes de Height et Weight par leurs moyennes respectives.
nhanes_imp <- nhanes %>% 
  mutate(Height = ifelse(is.na(Height), mean(Height, na.rm = TRUE), Height)) %>% 
  mutate(Weight = ifelse(is.na(Weight), mean(Weight, na.rm = TRUE), Weight))
Gérer les données manquantes avec des imputations en R

Données NHANES imputées par la moyenne

nhanes_imp %>%
    select(Weight, Height, Height_imp, Weight_imp) %>%
    head()
     Weight   Height Height_imp Weight_imp
1  73.20000 166.2499       TRUE      FALSE
2  72.30000 166.2499       TRUE      FALSE
3  57.70000 158.9000      FALSE      FALSE
4  88.90000 183.3000      FALSE      FALSE
5  45.10000 157.6000      FALSE      FALSE
6  66.77065 158.4000      FALSE       TRUE
Gérer les données manquantes avec des imputations en R

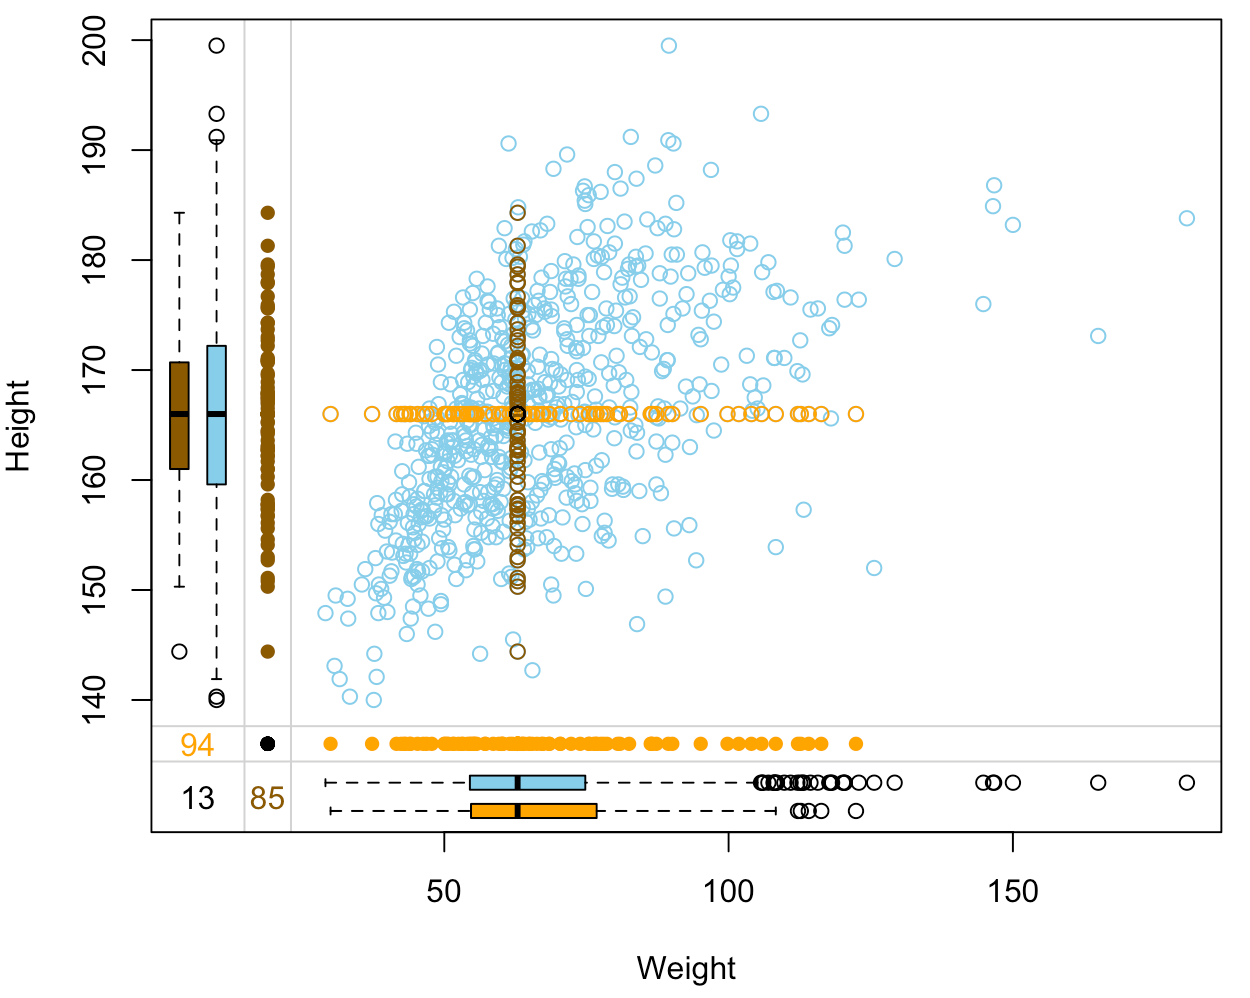
Évaluer la qualité : margin plot

nhanes_imp %>% select(Weight, Height, Height_imp, Weight_imp) %>% marginplot(delimiter="imp")
Un « margin plot » : nuage de points « Height » vs « Weight », où les valeurs imputées dans l'une ou l'autre variable sont mises en évidence par une couleur différente.

Gérer les données manquantes avec des imputations en R

Problèmes de l'imputation par la moyenne

Destruction des relations entre variables :

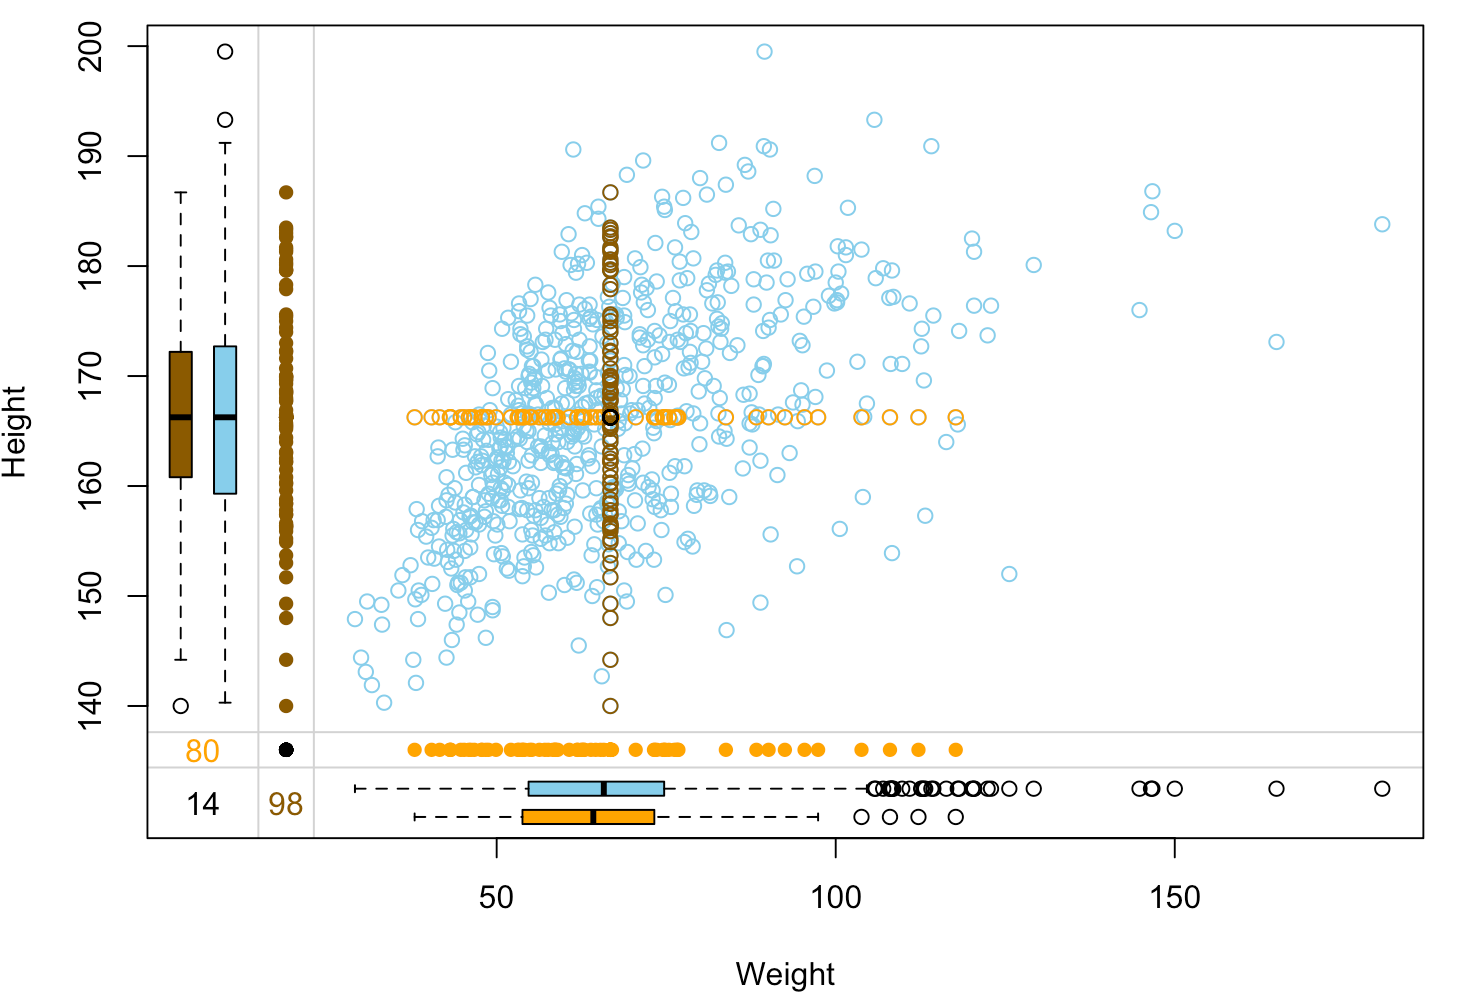
  • Après imputation moyenne de Height et Weight, leur corrélation positive est plus faible.
  • Les modèles prédictifs seront trompés par les valeurs imputées aberrantes et produiront des résultats biaisés.

Aucune variabilité dans les données imputées :

  • Avec moins de variance, toutes les erreurs standards seront sous-estimées, ce qui empêche des tests d'hypothèses fiables et le calcul d'intervalles de confiance.
Gérer les données manquantes avec des imputations en R

Imputation par la médiane et la mode

  • Au lieu de la moyenne, on peut imputer par la médiane ou la mode.
  • La médiane est préférable en présence de valeurs aberrantes.
  • Pour des variables catégorielles, on ne peut calculer ni moyenne ni médiane ; on utilise donc la mode.
  • Médiane et mode présentent les mêmes inconvénients que l'imputation par la moyenne.

Un « margin plot » : nuage de points « Height » vs « Weight », où les valeurs imputées dans l'une ou l'autre variable sont mises en évidence par une couleur différente.

Gérer les données manquantes avec des imputations en R

Passons à la pratique !

Gérer les données manquantes avec des imputations en R

Preparing Video For Download...