Imputation par k plus proches voisins (kNN)

Gérer les données manquantes avec des imputations en R

Michal Oleszak

Machine Learning Engineer

Imputation par k plus proches voisins (kNN)
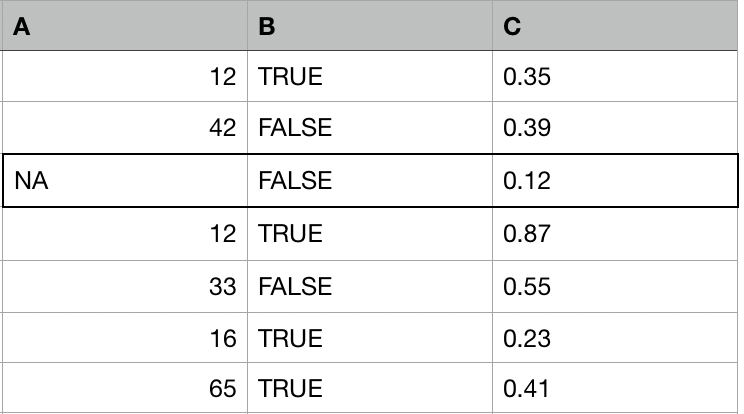
Un tableau avec trois colonnes : A, B et C. Il manque une valeur dans la colonne A.

Gérer les données manquantes avec des imputations en R

Imputation par k plus proches voisins (kNN)
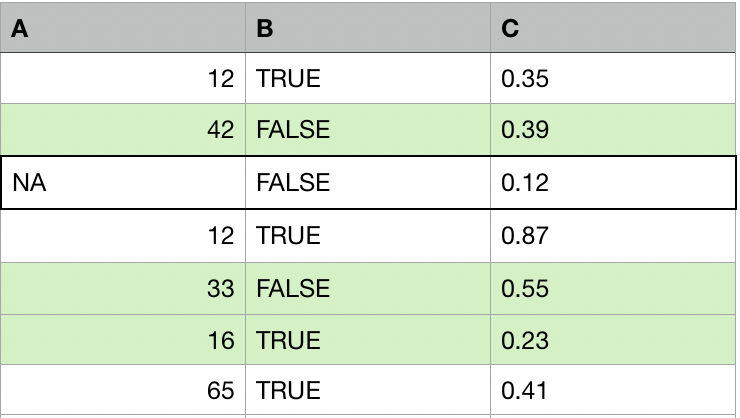
Un tableau avec trois colonnes : A, B et C. Il manque une valeur dans la colonne A. Trois lignes sans valeur manquante sont mises en évidence en couleur.

Pour chaque observation avec des valeurs manquantes :

  1. Trouver les k autres observations (donneurs, voisins) les plus similaires.
Gérer les données manquantes avec des imputations en R

Imputation par k plus proches voisins (kNN)
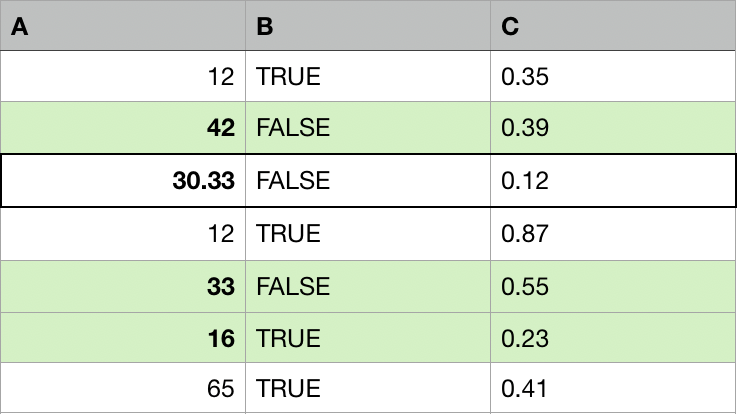
Un tableau avec trois colonnes : A, B et C. Trois lignes sans valeur manquante sont mises en évidence en couleur. La valeur manquante de A a été remplacée par la moyenne des nombres de la même colonne dans les lignes mises en évidence.

Pour chaque observation avec des valeurs manquantes :

  1. Trouver les k autres observations (donneurs, voisins) les plus similaires.
  2. Remplacer les valeurs manquantes par une agrégation des k donneurs (moyenne, médiane, mode).
Gérer les données manquantes avec des imputations en R

Mesures de distance

La distance entre deux observations a et b :

Distance euclidienne pour n variables numériques :

$\sqrt{\Sigma_{i=1}^{n} (a_i - b_i)^{2}}$

Distance de Manhattan pour f variables de type facteur :

$\Sigma_{i=1}^{f} |a_i - b_i|$

Distance de Hamming pour c variables catégorielles :

$\Sigma_{i=1}^{c} I(a_i \neq b_i)$

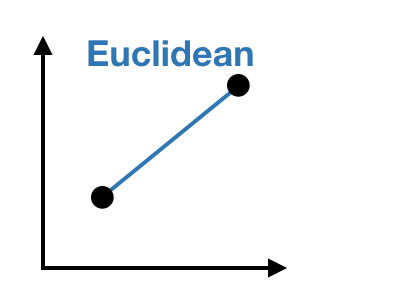
Un repère avec deux points reliés par une ligne droite.

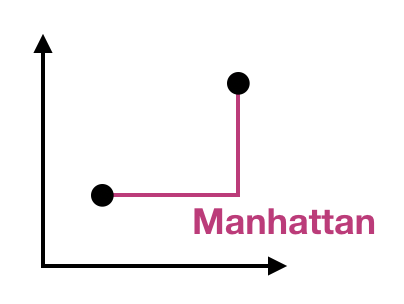
Un repère avec deux points reliés par deux segments perpendiculaires, comme deux coins opposés d'un rectangle.

Gérer les données manquantes avec des imputations en R

Distance de Gower

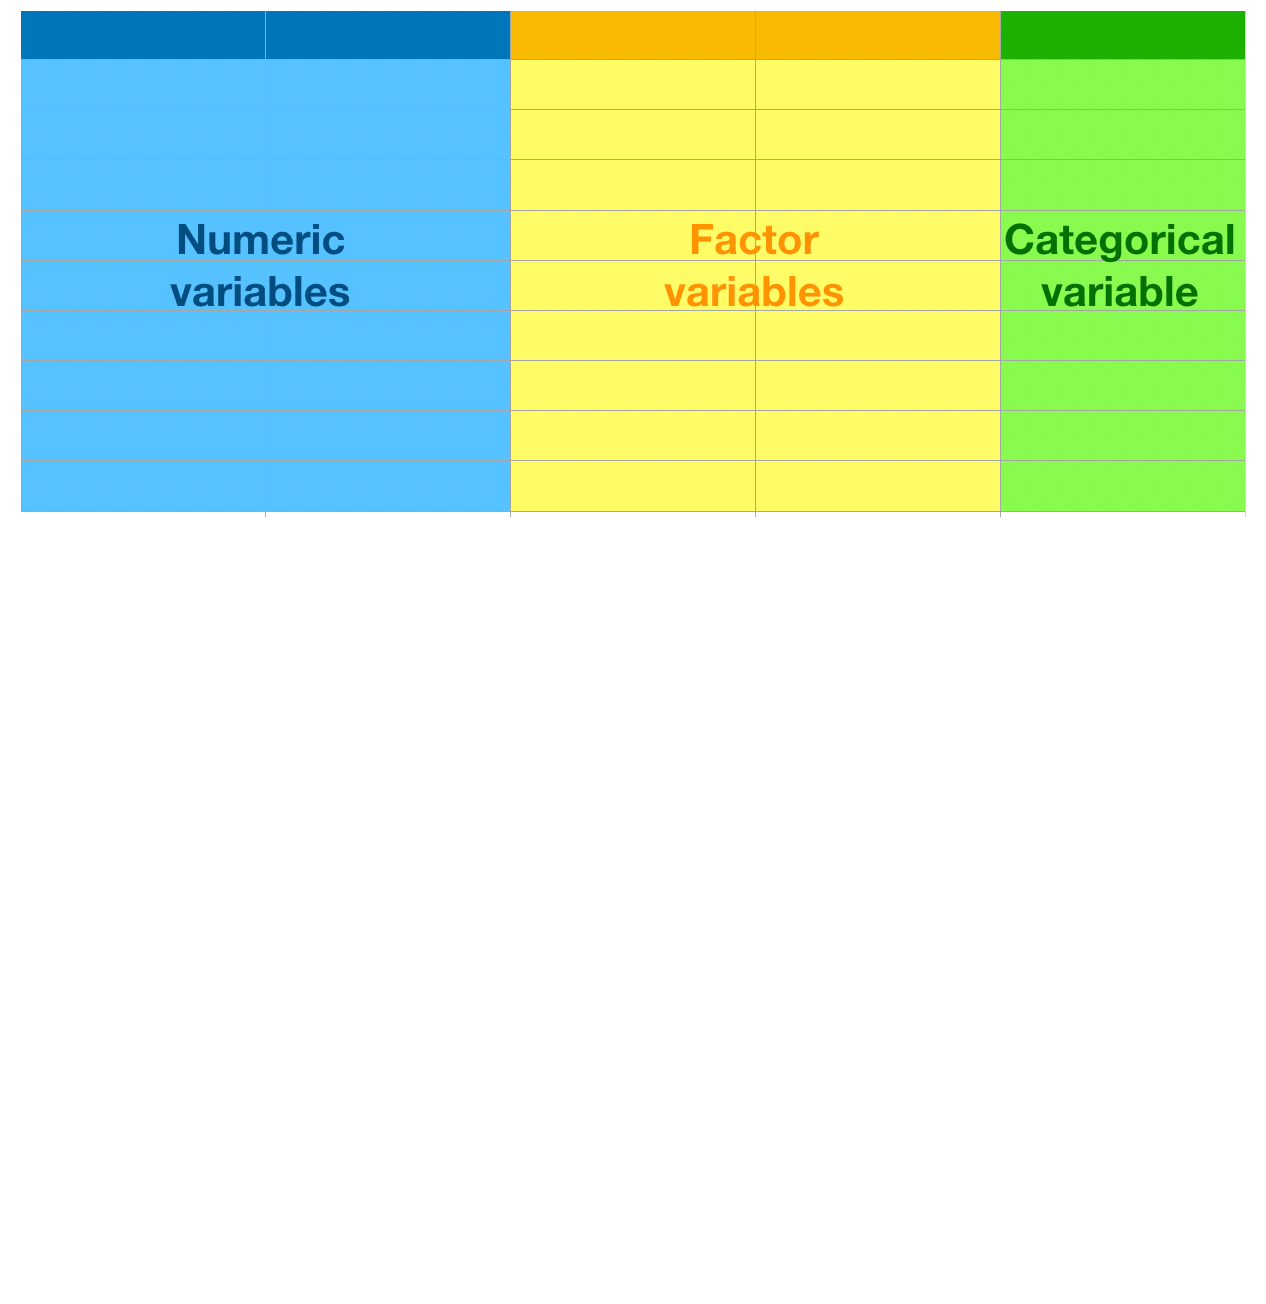
Un faux data frame contenant trois types de variables, chacune mise en évidence d'une couleur : numériques, facteurs et catégorielles.

Gérer les données manquantes avec des imputations en R

Distance de Gower

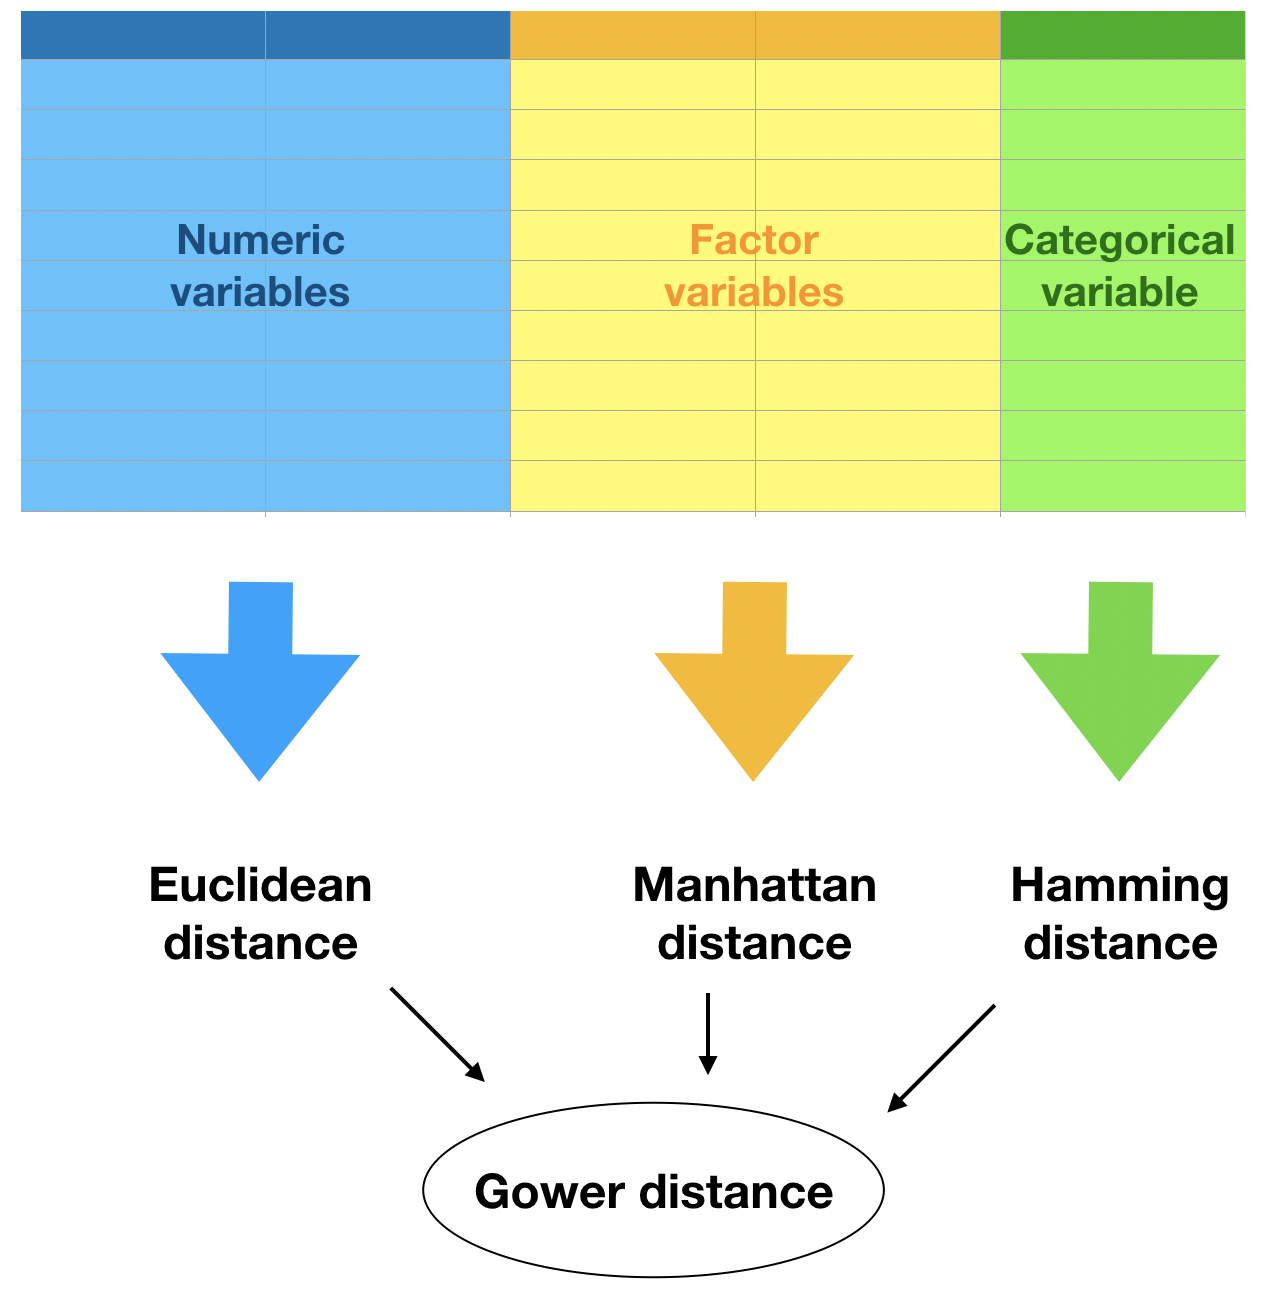
Un faux data frame contenant trois types de variables, chacune mise en évidence d'une couleur : numériques, facteurs et catégorielles. Chaque type pointe vers la mesure de distance correspondante : euclidienne, Manhattan et Hamming. Les trois mènent à une ellipse « Distance de Gower », combinaison des trois.

Gérer les données manquantes avec des imputations en R

Imputation kNN en pratique

library(VIM)
nhanes_imp <- kNN(nhanes, k = 5, variable = c("TotChol", "Pulse"))
head(nhanes_imp)
  Age Gender Weight Height Diabetes TotChol Pulse PhysActive TotChol_imp Pulse_imp
1  16   male   73.2  172.0    FALSE    3.00    76       TRUE       FALSE     FALSE
2  17   male   72.3  176.0    FALSE    2.61    74       TRUE       FALSE     FALSE
3  12   male   57.7  158.9    FALSE    4.27    80       TRUE       FALSE     FALSE
4  16   male   88.9  183.3    FALSE    3.62    58       TRUE       FALSE     FALSE
5  13 female   45.1  157.6    FALSE    2.66    92       TRUE       FALSE     FALSE
6  16 female   48.7  158.4    FALSE    4.32    58      FALSE       FALSE     FALSE
Gérer les données manquantes avec des imputations en R

Pondération des donneurs

  • Parmi les k voisins choisis pour une observation, certains sont plus proches que d'autres.
  • On peut vouloir donner plus de poids aux voisins les plus proches lors de l'agrégation.
  • Agrégerez les voisins avec une moyenne pondérée, pondérée par l'inverse des distances à chaque voisin.
  • Possible uniquement pour l'imputation de variables numériques.
nhanes_imp <- nhanes %>% 
  kNN(variable = c("TotChol", "Pulse"),
      k = 5,
      numFun = weighted.mean,
      weightDist = TRUE)
Gérer les données manquantes avec des imputations en R

Trier les variables

  • L'algorithme kNN parcourt les variables et les impute une à une.
  • Les distances entre observations sont recalculées à chaque fois.
  • Si la première variable a beaucoup de valeurs manquantes, le calcul des distances pour la seconde reposera sur de nombreuses valeurs imputées.
  • Il est recommandé de trier les variables par nombre de valeurs manquantes croissant avant d'exécuter kNN.
Gérer les données manquantes avec des imputations en R

Trier les variables en pratique

vars_by_NAs <- nhanes %>% 
  is.na() %>%
  colSums() %>%
  sort(decreasing = FALSE) %>% 
  names()
nhanes_imp <- nhanes %>% 
  select(vars_by_NAs) %>% 
  kNN(k = 5)
Gérer les données manquantes avec des imputations en R

Passons à la pratique avec l'imputation kNN !

Gérer les données manquantes avec des imputations en R

Preparing Video For Download...