Créer des jeux de données synthétiques avec scikit-learn

Confidentialité des données et anonymisation en Python

Rebeca Gonzalez

Data engineer

Générer des jeux de données avec scikit-learn

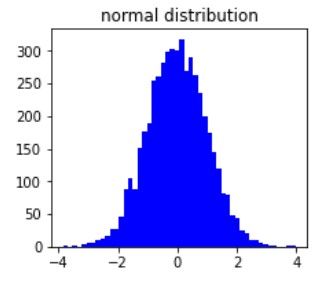
  • Nous pouvons créer des jeux de données échantillonnés à partir de lois de probabilité

  • Par exemple la loi normale

Représentation d'un histogramme suivant une loi normale

Confidentialité des données et anonymisation en Python

Loi normale

Souvent observée dans la nature

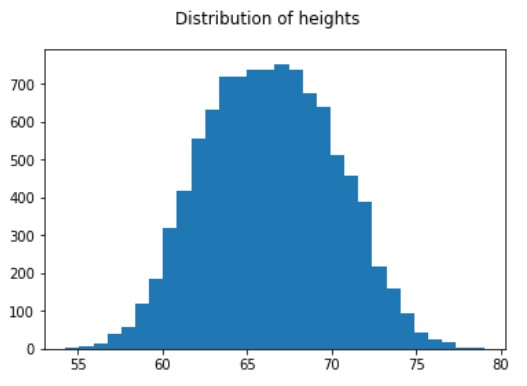
  • Tailles
  • Pression artérielle
  • QI

Histogramme des tailles d'un grand jeu de données suivant une loi normale

Confidentialité des données et anonymisation en Python

Échantillonner une loi normale

import numpy as np


# Créer un nouveau DataFrame pandas new_measures = pd.DataFrame()
# Sélectionner la moyenne/centre et l'écart type de l'échantillon mean = 65 standard_deviation = 2
# Générer l'échantillon new_measures['Height'] = np.random.normal(mean, standard_deviation, 10000)
Confidentialité des données et anonymisation en Python

Échantillonner une loi normale

# Tracer un histogramme pour voir la distribution des tailles obtenue
new_measures['Height'].hist(bins=50)
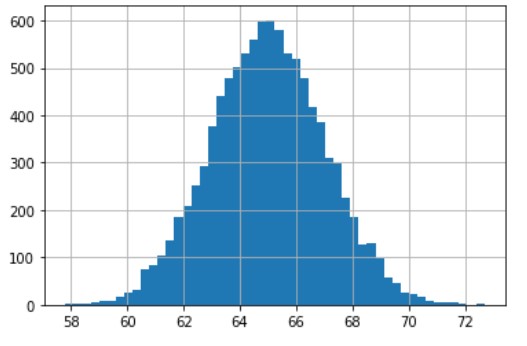
Histogramme des données obtenues

Confidentialité des données et anonymisation en Python

Créer des jeux de données avec scikit-learn

Scikit-learn propose des fonctions simples pour générer des jeux de données pour :

  • Classification
  • Regroupement (clustering)
  • Régression
Confidentialité des données et anonymisation en Python

Données synthétiques pour classification et clustering

make_classification()

  • Alloue des amas de points suivant une loi normale
  • Peut créer des variables corrélées et non informatives

make_blobs()

  • Contrôle plus fin des centres et écarts types des amas
Confidentialité des données et anonymisation en Python

Données synthétiques pour la classification
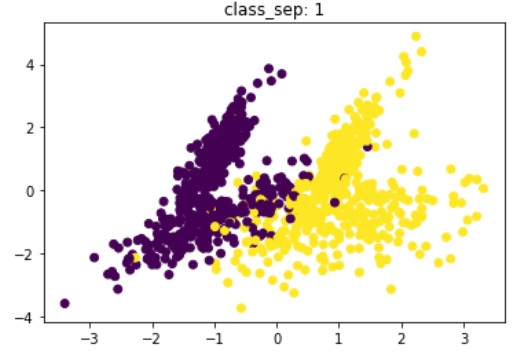
# Importer make_classification depuis le module datasets de sklearn
from sklearn.datasets import make_classification


# Générer les échantillons et leurs étiquettes x, y = make_classification(n_samples=1000,
n_classes=2,
n_informative=2,
n_features=4,
n_clusters_per_class=2,
class_sep=1)
Confidentialité des données et anonymisation en Python

Données synthétiques pour la classification
# Afficher les données et étiquettes générées
print(x.shape)
print(y.shape)
print(x)
(1000, 4)
(1000,)
[[ 1.22914870e+00 -2.62386795e+00  2.25878743e+00  2.55377055e+00]
 [-1.10279812e+00 -1.15816087e+00  1.55571279e+00  7.80565898e-02]
 [ 2.65581977e-03 -2.33278818e+00  2.37837858e+00  1.57533194e+00]
 ...
 [ 4.51006972e-01  7.53435745e-01 -9.21597108e-01 -2.20659747e-01]
 [ 5.31925876e-01  7.42210504e-01 -9.37625248e-01 -1.61488855e-01]
 [ 1.62862108e+00 -2.72435345e+00  2.22562940e+00  2.87628246e+00]]
Confidentialité des données et anonymisation en Python

Données synthétiques pour la classification

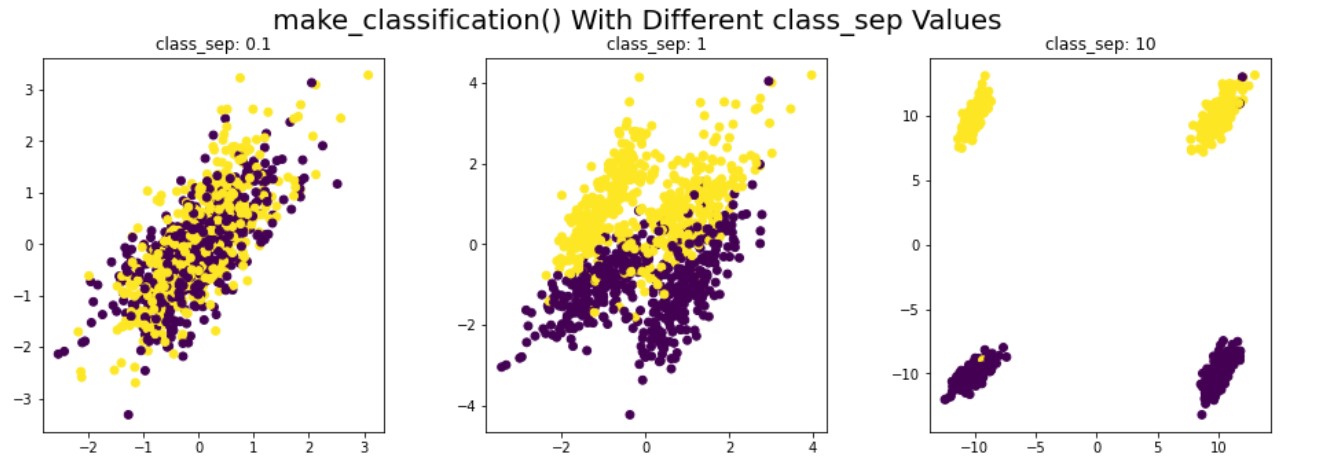
Nuage de points du jeu de données à 2 classes généré

Confidentialité des données et anonymisation en Python

Données synthétiques pour la classification

Trois graphiques montrant le jeu de données généré pour différentes valeurs de class_sep. À gauche, les points sont très proches ; à droite, ils sont très séparés.

Confidentialité des données et anonymisation en Python

Données synthétiques pour le clustering
# Importer le module datasets pour générer des jeux de données de clustering
from sklearn.datasets import make_blobs


# Spécifier une valeur d'écart type standard_deviation = 1.5
# Générer les données et les étiquettes du jeu de données x, labels = make_blobs(n_features=3, centers=4, cluster_std=standard_deviation)
# Afficher la forme des données générées print(x.shape)
(100, 3)
Confidentialité des données et anonymisation en Python

Données synthétiques pour le clustering
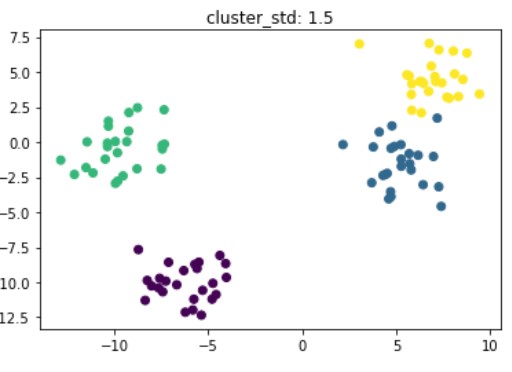
Nuage de points résultant du clustering, une couleur par amas. 4 centres pour 4 amas.

Confidentialité des données et anonymisation en Python

Données synthétiques pour le clustering

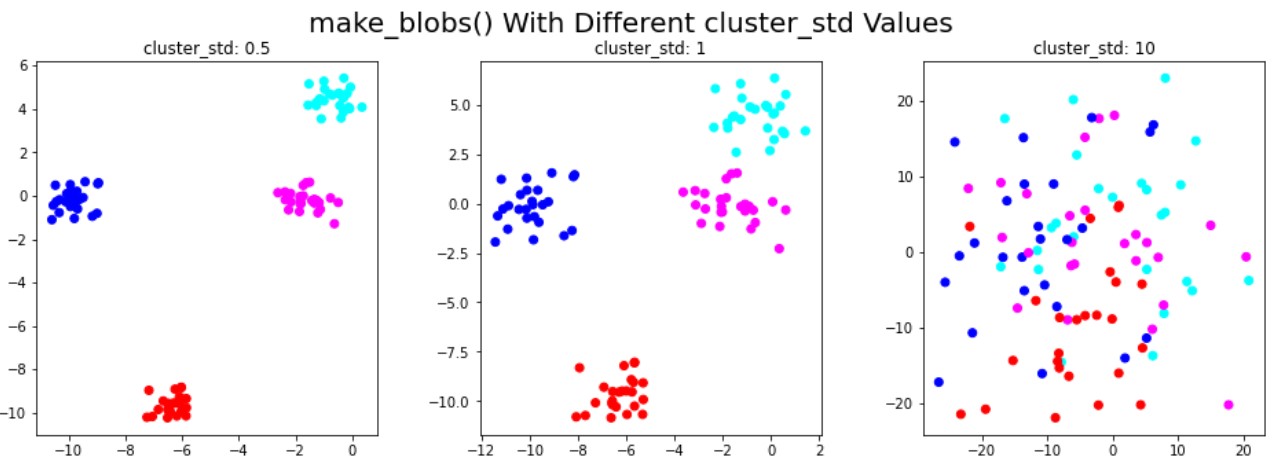
Trois graphiques illustrant l'effet de l'écart type sur les points générés. À gauche, des amas serrés autour du centre ; à droite, des points très dispersés.

Confidentialité des données et anonymisation en Python

Passons à la pratique !

Confidentialité des données et anonymisation en Python

Preparing Video For Download...