Clustering avec confidentialité différentielle

Confidentialité des données et anonymisation en Python

Rebeca Gonzalez

Data engineer

Comparer les modèles
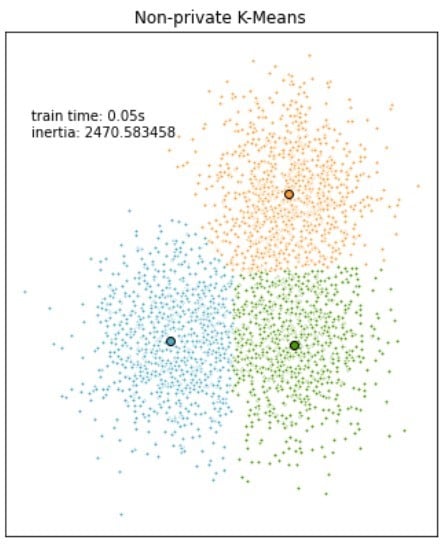
Image montrant 3 clusters dans les données après un k-means non privé

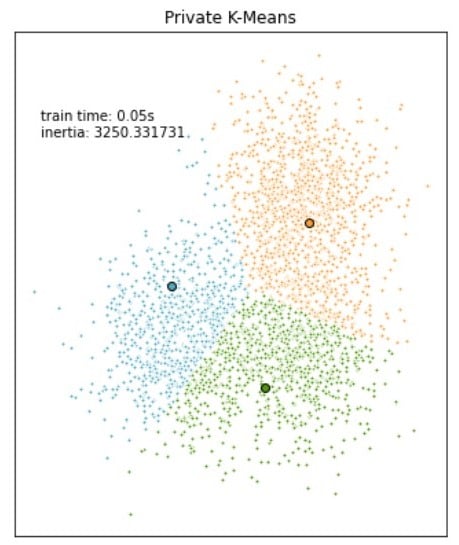
Image montrant 3 clusters dans les données après un k-means privé

Confidentialité des données et anonymisation en Python

Comparer les modèles

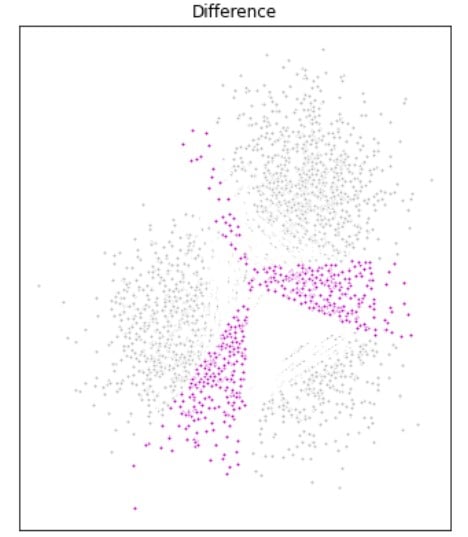
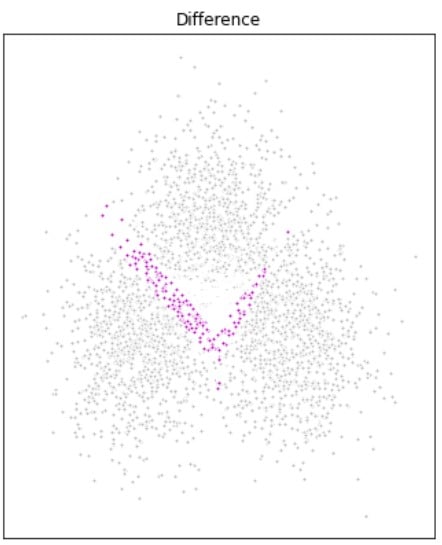
Image montrant la différence entre les deux segmentations, en points roses

  • Différences entre les clusters des modèles
  • La majorité des résultats est commune
Confidentialité des données et anonymisation en Python

Créer des modèles de clustering privés différentiels

from diffprivlib.models import KMeans

# Calculer les clusters avec le modèle DP model = KMeans(epsilon=1, n_clusters=3)
# Exécuter le modèle et obtenir les clusters clusters = model.fit_predict(X)
Confidentialité des données et anonymisation en Python

Améliorer les modèles DP de clustering
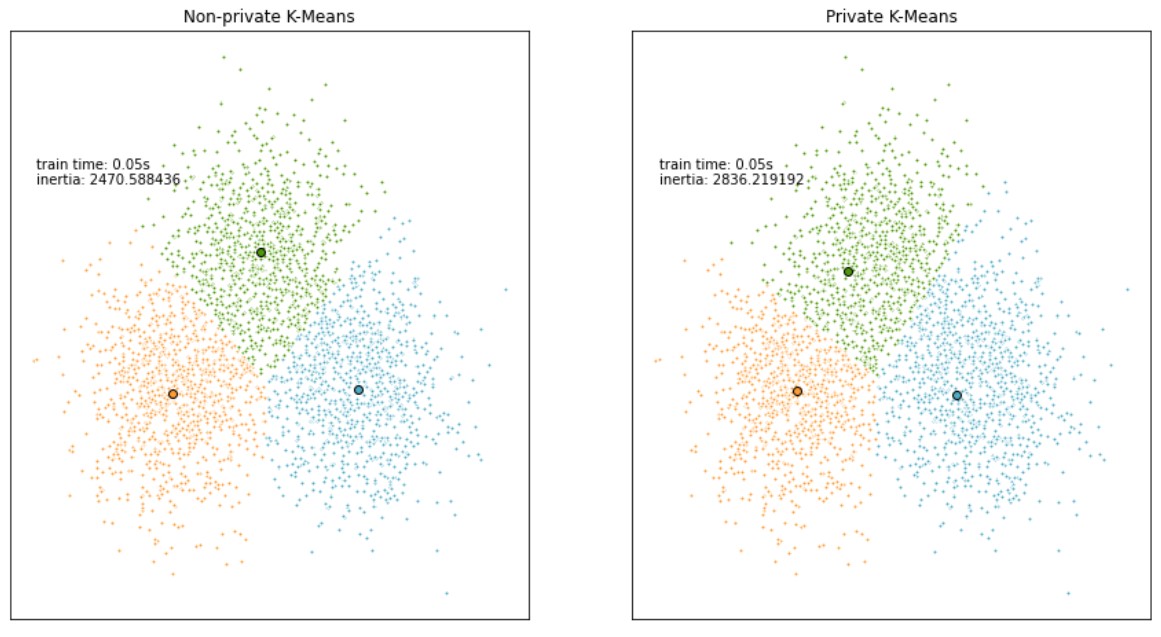
  • On peut prétraiter les données avant le clustering.
  • Mise à l'échelle des variables comme StandardScaler et réduction de dimension comme PCA.
    • Pour réduire l'inertie du modèle
    • Obtenir des segments plus précis
  • On le fait avec diffprivlib comme avec les modèles sklearn.
Confidentialité des données et anonymisation en Python

Améliorer les modèles DP de clustering
from sklearn.decomposition import PCA

# Initialiser PCA pca = PCA()
# Ajuster et transformer les données avec PCA X = pca.fit_transform(X)
# Calculer les clusters avec le modèle DP model = dp_Kmeans(epsilon=1, n_clusters=3)
# Exécuter le modèle et obtenir les clusters clusters = model.fit_predict(X)
Confidentialité des données et anonymisation en Python

Améliorer les modèles DP de clustering

Image montrant deux nuages de points résultants avec les clusters

Confidentialité des données et anonymisation en Python

Améliorer les modèles DP de clustering

Image montrant la différence entre les deux segmentations, en points roses

  • Résultats améliorés grâce aux transformations des données
Confidentialité des données et anonymisation en Python

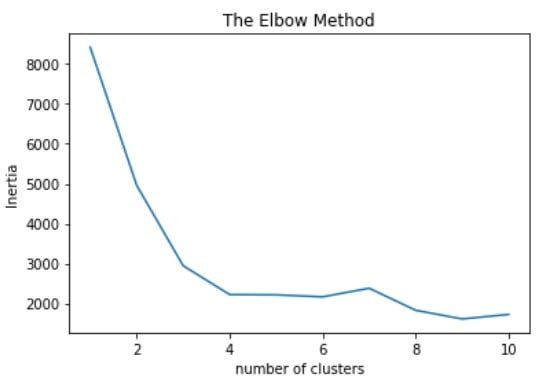
Méthode du coude

Image du tracé obtenu après application de la méthode du coude

Confidentialité des données et anonymisation en Python

Epsilon

from diffprivlib.models import KMeans as model

# Calculer les clusters avec le modèle DP model = dp_Kmeans(epsilon=0.2, n_clusters=3)
# Exécuter le modèle et obtenir les clusters clusters = model.fit_predict(X)
Confidentialité des données et anonymisation en Python

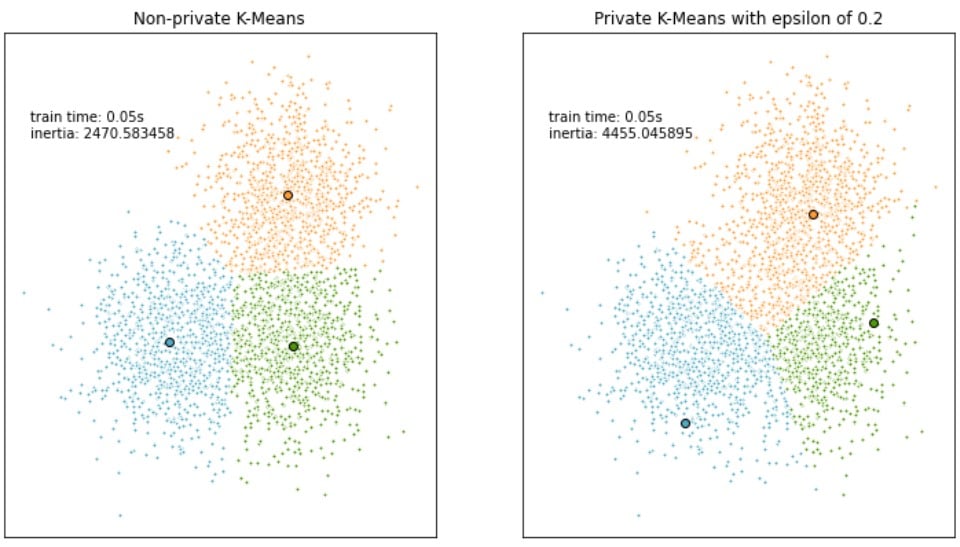
Epsilon

Image montrant deux nuages de points résultants avec les clusters

Confidentialité des données et anonymisation en Python

Passons à la pratique !

Confidentialité des données et anonymisation en Python

Preparing Video For Download...