Introduction à la k-anonymité

Confidentialité des données et anonymisation en Python

Rebeca Gonzalez

Data engineer

Pourquoi la k-anonymité est-elle importante ?
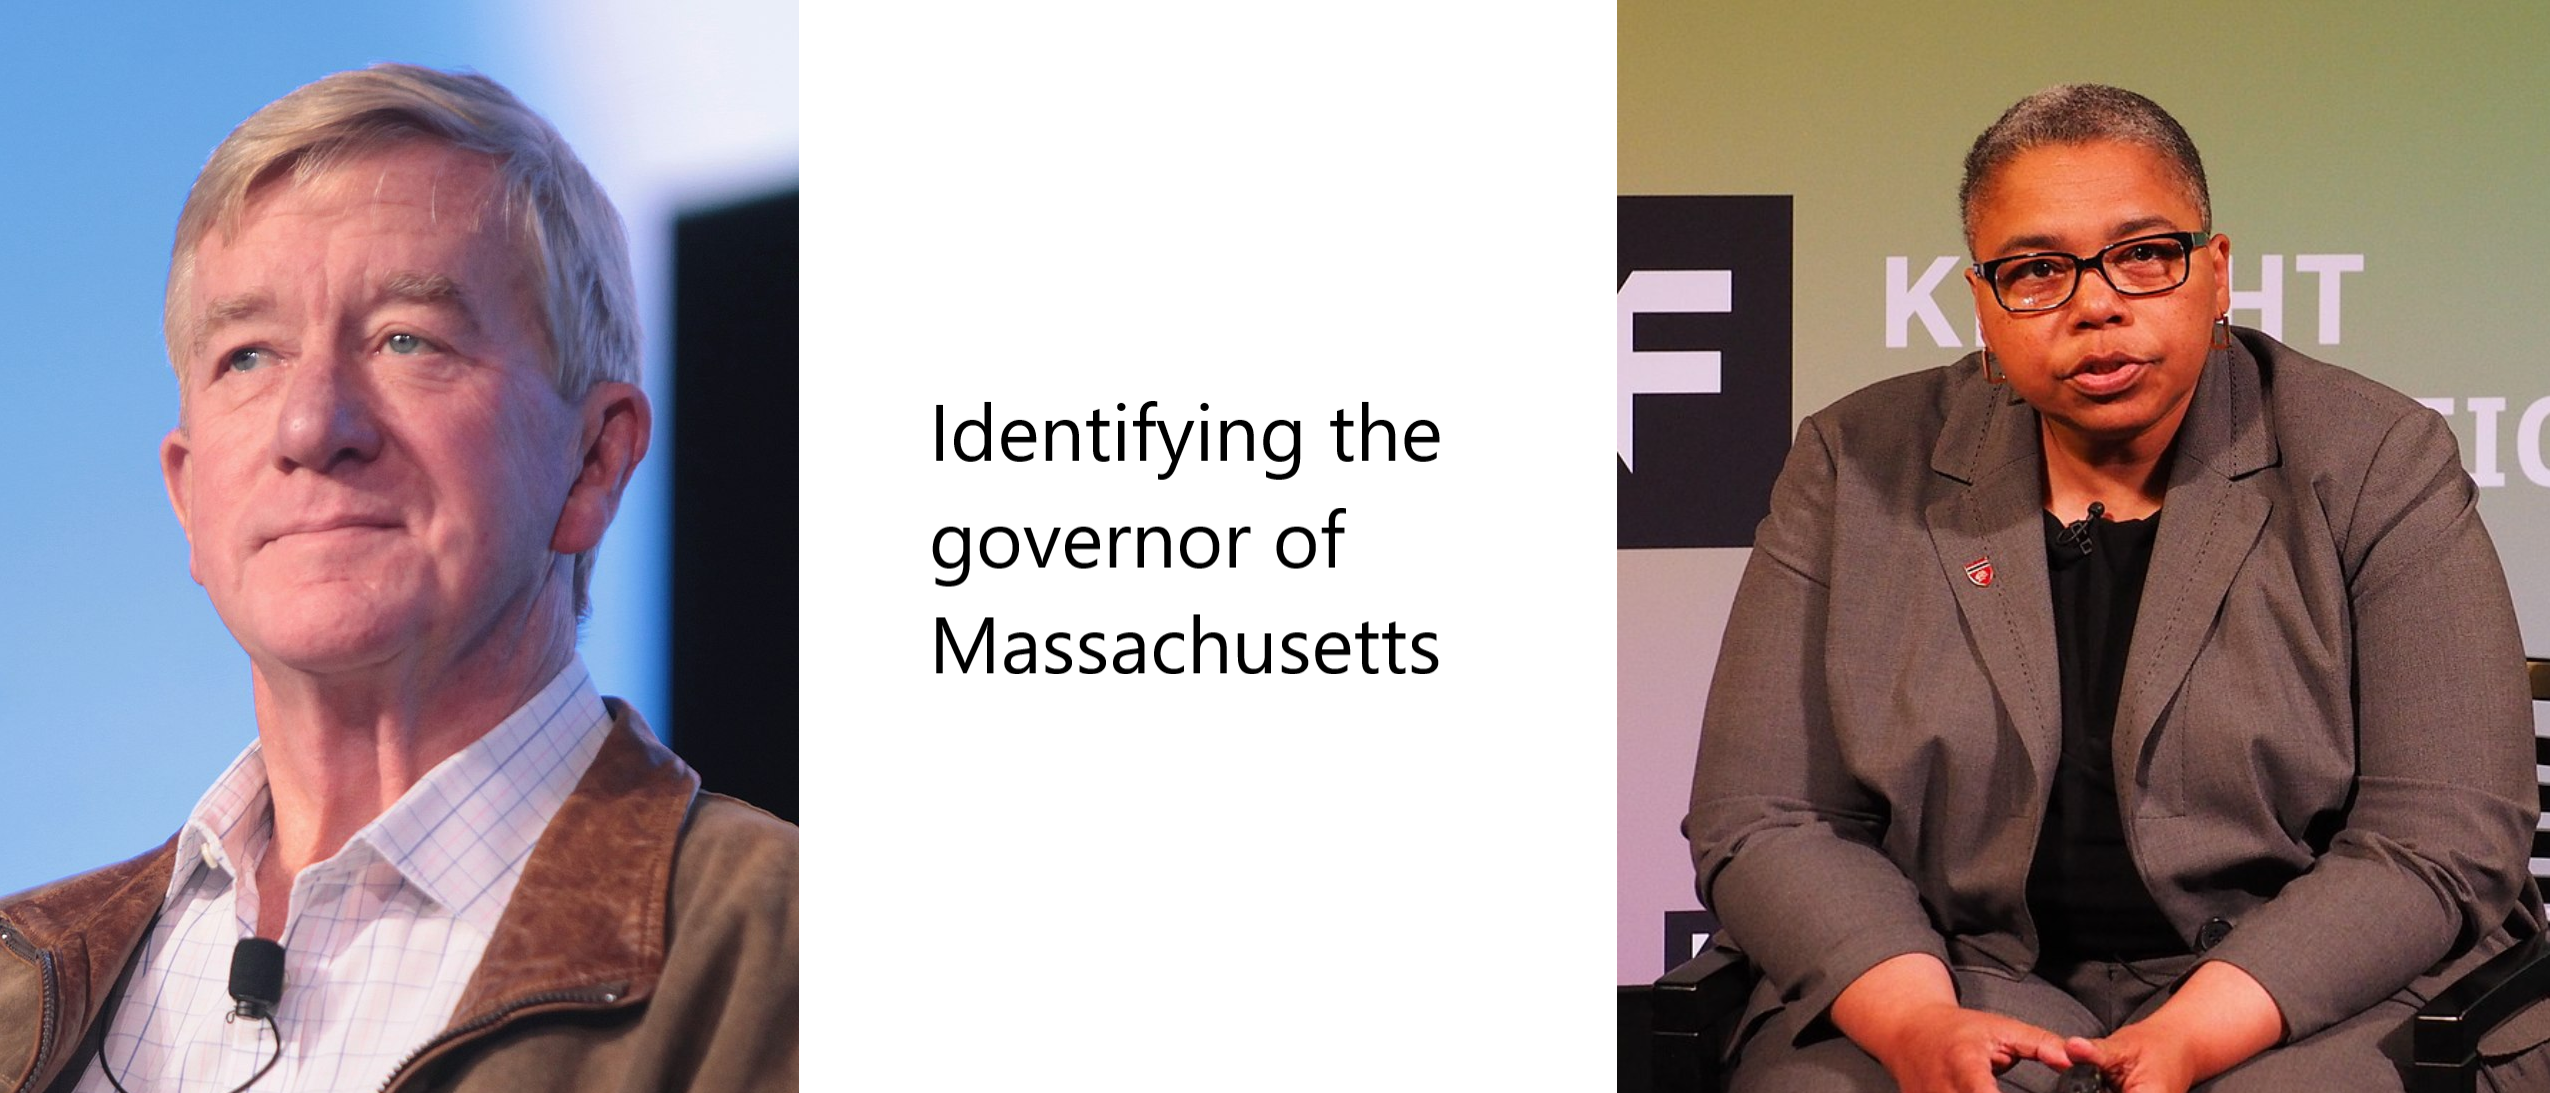
Image présentant le gouverneur du Massachusetts à gauche, le texte « Identifier le gouverneur du Massachusetts » et la professeure de Harvard Latanya Sweeney à droite

Confidentialité des données et anonymisation en Python

Pourquoi est-ce important ?

  • Six personnes avaient sa date de naissance
  • Seulement trois étaient des hommes
  • Il était le seul dans son code postal

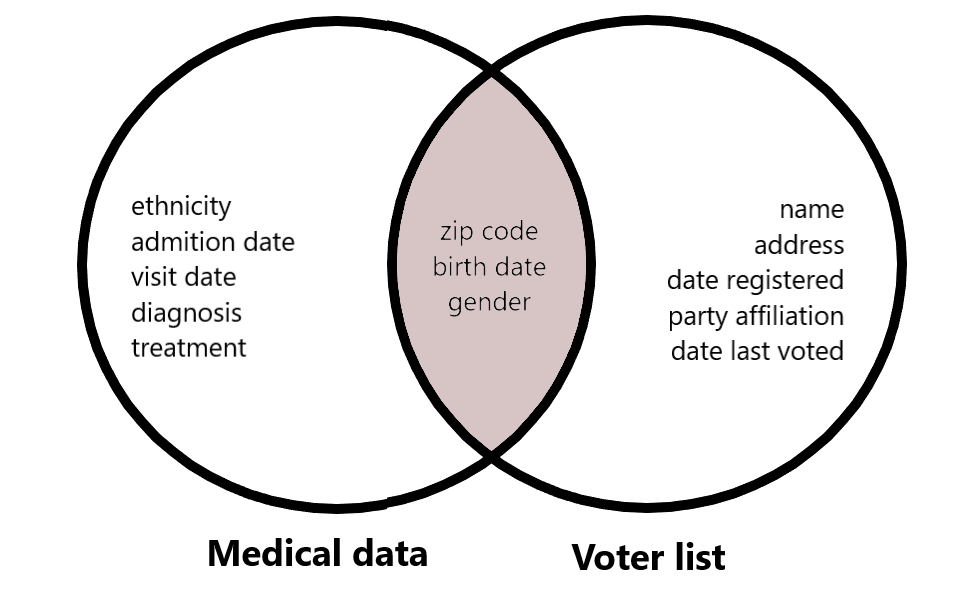
Schéma montrant l'intersection de deux jeux de données : données médicales et liste d'électeurs, dont l'intersection est le code postal, la date de naissance et le genre

Confidentialité des données et anonymisation en Python

Comment éviter cette attaque ?

Un seul enregistrement avait les valeurs démographiques du gouverneur.

Supprimer toutes les données démographiques rendrait l'analyse inutile.

Et s'il existait un juste milieu pour que ces valeurs ne soient plus uniques dans le jeu de données ?

Confidentialité des données et anonymisation en Python

Définition de la k-anonymité

$$ $$ $$ $$ $$ $$ Au moins k individus du jeu de données partagent l'ensemble d'attributs susceptibles d'identifier chaque personne.

Confidentialité des données et anonymisation en Python

Définition de la k-anonymité

Un grand groupe de personnes traversant une rue

Confidentialité des données et anonymisation en Python

Jeu de données k-anonyme

2-anonyme :

     ZIP code    Age
0    4217        34
1    4217        34
2    1742        77
3    1742        77

Chaque combinaison de valeurs pour les colonnes identifiantes apparaît au moins k fois dans le jeu de données.

Non 2-anonyme :

     ZIP code    Age
0    4217        34
1    4217        34
2    1742        77
3    1743        77
Confidentialité des données et anonymisation en Python

K-anonymité : terminologie

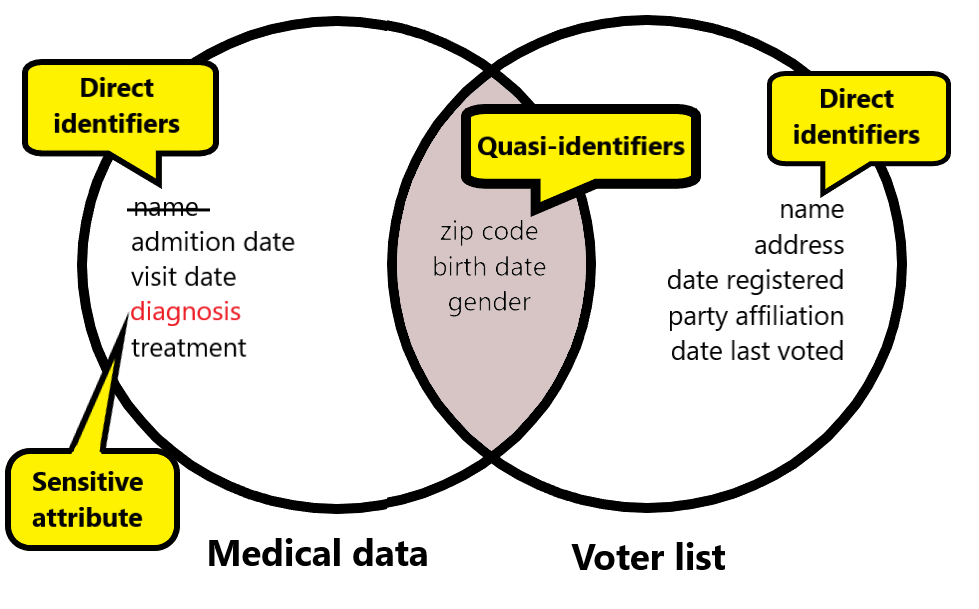
Schéma présentant les notions d'identifiants directs, quasi-identifiants et attributs sensibles

Confidentialité des données et anonymisation en Python

Jeu de données médical

# Explore DataFrame 
medical_df.head()
    Age    Department   Condition
0    34    Marketing    Anxiety disorders
1    46    Finance      Flu
2    41    Finance      Flu
3    62    Marketing    Anxiety disorders
4    44    Marketing    Anxiety disorders
Confidentialité des données et anonymisation en Python

Attributs de confidentialité

Attributs de confidentialité :

  • Identifiants : par exemple SSN et numéros d'ID.
  • Quasi-identifiants : âge et service dans notre jeu de données
  • Sensibles : pathologie médicale dans notre jeu de données
Confidentialité des données et anonymisation en Python

Explorer les combinaisons uniques de quasi-identifiants

# Calculate how many unique combinations are for Age and Department
medical_df.groupby(['Age','Department']).size().reset_index(name='Count')
    Age    Department    Count
0    30    Production    2
1    31    Marketing     1
2    32    Marketing     1
3    32    Production    1
4    33    Production    1
5    34    Finance       1
6    34    Marketing     1
7    34    Production    1
8    35    Marketing     1
9    36    Finance       2
10    38    Finance      1
11    38    Production   1
Confidentialité des données et anonymisation en Python

Approche : généralisation

# Generalize Age by creating 4 groups of intervals
medical_df['Age_group'] = pd.cut(medical_df['Age'], bins=4)


# Explore the dataset with intervals medical_df.head()
    Age    Department    Condition            Age_group
0    34    Marketing     Anxiety disorders    (29.964, 39.0]
1    46    Finance       Flu                  (39.0, 48.0]
2    41    Finance       Flu                  (39.0, 48.0]
3    62    Marketing     Anxiety disorders    (57.0, 66.0]
4    44    Marketing     Anxiety disorders    (39.0, 48.0]
Confidentialité des données et anonymisation en Python

Approche : généralisation

# Calculate how many unique combinations are for Age and Department
medical_df.groupby(['Age_group','Department']).size().reset_index(name='Count')
     Age_group         Department    Count
0    (29.964, 39.0]    Finance       4
1    (29.964, 39.0]    Marketing     4
2    (29.964, 39.0]    Production    6
3    (39.0, 48.0]      Finance       8
4    (39.0, 48.0]      Marketing     5
5    (39.0, 48.0]      Production    4
6    (48.0, 57.0]      Finance       3
7    (48.0, 57.0]      Marketing     2
8    (48.0, 57.0]      Production    4
Confidentialité des données et anonymisation en Python

Approche : généralisation

# Set k to be 2, for a 2-anonymous dataset
k = 2


# Calculate how many unique combinations are for Age and Department df_count = medical_df.groupby(['Age_group','Department']).size().reset_index(name='Count')
# Filter the rows that have count less than k df_count[df_count['Count'] < k]
    Age_group    Department    Count
Confidentialité des données et anonymisation en Python

Lançons la k-anonymisation !

Confidentialité des données et anonymisation en Python

Preparing Video For Download...