Anonymisation par généralisation des données

Confidentialité des données et anonymisation en Python

Rebeca Gonzalez

Data engineer

Généralisation des données

Technique permettant de remplacer des valeurs par d'autres, moins précises.

Objectif : supprimer certains identifiants tout en conservant l'utilité analytique.

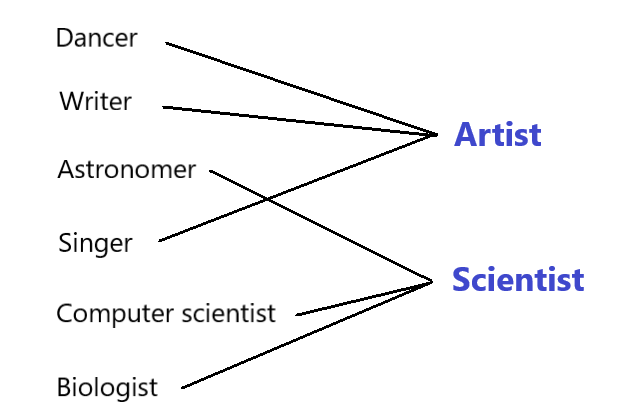
Permet de remplacer une valeur par une plus générale : « Dancer » -> « Artist »

     name               location
0    Amanda Hooper      146 Rodgers Field\nGregoryview, MS 71630
1    Sarah Smith        817 Garcia Shoal\nJonesville, AR 30299
2    Sean Boyd III      1938 90th St\nDallas, TX 59715
     name               location
0    Amanda Hooper      998 Boone Estate\nReedborough, MS 71630
1    Sarah Smith        7255 Shelby Rapids Apt. 455\nKarenland, AK 30299
2    Sean Boyd III      791 Crist Parks\nGreenton, TX 59715
Confidentialité des données et anonymisation en Python

Généralisation des données

# Données d'origine
df_employees.head()
     first name   last name    age   ssn
0    Amber        Brown        91    798-29-4785
1    William      Gibson       34    431-66-8381
2    Daniel       Lee          92    825-91-5550
3    Andrea       Stevenson    64    188-59-3544
4    Julie        Horn         35    020-60-6388
# Données généralisées : âge en intervalles et SSN masqué
generalized_df.head()
    First name    Last name    Age        SSN
0    Amber        Brown        (80, 99]    798-**-****
1    William      Gibson       (30, 50]    431-**-****
2    Daniel       Lee          (80, 99]    825-**-****
3    Andrea       Stevenson    (60, 80]    188-**-****
4    Julie        Horn         (30, 50]    020-**-****

Les personnes de 34 ans sont placées dans la tranche 30–50. On appelle cela le « binning ».

Confidentialité des données et anonymisation en Python

Agrégation des données

Image montrant, à gauche, une liste de métiers, et à droite, leurs grandes catégories.

Confidentialité des données et anonymisation en Python

Jeu de données médical

# Explorer le jeu de données
df_medical.head()
    age    gender    department    condition
0    30    F         Finance       Anxiety disorders
1    42    M         Production    Bronchitis
2    35    F         Marketing     Dysthymia
3    39    F         Production    Dysthymia
4    40    M         Marketing     Flu
Confidentialité des données et anonymisation en Python

Jeu de données médical

# Explorer l'histogramme de la variable age
df_medical['age'].hist(bins=15)
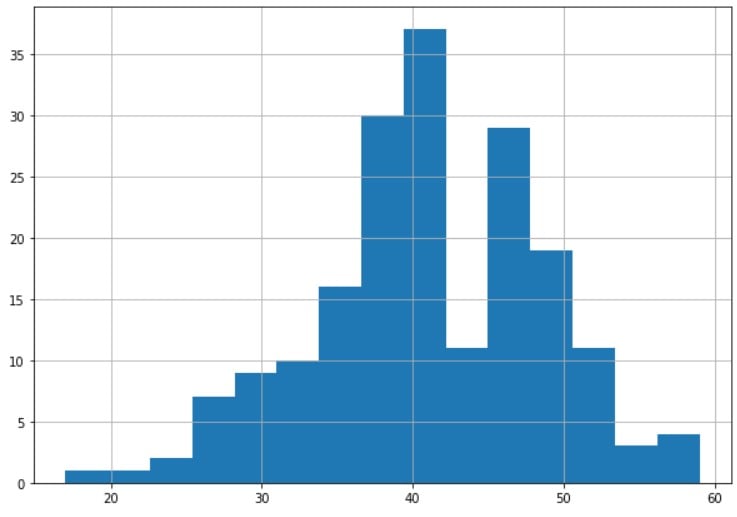
Histogramme généré de l'attribut age du jeu de données, produit avec la méthode hist

Confidentialité des données et anonymisation en Python

Généralisation

# Appliquer la généralisation en binaire
df_medical['age'] = df_medical['age'].apply(lambda x:">=40" if x>=40 else "<40" )


# Voir les résultats df_medical.head()
    age    gender    department    condition
0    <40   F         Finance       Bronchitis
1    >=40  M         Production    Bronquitis
2    <40   F         Finance       Dysthymia
3    <40   F         Production    Dysthymia
4    >=40  M         Marketing     Flu
Confidentialité des données et anonymisation en Python

Top et bottom coding

# Explorer l'histogramme de la variable age
df_medical['age'].hist(bins=15)
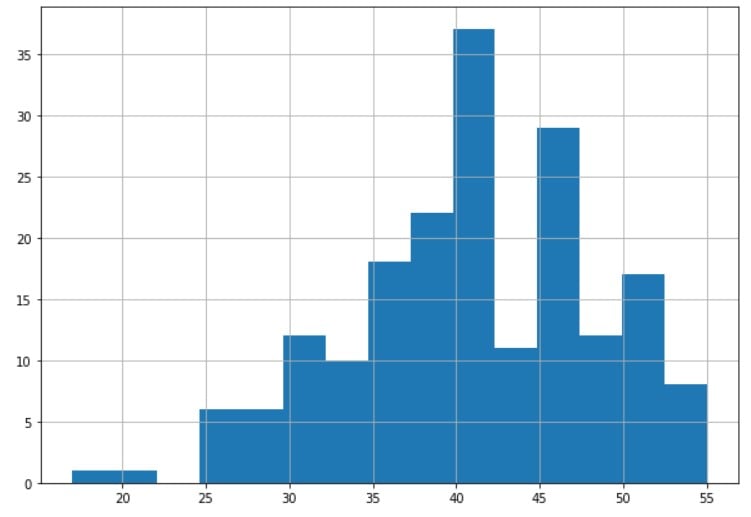
Histogramme généré de l'attribut age du jeu de données, produit avec la méthode hist

  • Peu de personnes ont moins de 25 ans, et peu ont plus de 55 ans
  • Appliquer des bornes pour réduire le risque de ré-identification de ces valeurs extrêmes
  • Utile quand une catégorie contient très peu d'observations, surtout en queue de distribution
Confidentialité des données et anonymisation en Python

Top coding

# Filtrer pour voir les lignes concernées
df_medical[df_medical['age'] >= 55]
      age   gender   department     condition
26    56    F        Production     Flu
65    55    M        Finance        Dysthymia
126   59    F        Production     Anxiety disorders
139   58    F        Finance        Dysthymia
142   59    M        Marketing      Flu
145   57    M        Marketing      Anxiety disorders
Confidentialité des données et anonymisation en Python

Top coding

# Appliquer le top coding à 55
df_medical.loc[df_medical['age'] > 55, 'age'] = 55


# Filtrer pour voir les lignes concernées df_medical[df_medical['age'] >= 55]
      age   gender   department     condition
26    55    F        Production     Flu
65    55    M        Finance        Dysthymia
126   55    F        Production     Anxiety disorders
139   55    F        Finance        Dysthymia
142   55    M        Marketing      Flu
145   55    M        Marketing      Anxiety disorders
Confidentialité des données et anonymisation en Python

Bottom coding

# Explorer l'histogramme de la variable age
df_medical['age'].hist(bins=15)
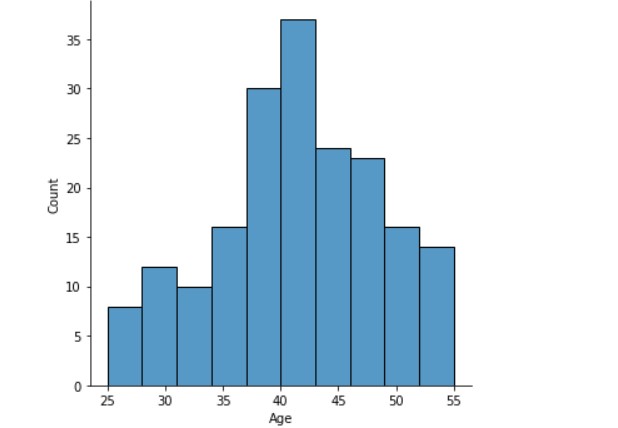
Histogramme obtenu de l'attribut age après top coding : plus d'extrêmes à droite (valeurs les plus élevées)

Confidentialité des données et anonymisation en Python

Bottom coding

# Appliquer le bottom coding à 25
df_medical.loc[df['age'] < 25, 'age'] = 25


# Explorer l'histogramme de la variable age df_medical['age'].hist(bins=15)

Histogramme obtenu de l'attribut age après top et bottom coding : plus d'extrêmes

Confidentialité des données et anonymisation en Python

Généralisation et modèles de confidentialité

Plus efficace avec la suppression et le masquage selon un modèle de confidentialité comme la K-anonymity.

Définir des conditions que le jeu de données doit respecter pour maîtriser le risque de divulgation.

Nous verrons comment implémenter ce modèle au chapitre suivant !

Confidentialité des données et anonymisation en Python

Passons à la pratique !

Confidentialité des données et anonymisation en Python

Preparing Video For Download...