Introduction et motivation

Détection de fraude en R

Bart Baesens

Professor Data Science at KU Leuven

Intervenants
picture_Bart.png

Détection de fraude en R

Intervenants

picture_BartTim.png

Détection de fraude en R

Intervenants

picture_BartTimSebastiaan.png

Détection de fraude en R

Qu'est-ce que la fraude ?

La fraude est un crime rare, réfléchi, subtilement dissimulé, évolutif dans le temps et souvent soigneusement organisé, qui prend de nombreuses formes.
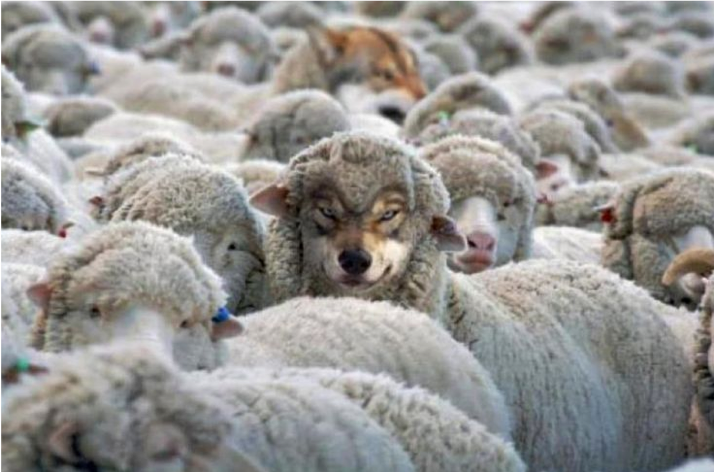
loup déguisé en mouton

Détection de fraude en R

Impact de la fraude

  • La fraude est très rare, mais le coût de sa non-détection peut être énorme !
  • Exemples :
    • Les organisations perdent 5 % de leurs revenus annuels à cause de la fraude
    • L'argent perdu par les entreprises > 3,5 billions $ chaque année
    • Les sociétés de cartes bancaires perdent environ 7 cents par 100 $ de transactions
    • La fraude représente 5 à 10 % des sinistres IARD payés
Détection de fraude en R

Types de fraude

  • Lutte contre le blanchiment
  • Fraude aux chèques
  • Fraude à la carte bancaire
  • Fraude douanière
  • Contrefaçon
  • Usurpation d'identité
  • Fraude à l'assurance
  • Fraude hypothécaire
  • Fraude à la non-livraison
  • Fraude en ligne
  • Fraude à la garantie produit
  • Évasion fiscale
  • Fraude aux télécommunications
  • Vol de stock
  • Fraude aux billets
  • Fraude dans les transports
  • Fraude par virement
  • Fraude à l'indemnisation des travailleurs
Détection de fraude en R

Caractéristiques clés des modèles d'analyse de fraude performants
  • Précision statistique

robin des bois

Détection de fraude en R

Caractéristiques clés des modèles d'analyse de fraude performants
  • Précision statistique
  • Interprétabilité

minority report

Détection de fraude en R

Caractéristiques clés des modèles d'analyse de fraude performants
  • Précision statistique
  • Interprétabilité
  • Conformité réglementaire

réglementaire

Détection de fraude en R

Caractéristiques clés des modèles d'analyse de fraude performants
  • Précision statistique
  • Interprétabilité
  • Conformité réglementaire
  • Impact économique

dagobert

Détection de fraude en R

Caractéristiques clés des modèles d'analyse de fraude performants
  • Précision statistique
  • Interprétabilité
  • Conformité réglementaire
  • Coût économique
  • Compléter l'expertise métier par des techniques data-driven

homme-machine

Détection de fraude en R

Défis d'un modèle de détection de fraude
  • Déséquilibre
    • p. ex. : en fraude carte bancaire, < 0,5 %

botte de foin

Détection de fraude en R

Défis d'un modèle de détection de fraude
  • Déséquilibre
    • p. ex. : en fraude carte bancaire, < 0,5 %
  • Efficacité opérationnelle
    • p. ex. : en fraude carte bancaire, décision en < 8 s

flash

Détection de fraude en R

Défis d'un modèle de détection de fraude
  • Déséquilibre
    • p. ex. : en fraude carte bancaire, < 0,5 %
  • Efficacité opérationnelle
    • p. ex. : en fraude carte bancaire, décision en < 8 s
  • Éviter de harceler les bons clients

bon client

Détection de fraude en R

Données déséquilibrées

  • Après une violente tempête, une compagnie d'assurance reçoit de nombreux sinistres

    • Les sinistres frauduleux sont étiquetés 1 et les légitimes 0
  • Le pourcentage de fraudes se calcule avec

    • table() et prop.table()
  • prop.table(table(...)) pour déterminer la proportion de fraude

prop.table(table(fraud_label))
     0      1
0.9911 0.0089
Détection de fraude en R

Visualiser le déséquilibre avec un camembert

labels <- c("no fraud", "fraud")
labels <- paste(labels, round(100 * prop.table(table(fraud_label)), 2), "%")
pie(table(fraud_label), labels, col = c("blue", "red"),
      main = "Pie chart of storm claims")
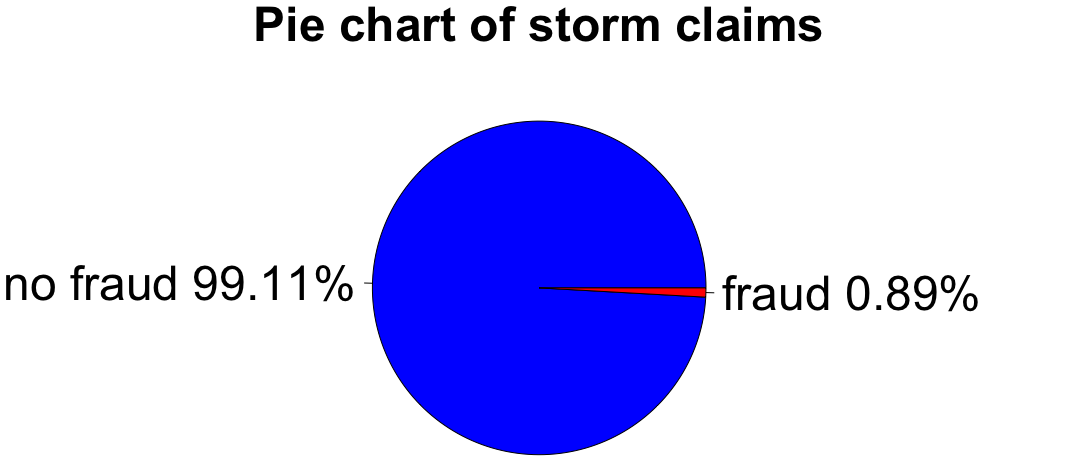
sinistres tempête

Détection de fraude en R

Matrice de confusion

Utilisée pour évaluer un modèle de détection de fraude :
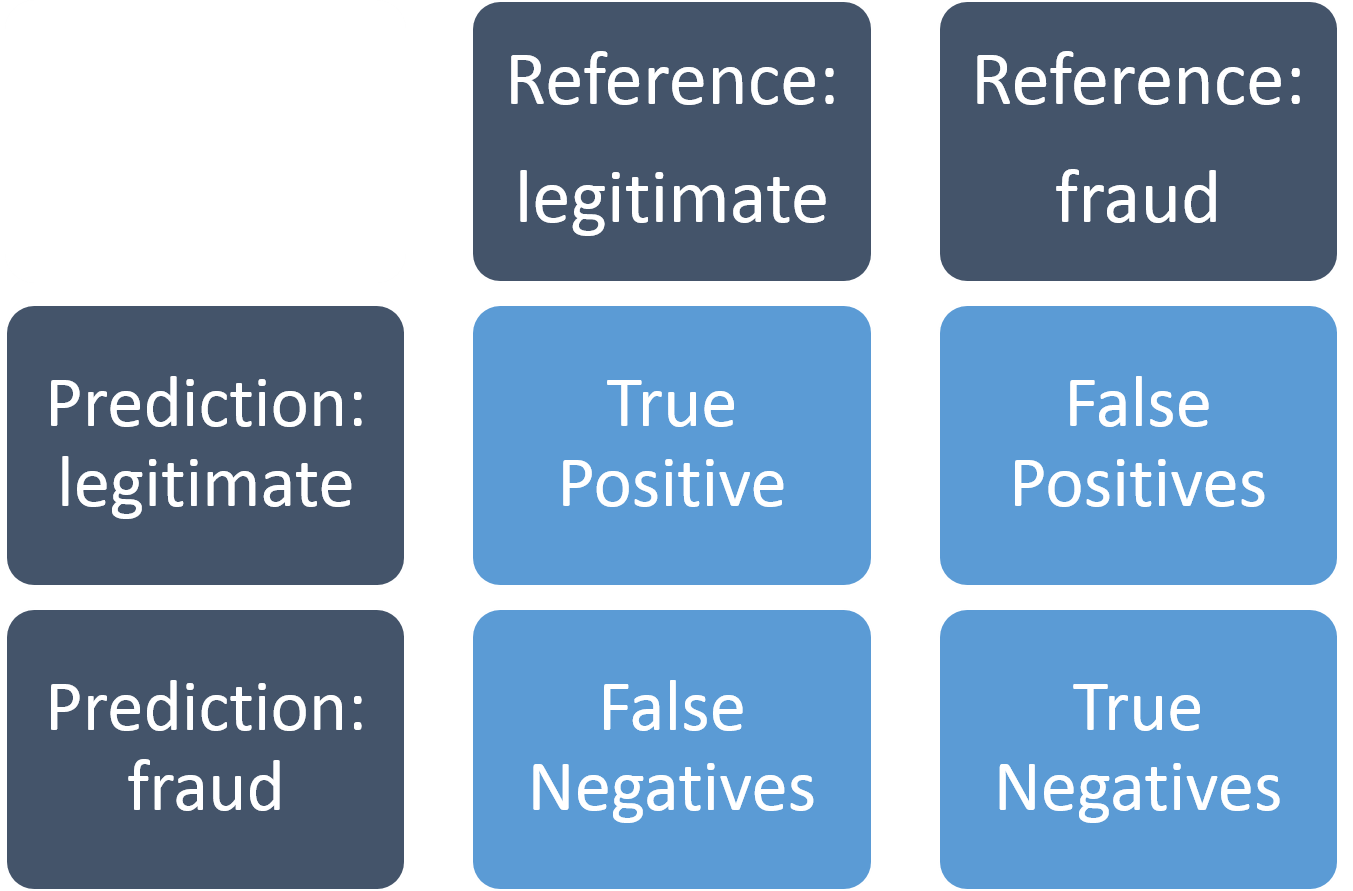
matrice de confusion

Détection de fraude en R
  • Supposons qu'aucun modèle ne soit utilisé : tous les sinistres sont considérés légitimes :
predictions <- rep.int(0, times = nrow(claims))
predictions <- factor(predictions, levels = c("no fraud", "fraud"))
  • Fonction confusionMatrix() du package caret :
library(caret)
confusionMatrix(data = predictions, reference = fraud_label)
             Reference
 Prediction    0   1
            0 614  14
            1   0   0                                   
 Accuracy : 0.9777
Détection de fraude en R

Coût total de la non-détection de fraude : sinistres

  • Coût total de la fraude : somme des montants frauduleux
  • Coût total si aucune fraude n'est détectée :
    > total_cost <- sum(claim_amount[fraud_label == "fraud"])
    > print(total_cost)
    
2301508
Détection de fraude en R

Passons à la pratique !

Détection de fraude en R

Preparing Video For Download...