Gérer les jeux de données déséquilibrés

Détection de fraude en R

Bart Baesens

Professor Data Science at KU Leuven

Jeux de données déséquilibrés
  • Défi clé : étiqueter les événements comme fraude ou non
    • Problème majeur pour la classification et la détection d'anomalies
  • Le classifieur favorise la classe majoritaire (= non-fraude)
    • forte erreur de classification sur les fraudes
  • Les classifieurs apprennent mieux avec une distribution équilibrée

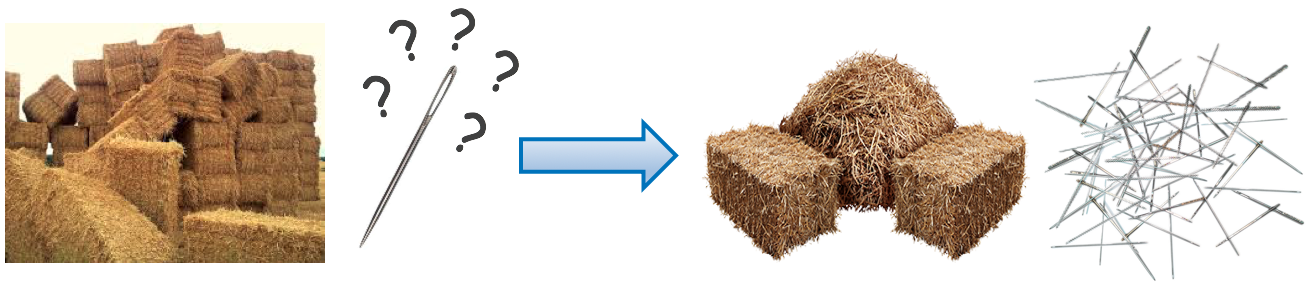
Botte de foin et aiguille

Détection de fraude en R

Jeux de données déséquilibrés

  • Défi clé : étiqueter les événements comme fraude ou non
    • Problème majeur pour la classification et la détection d'anomalies
  • Le classifieur favorise la classe majoritaire (= non-fraude)
    • forte erreur de classification sur les fraudes
  • Les classifieurs apprennent mieux avec une distribution équilibrée
  • Piste : modifier la distribution des classes via l'échantillonnage

Botte de foin et aiguille

Détection de fraude en R

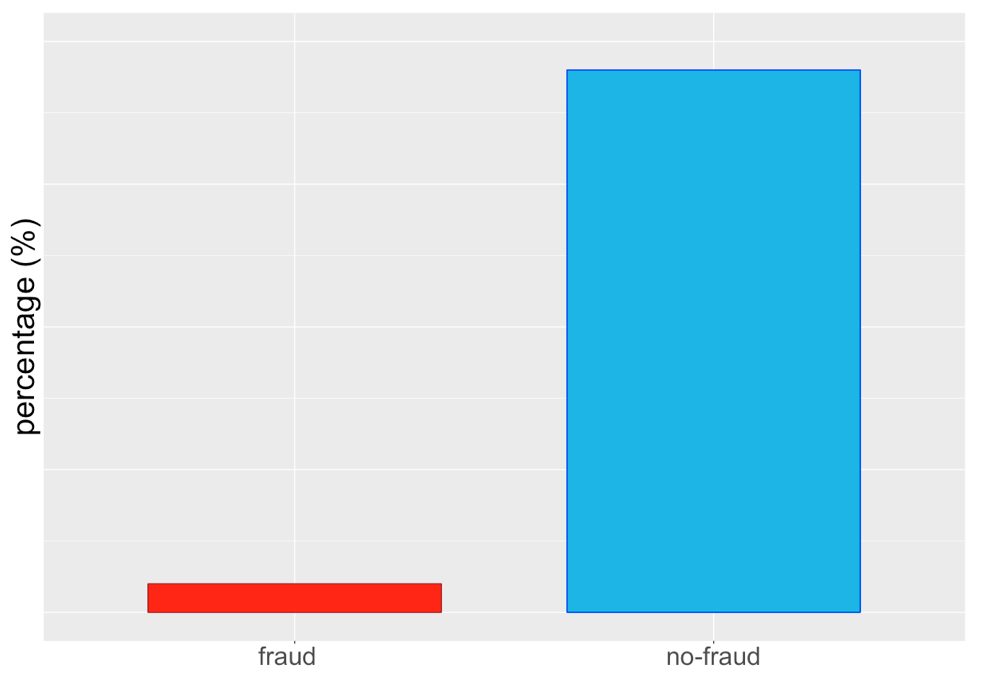
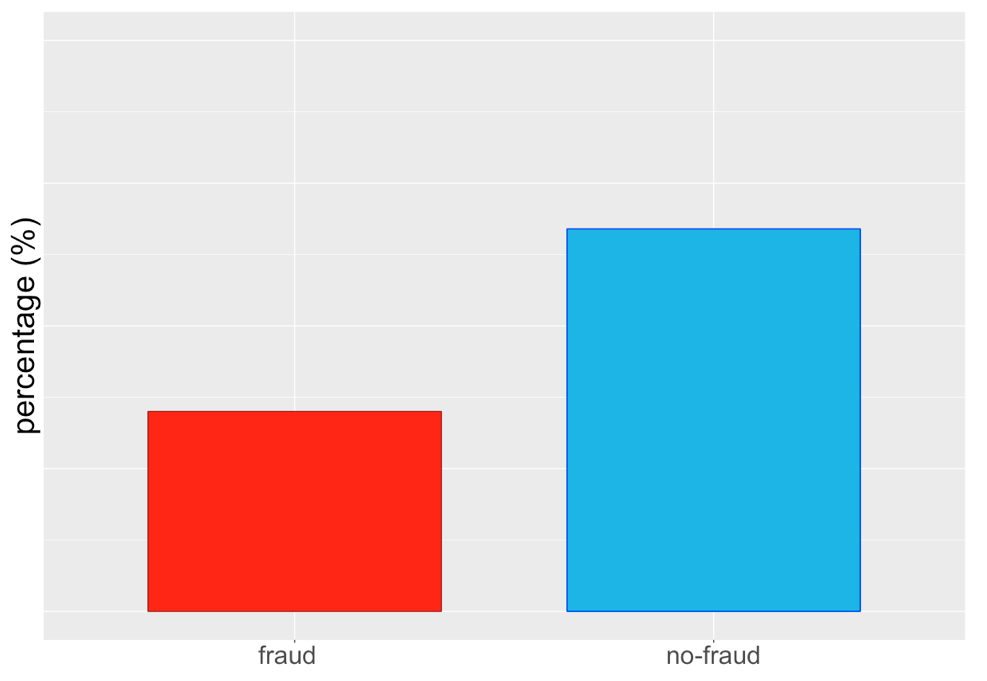
Déséquilibre initial

class_barplot_orig.png

Détection de fraude en R

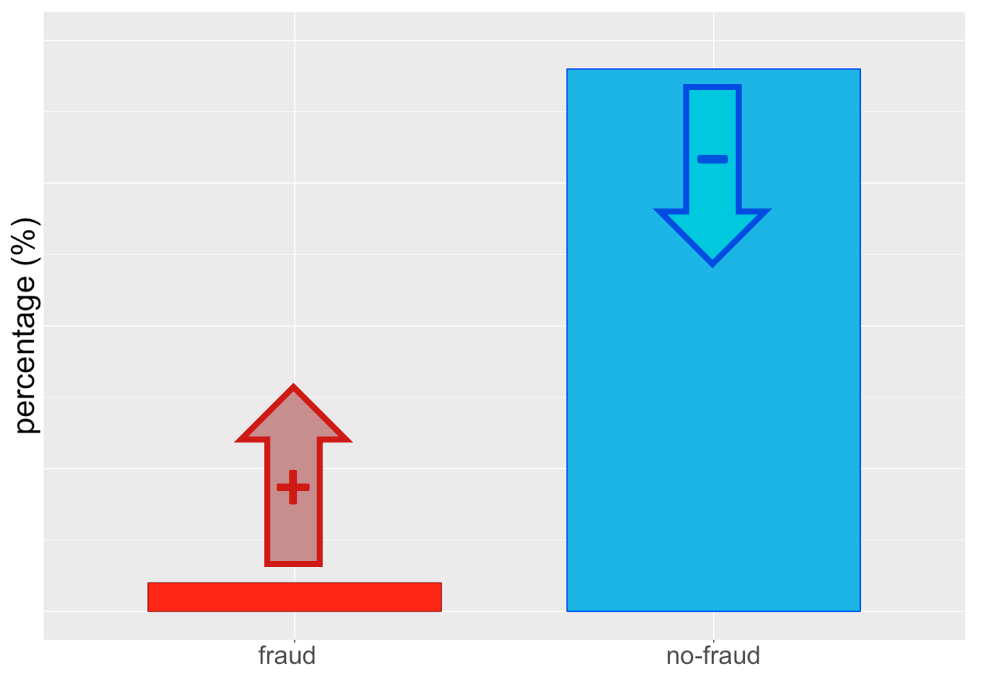
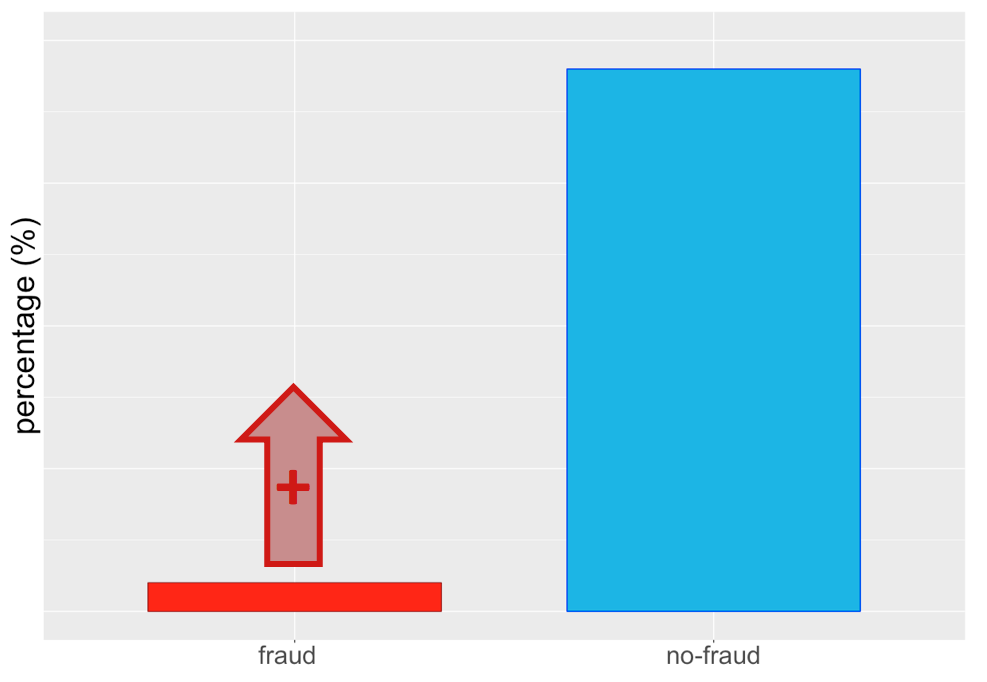
Sur-échantillonner la classe minoritaire…
class_barplot_over

Détection de fraude en R

... ou sous-échantillonner la classe majoritaire…
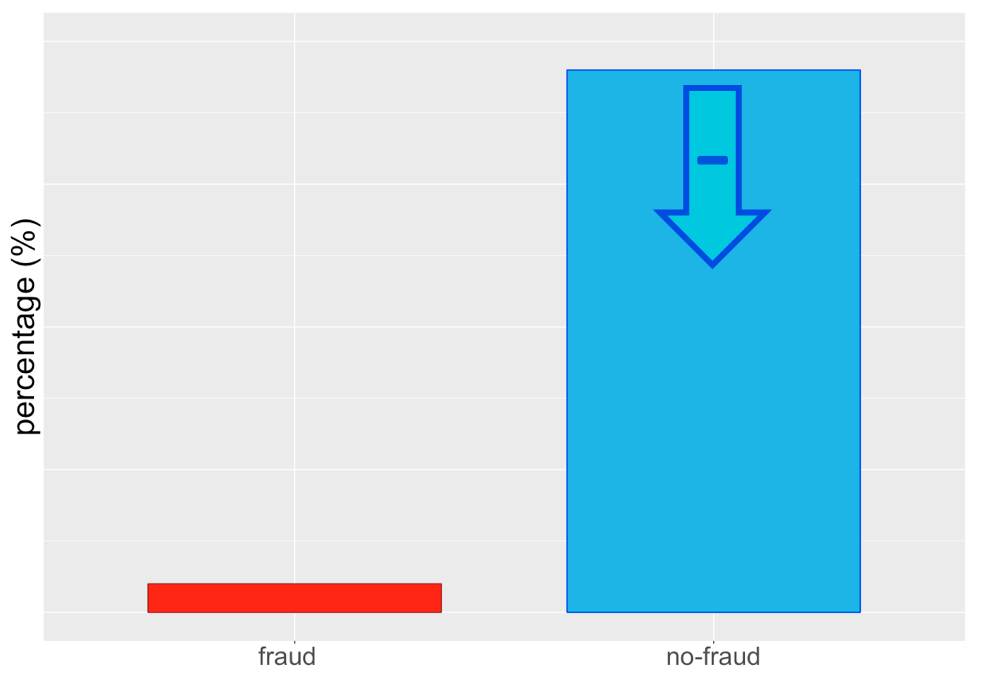
class_barplot_under

Détection de fraude en R

... ou les deux !

class_barplot_both

Détection de fraude en R

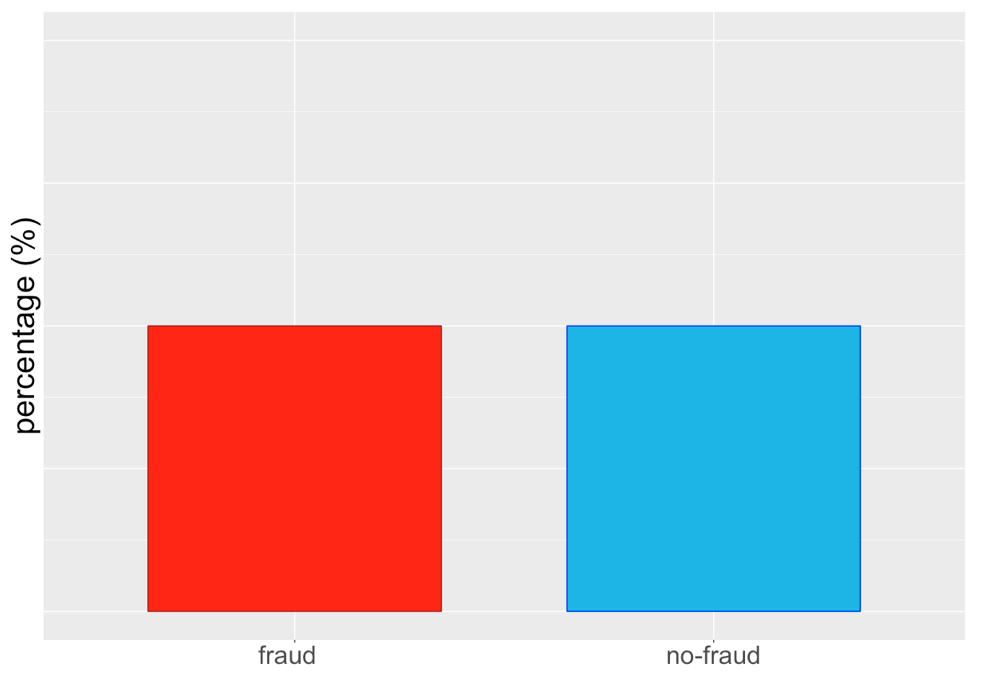
Résultat après échantillonnage…

class_barplot_result2

Détection de fraude en R

... ou comme ceci

class_barplot_result1

Détection de fraude en R

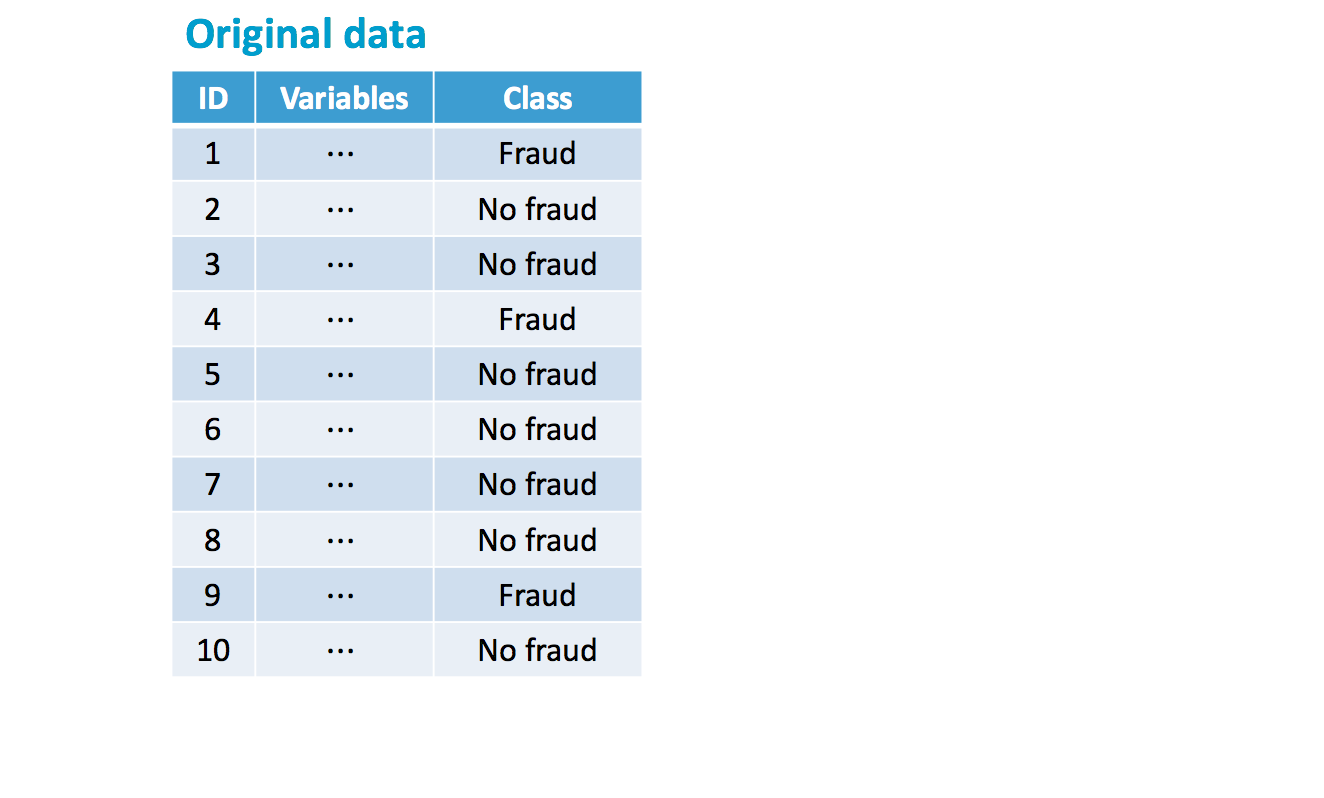
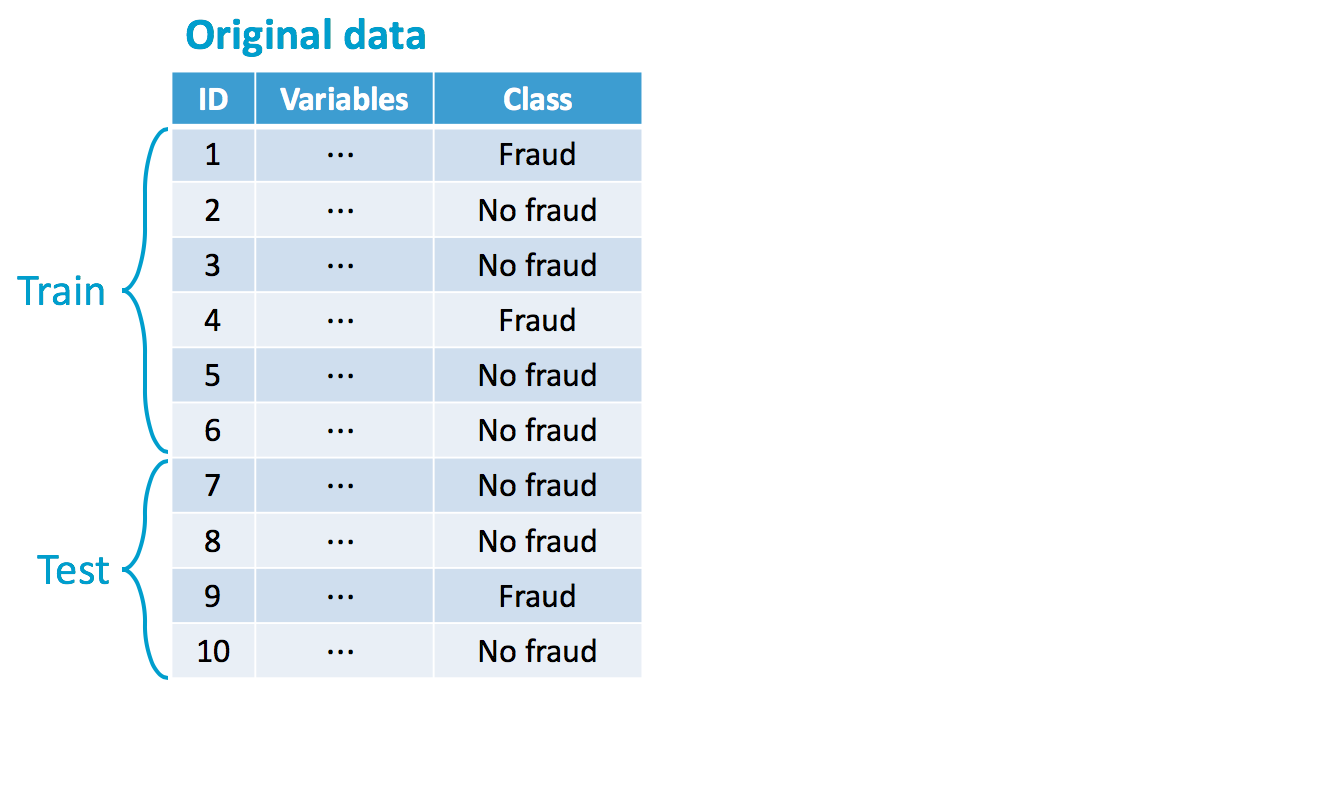
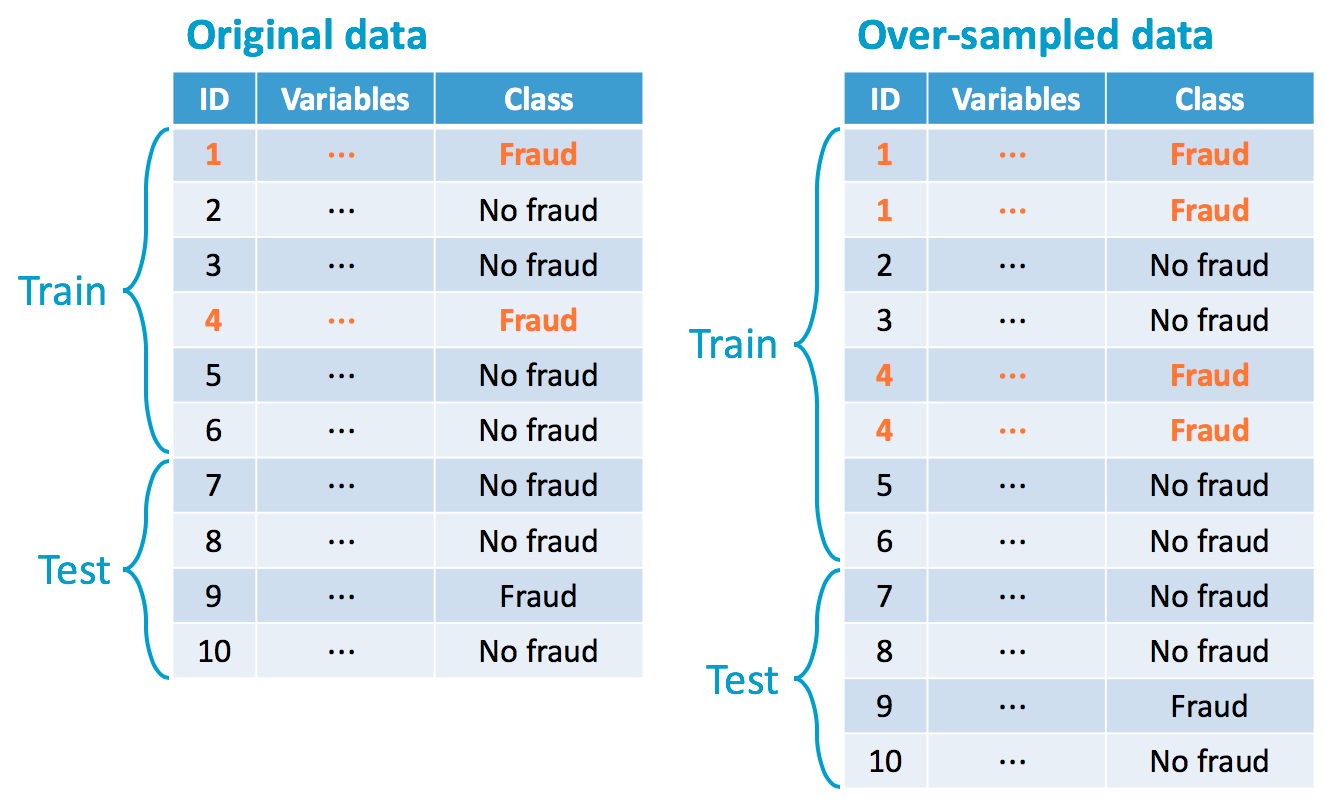
Sur-échantillonnage aléatoire (ROS)
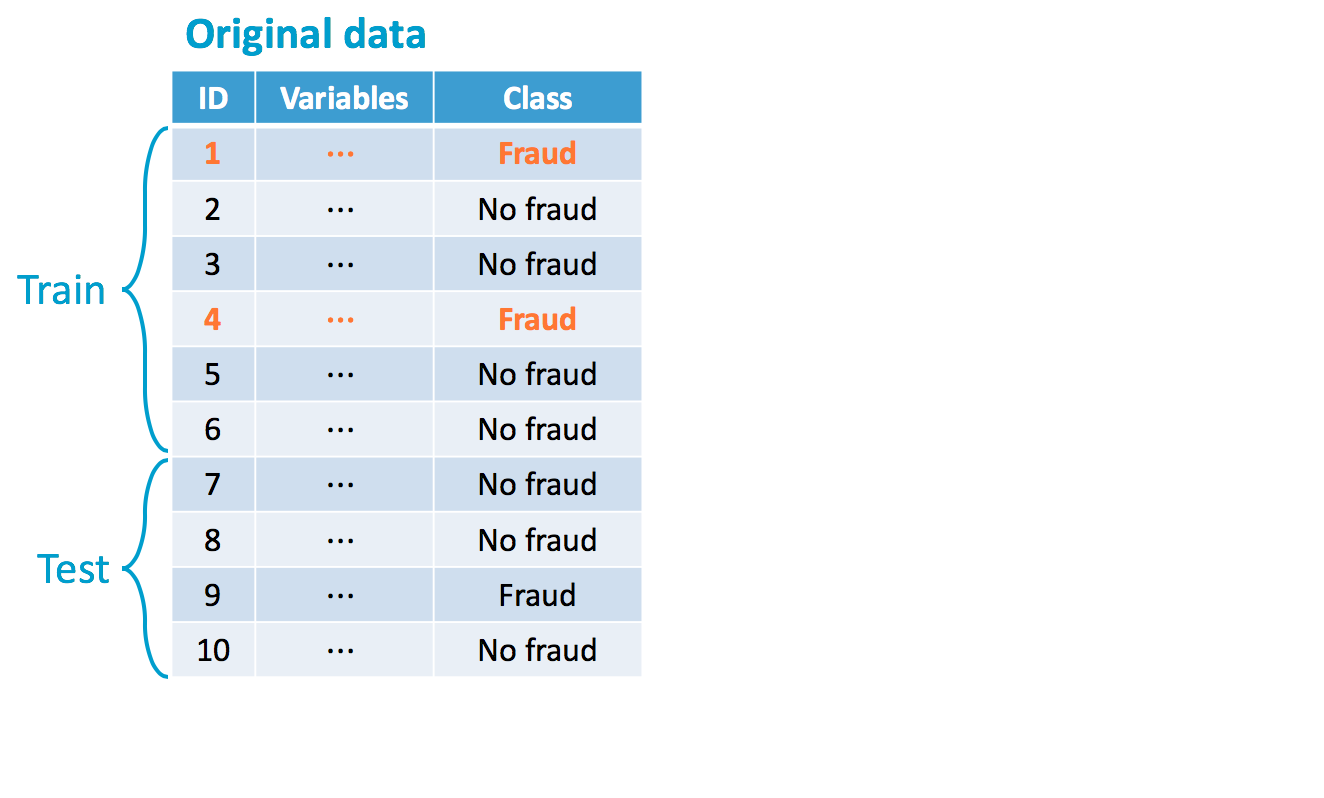
orig_data_v0

Détection de fraude en R

orig_data_train_test

Détection de fraude en R

random_oversampling_v0

Détection de fraude en R

random_oversampling_v1

Détection de fraude en R

Sur-échantillonnage aléatoire en pratique

  • Jeu de données Credit Card Fraud Detection sur Kaggle
    • $\sim$ 300K virements par carte anonymisés, étiquetés fraude ou valide
  • À propos des données…
    • Variables numériques (anonymisées) : V1, V2, …, V28
    • Time = secondes écoulées entre chaque virement et le premier du jeu
    • Amount = montant de la transaction
    • Class = variable cible : 1 en cas de fraude, 0 sinon
Détection de fraude en R

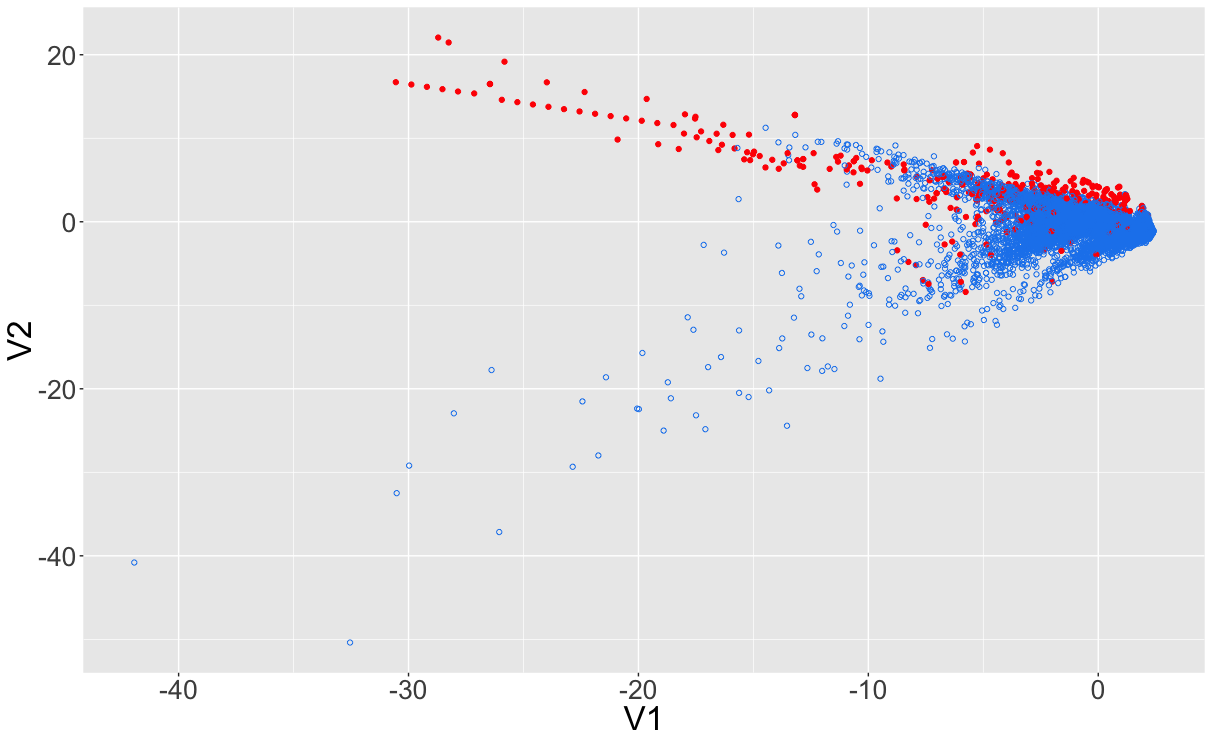
Aperçu V2 vs V1

Détection de fraude en R

Vérifier le déséquilibre

head(creditcard)
  Time         V1         V2  ...            V27         V28 Amount Class
1    0  1.1918571  0.2661507  ...  -0.0089830991  0.01472417   2.69     0
2   10  0.3849782  0.6161095  ...   0.0424724419 -0.05433739   9.99     0
3   12 -0.7524170  0.3454854  ...  -0.1809975001  0.12939406  15.99     0
4   17  0.9624961  0.3284610  ...   0.0163706433 -0.01460533  34.09     0
5   34  0.2016859  0.4974832  ...   0.1427572469  0.21923761   9.99     0
prop.table(table(creditcard$Class))
   0    1 
0.98 0.02
Détection de fraude en R

ovun.sample du package ROSE

n_legit <- 24108
new_frac_legit <- 0.50
new_n_total <- n_legit / new_frac_legit ## = 24108 / 0.50 = 48216

library(ROSE) oversampling_result <- ovun.sample(formula = Class ~ ., data = creditcard, method = "over", N = new_n_total, seed = 2018)
oversampled_credit <- oversampling_result$data prop.table(table(oversampled_credit$Class))
  0   1 
0.5 0.5
Détection de fraude en R

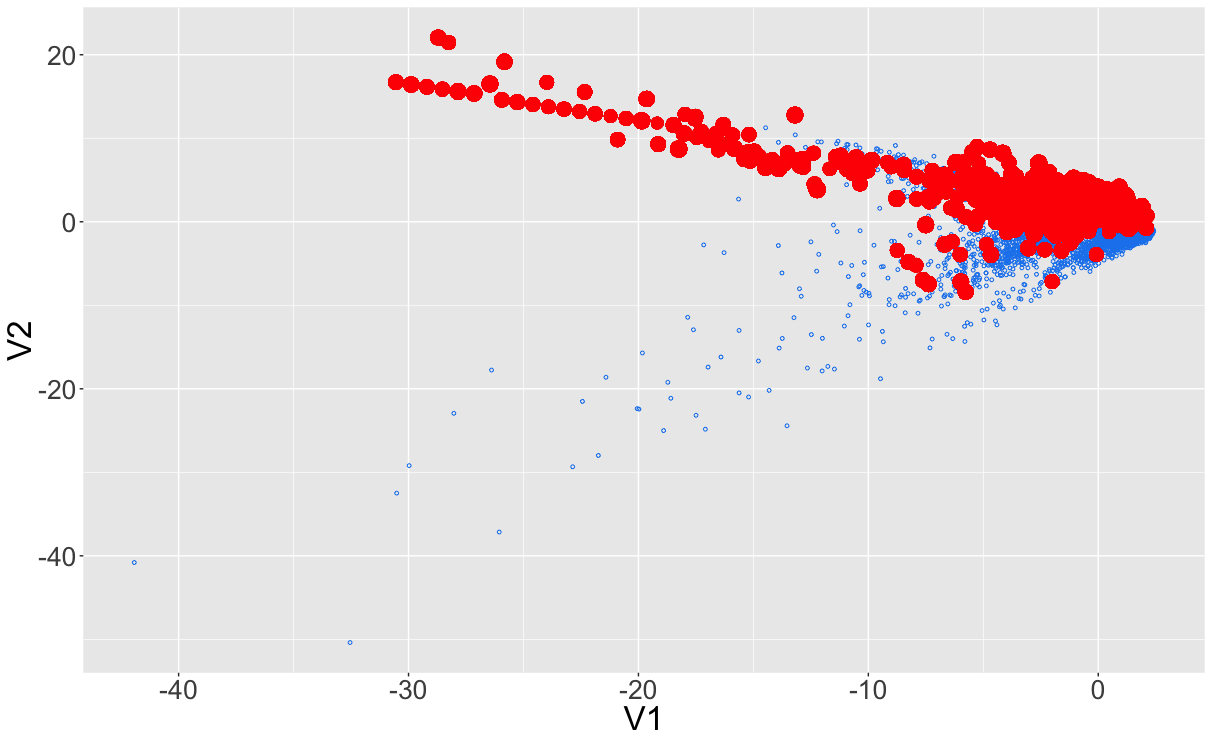
Aperçu sur-échantillonné V2 vs V1

Détection de fraude en R

Passons à la pratique !

Détection de fraude en R

Preparing Video For Download...