Backtesting

Concevoir des pipelines de prévision pour la production

Rami Krispin

Senior Manager, Data Science and Engineering

Backtesting
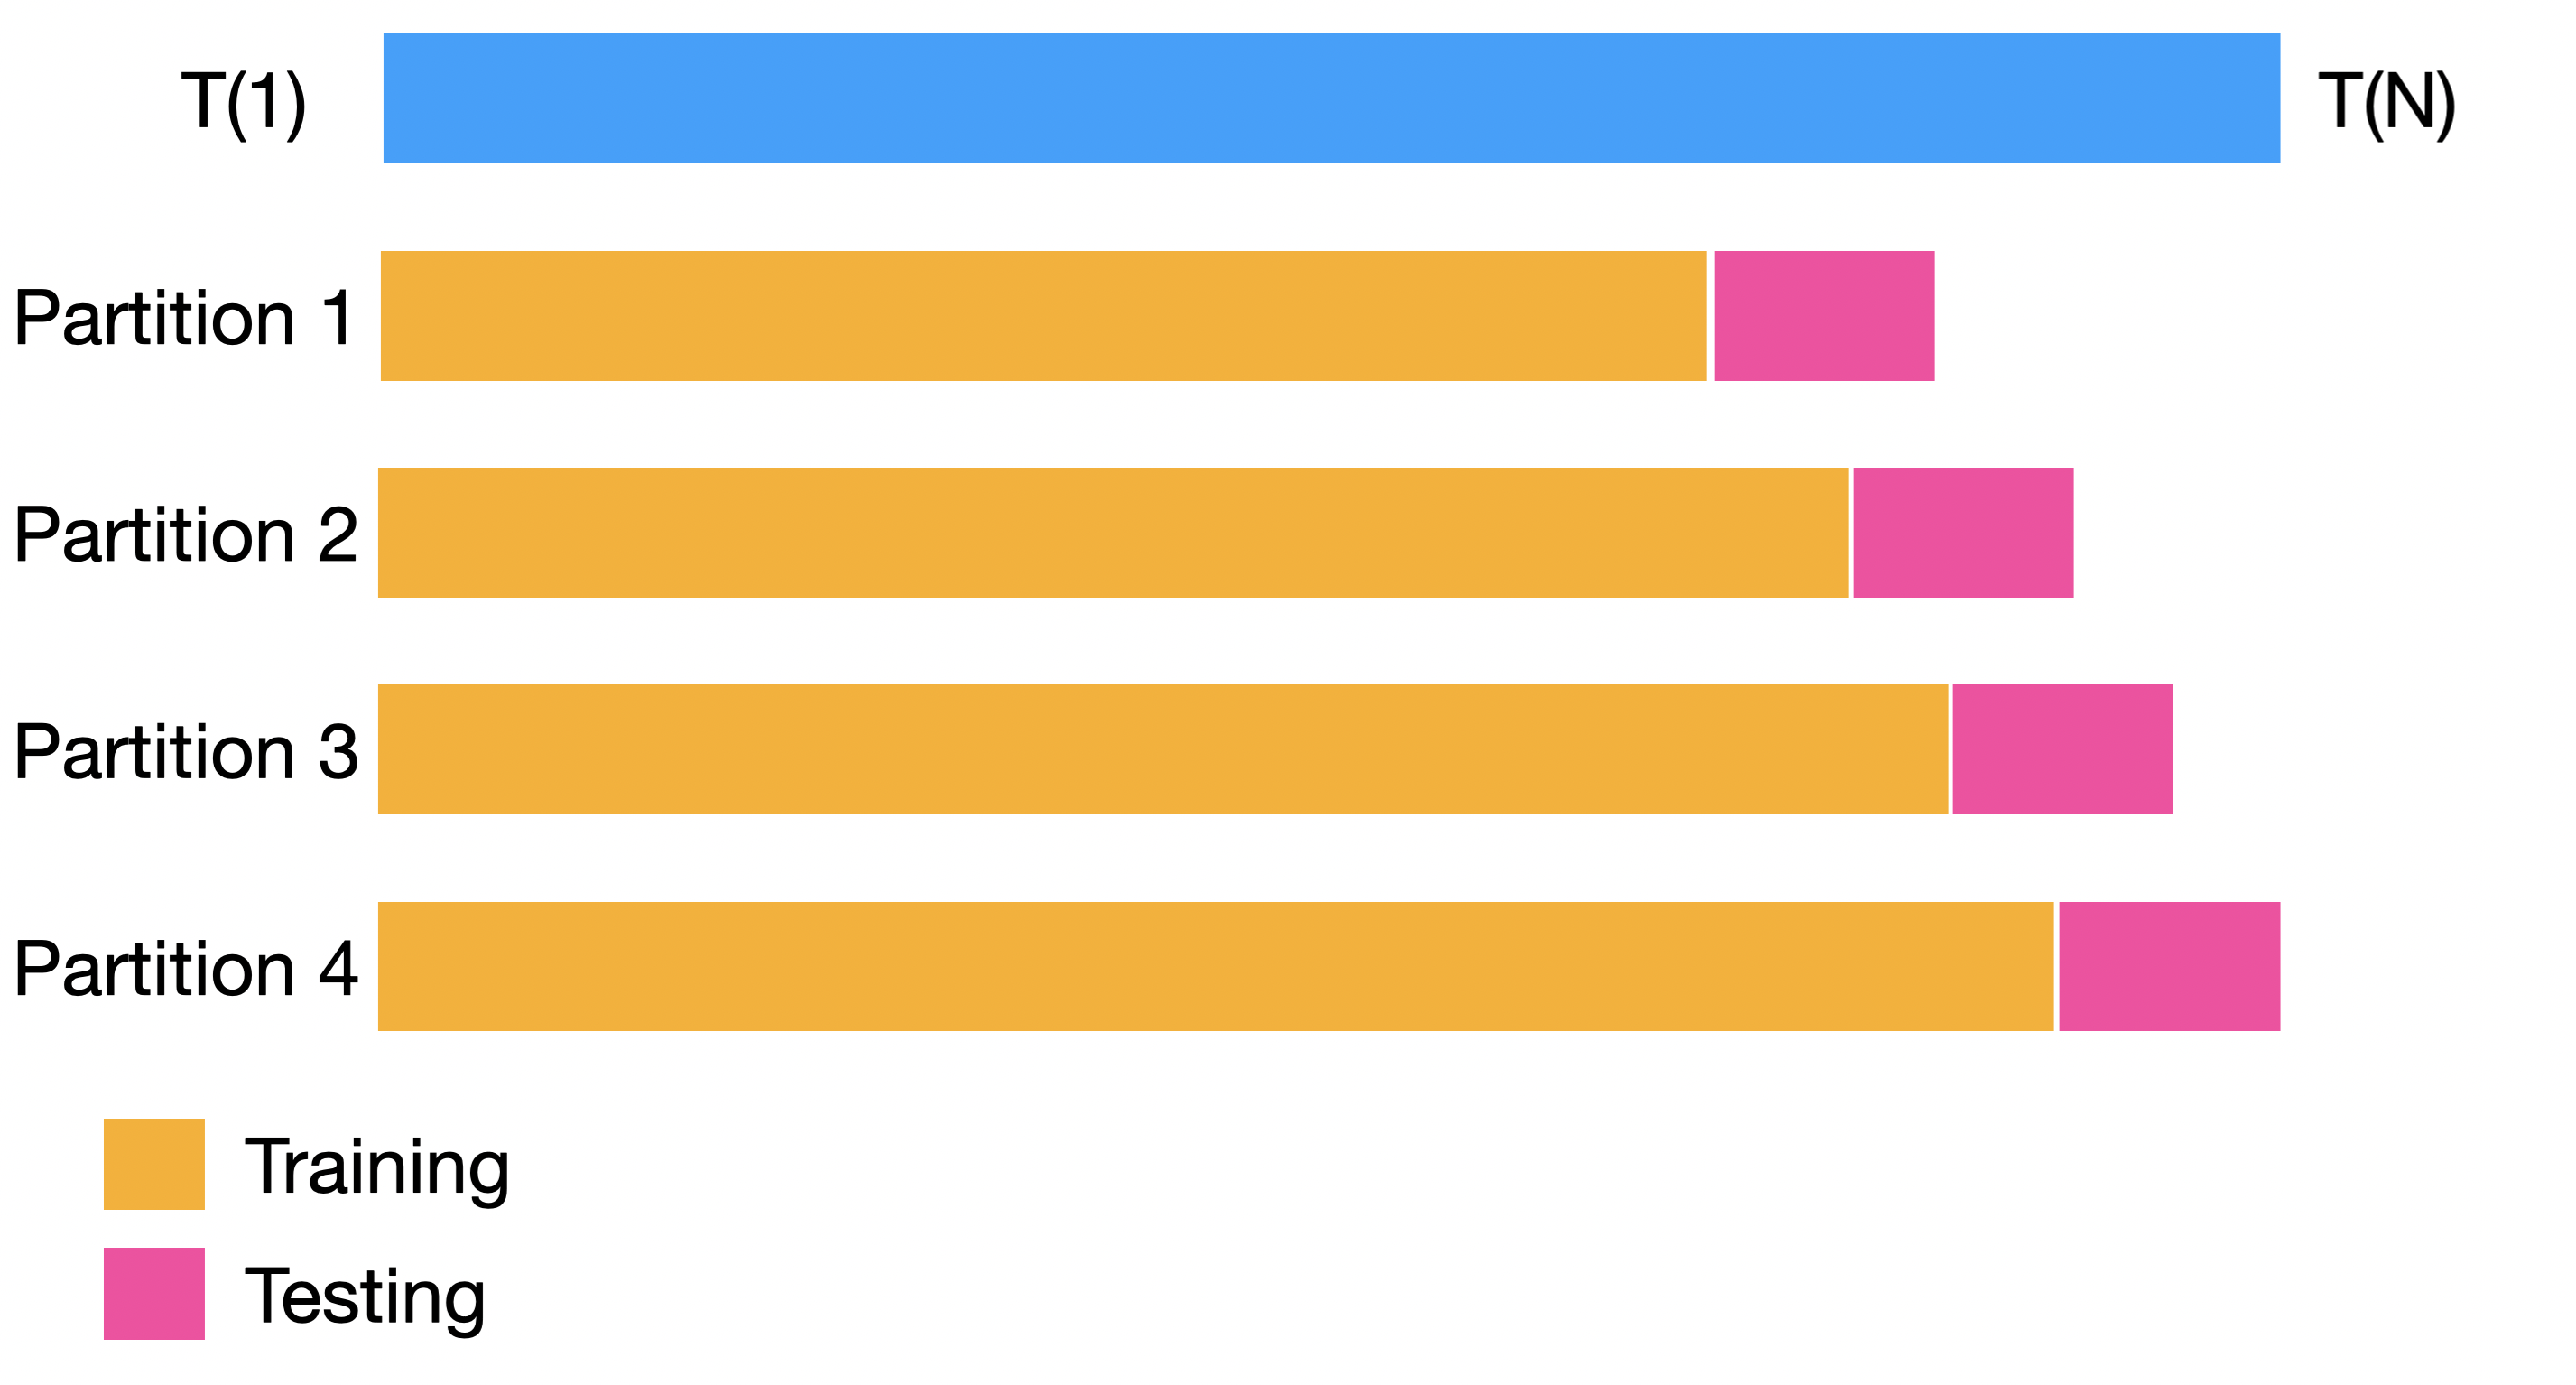
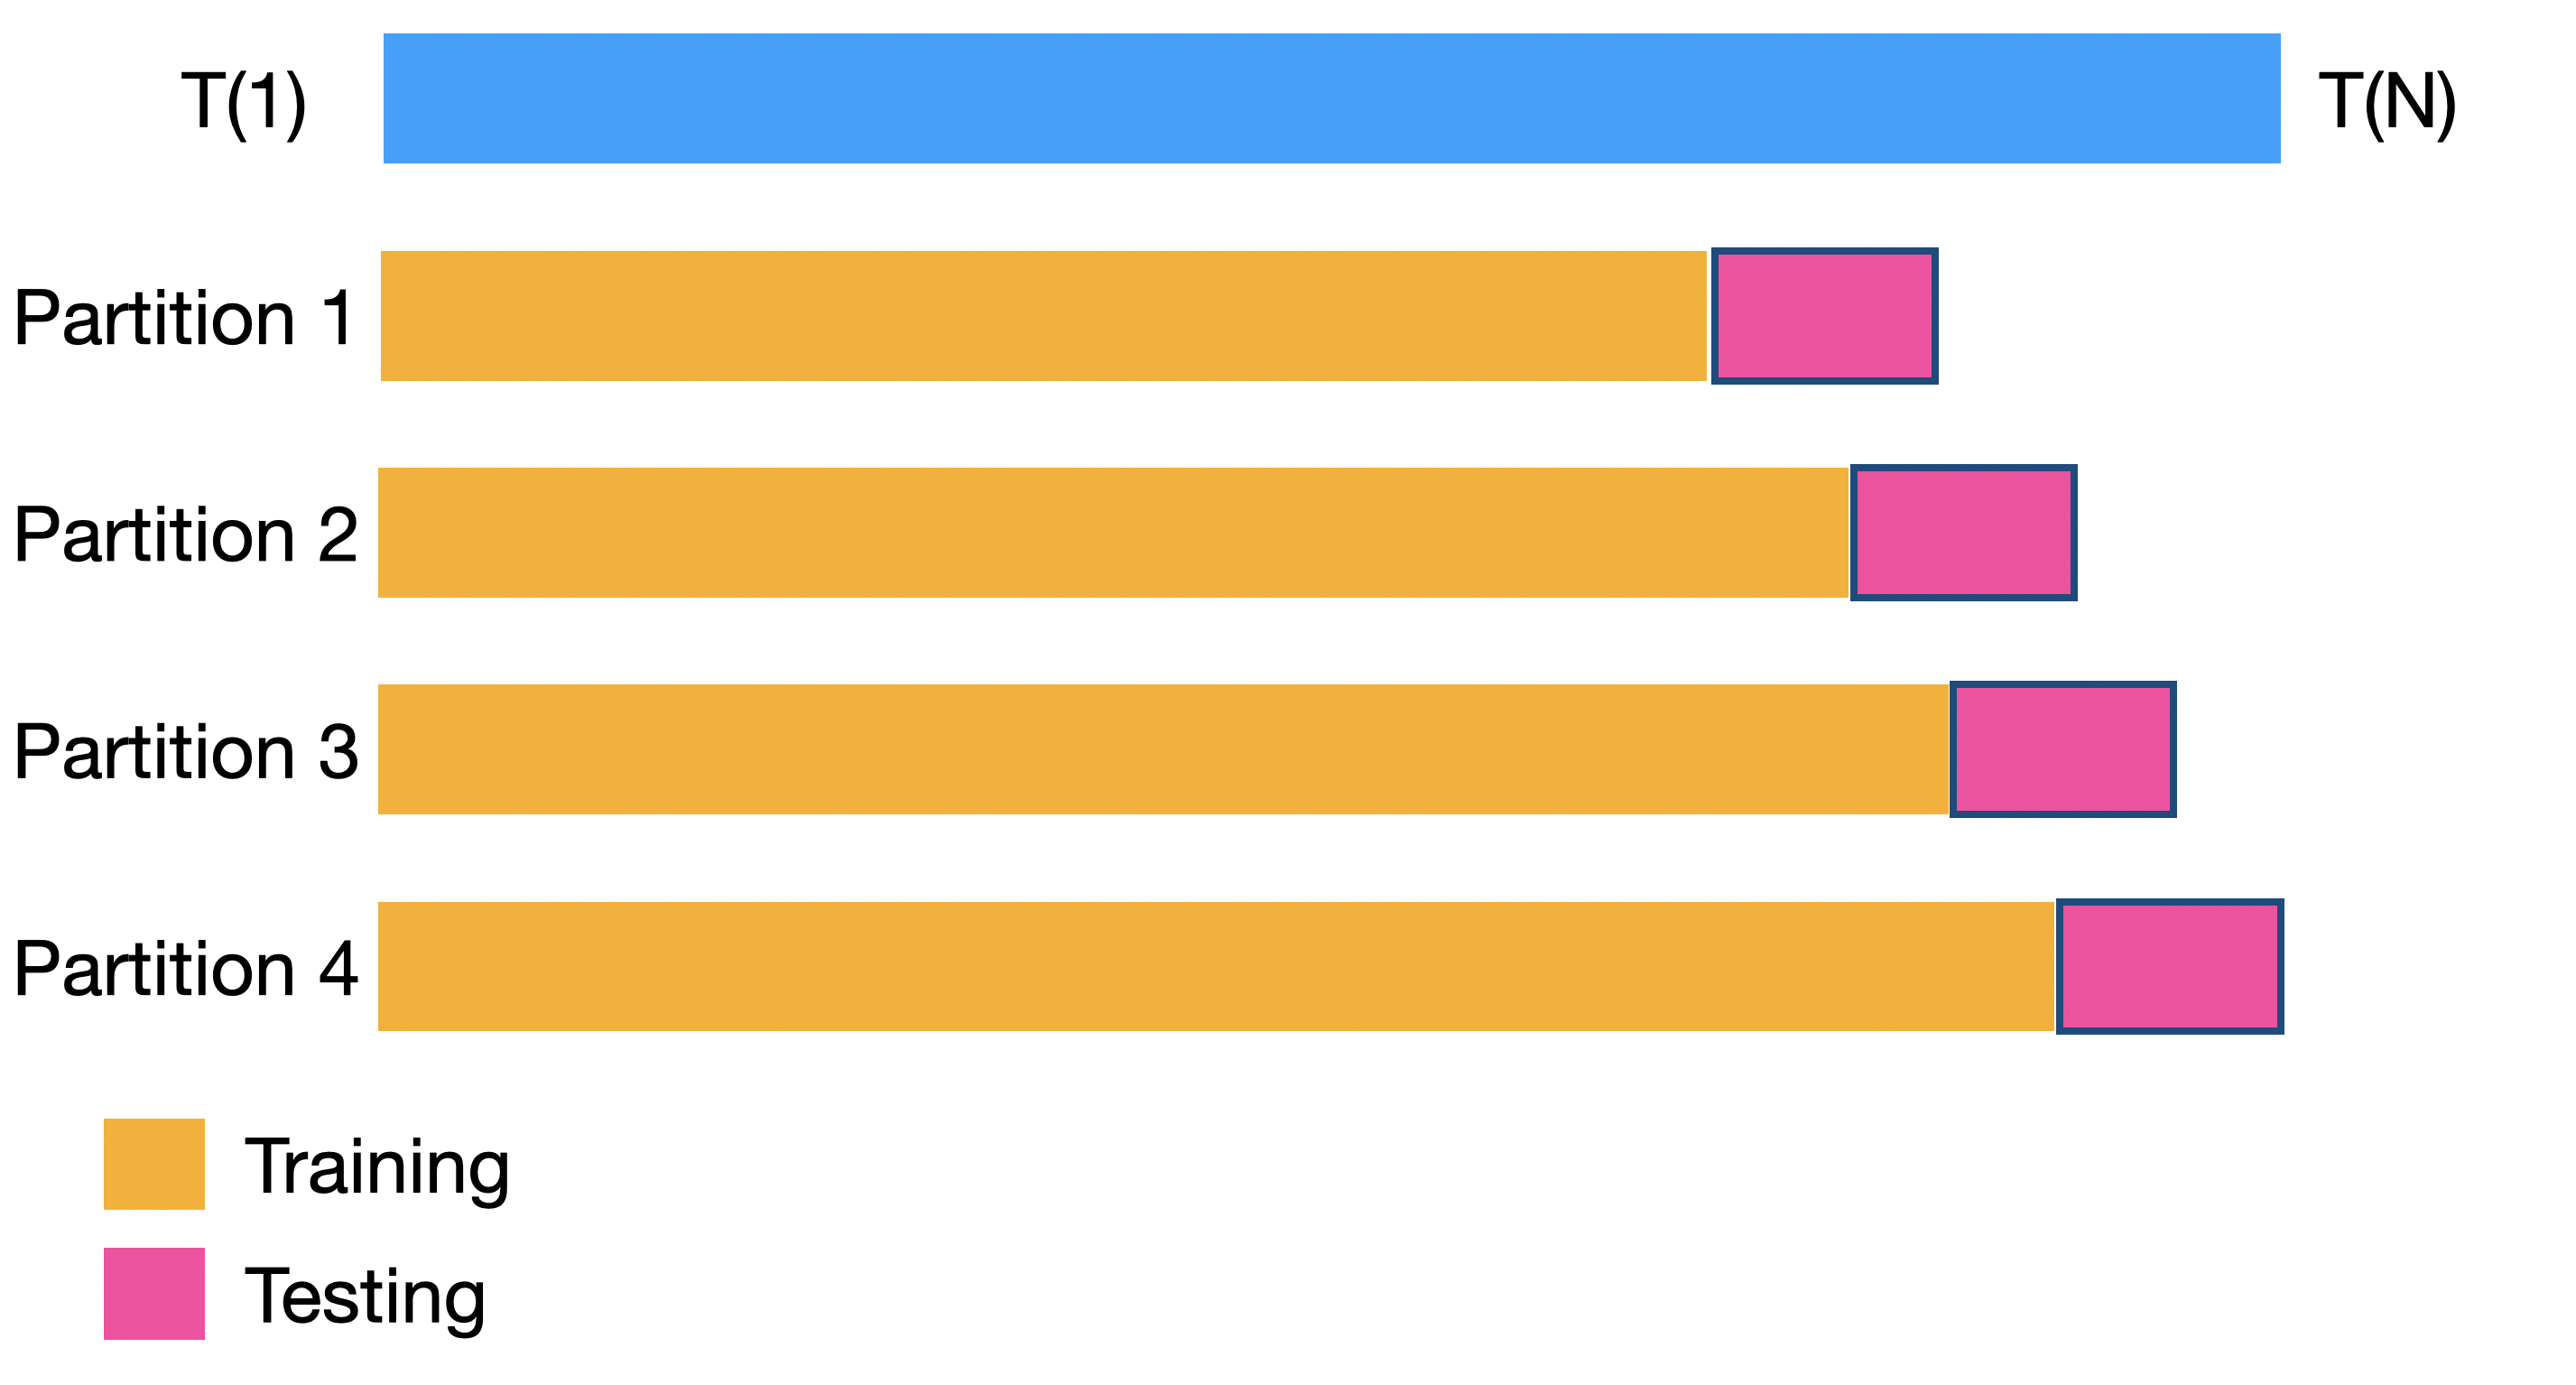
Backtesting : découper les données en plusieurs partitions (fenêtres) pour entraîner et tester des modèles
Concevoir des pipelines de prévision pour la production

Backtesting

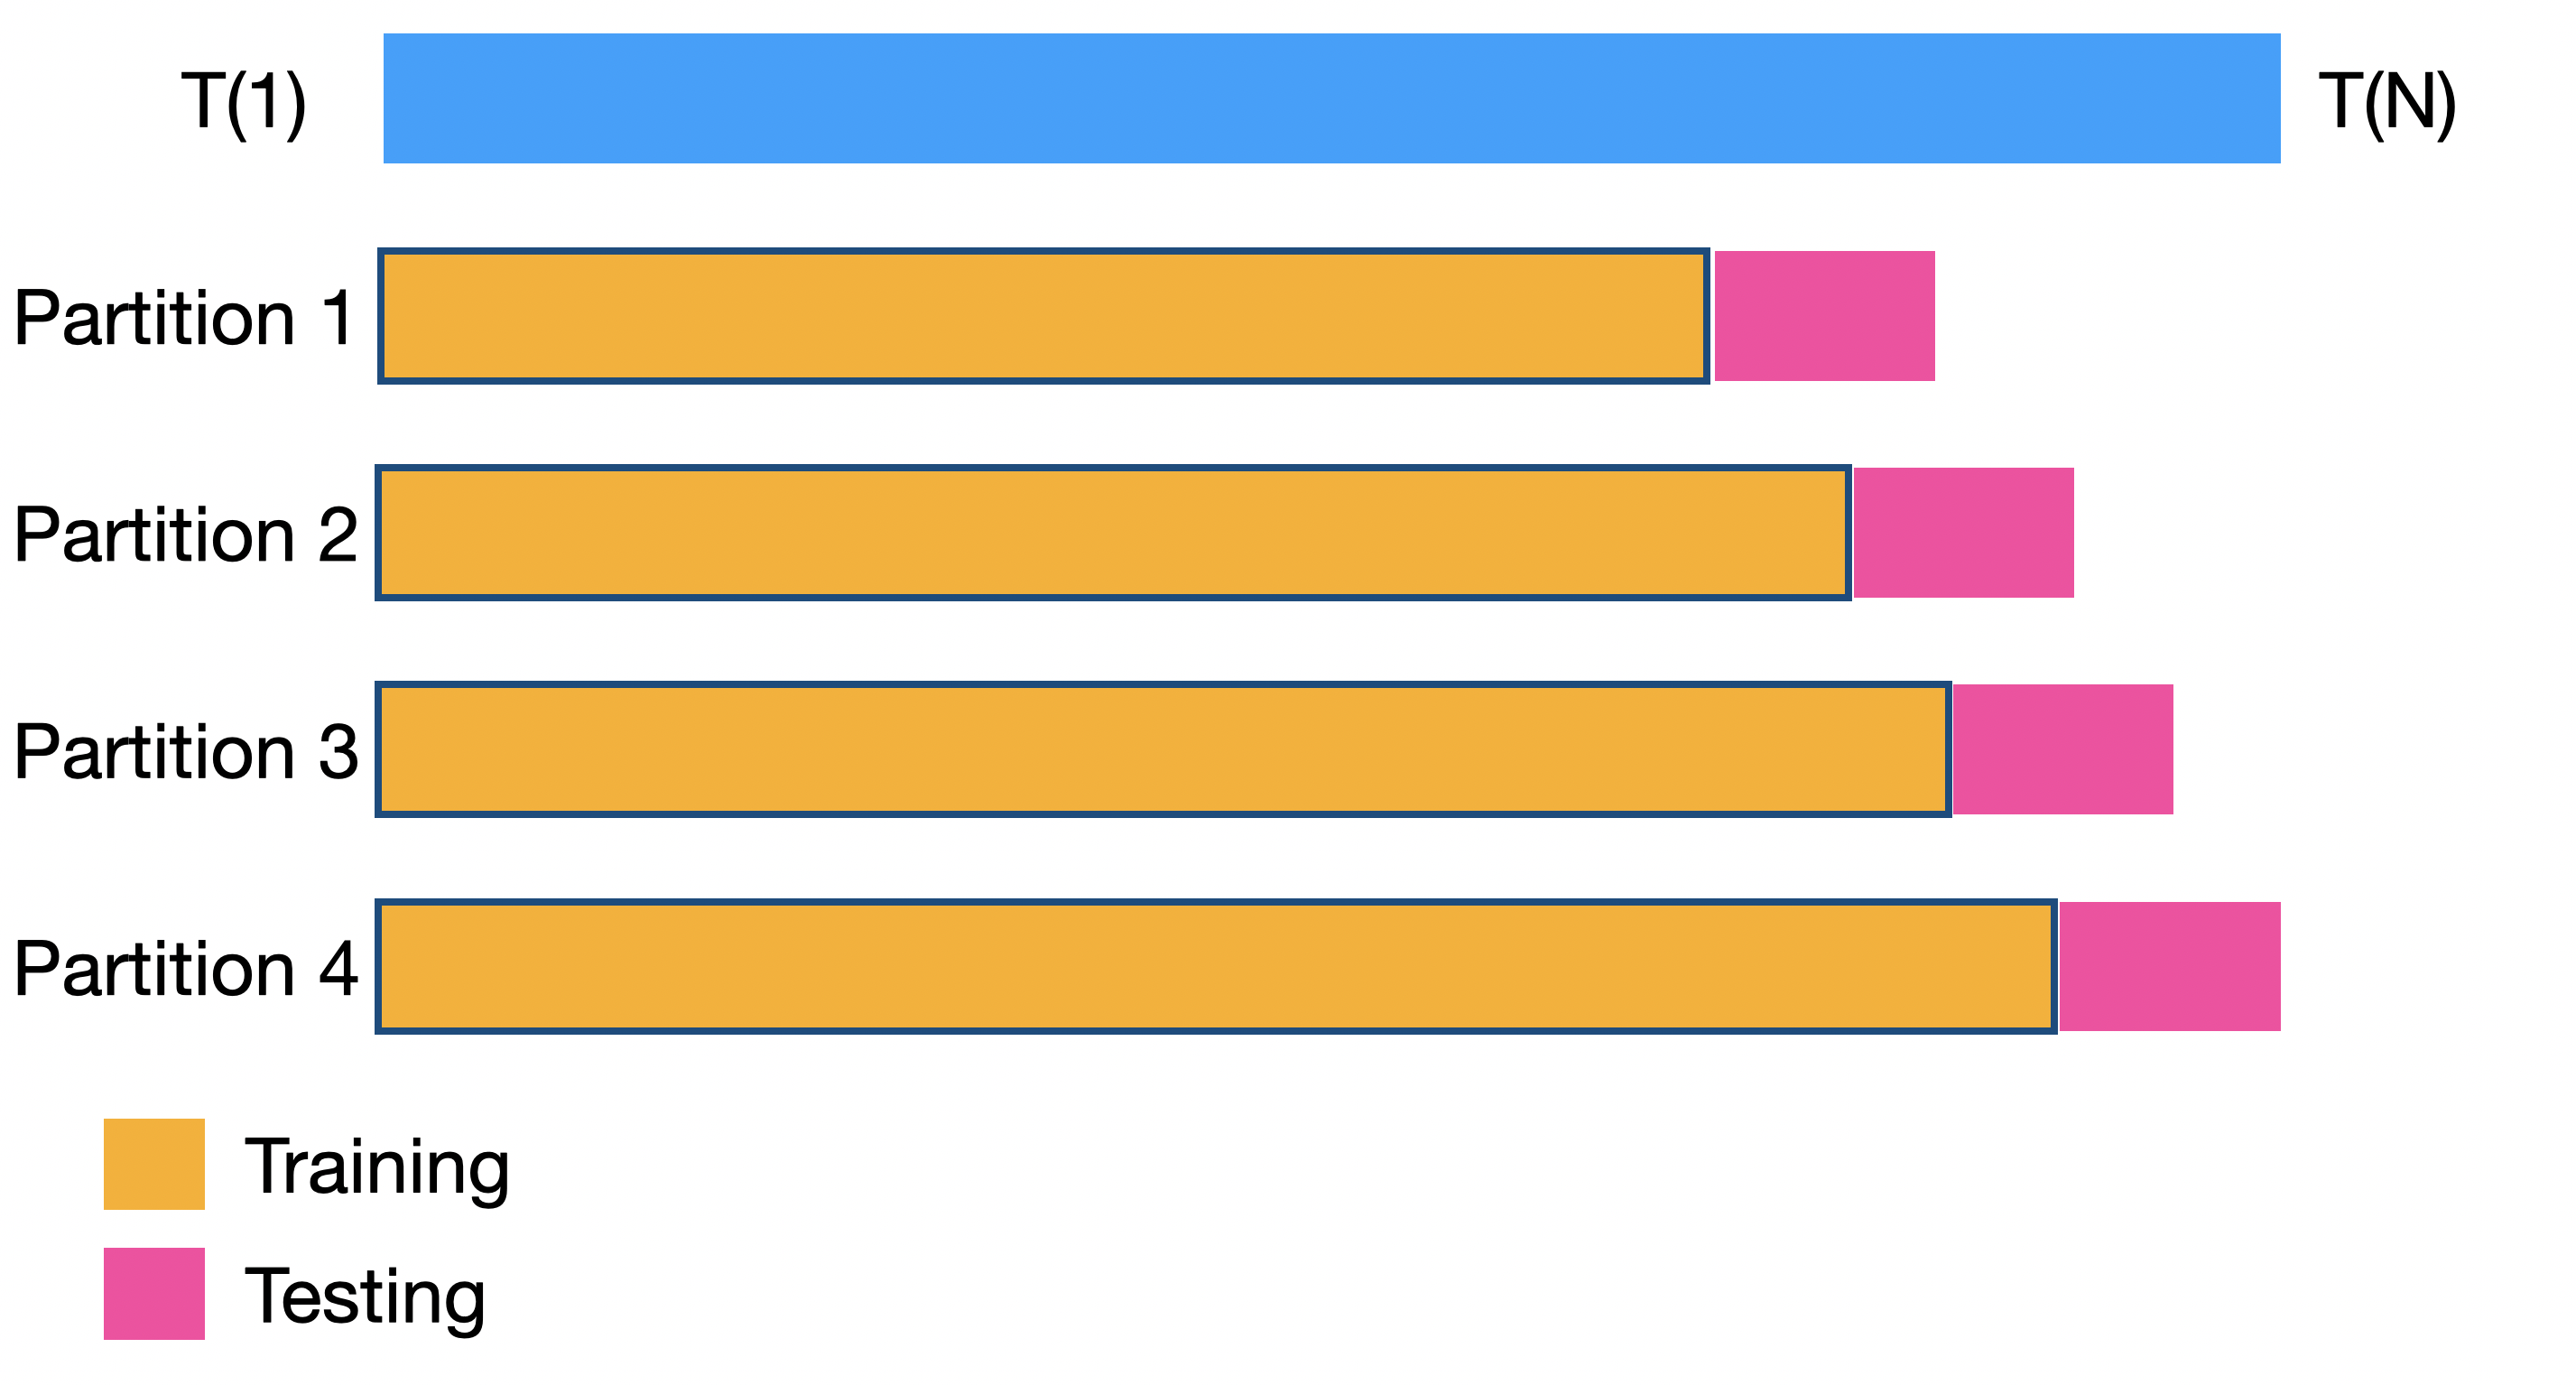
Les découpages d'entraînement

Concevoir des pipelines de prévision pour la production

Backtesting

Les découpages de test

Concevoir des pipelines de prévision pour la production

Backtesting

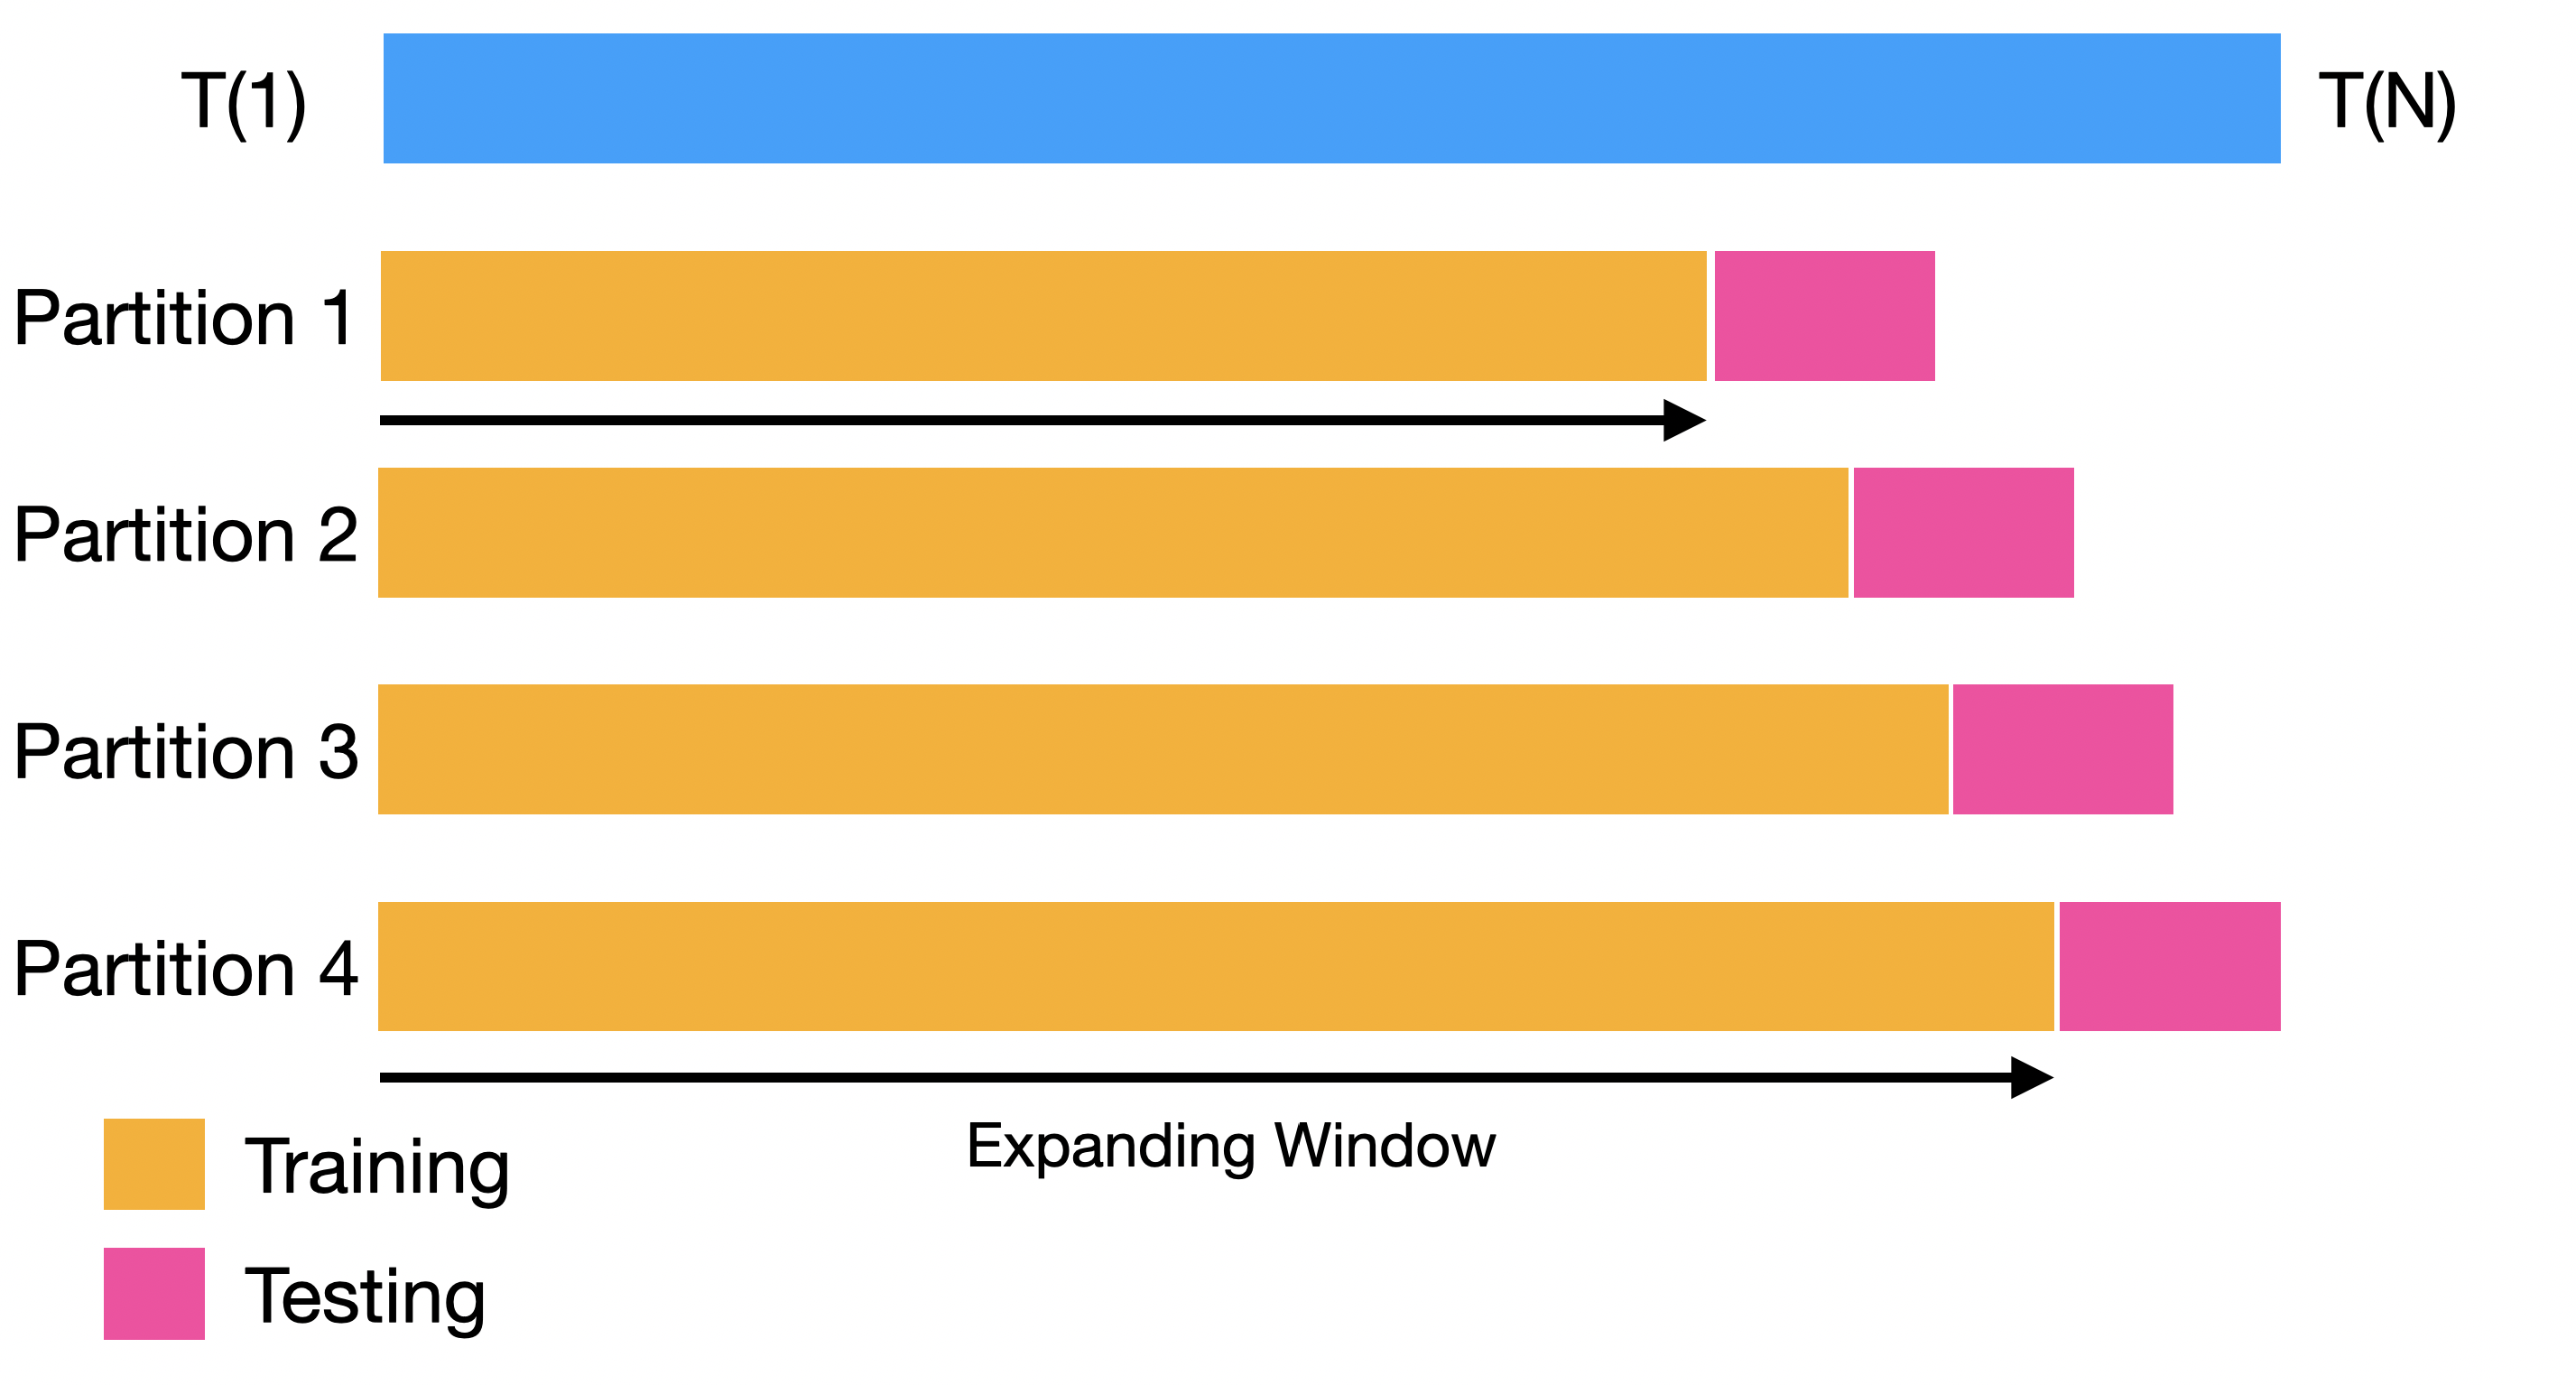
La fenêtre « expanding » augmente la taille de l'échantillon à chaque partition

Concevoir des pipelines de prévision pour la production

Backtesting

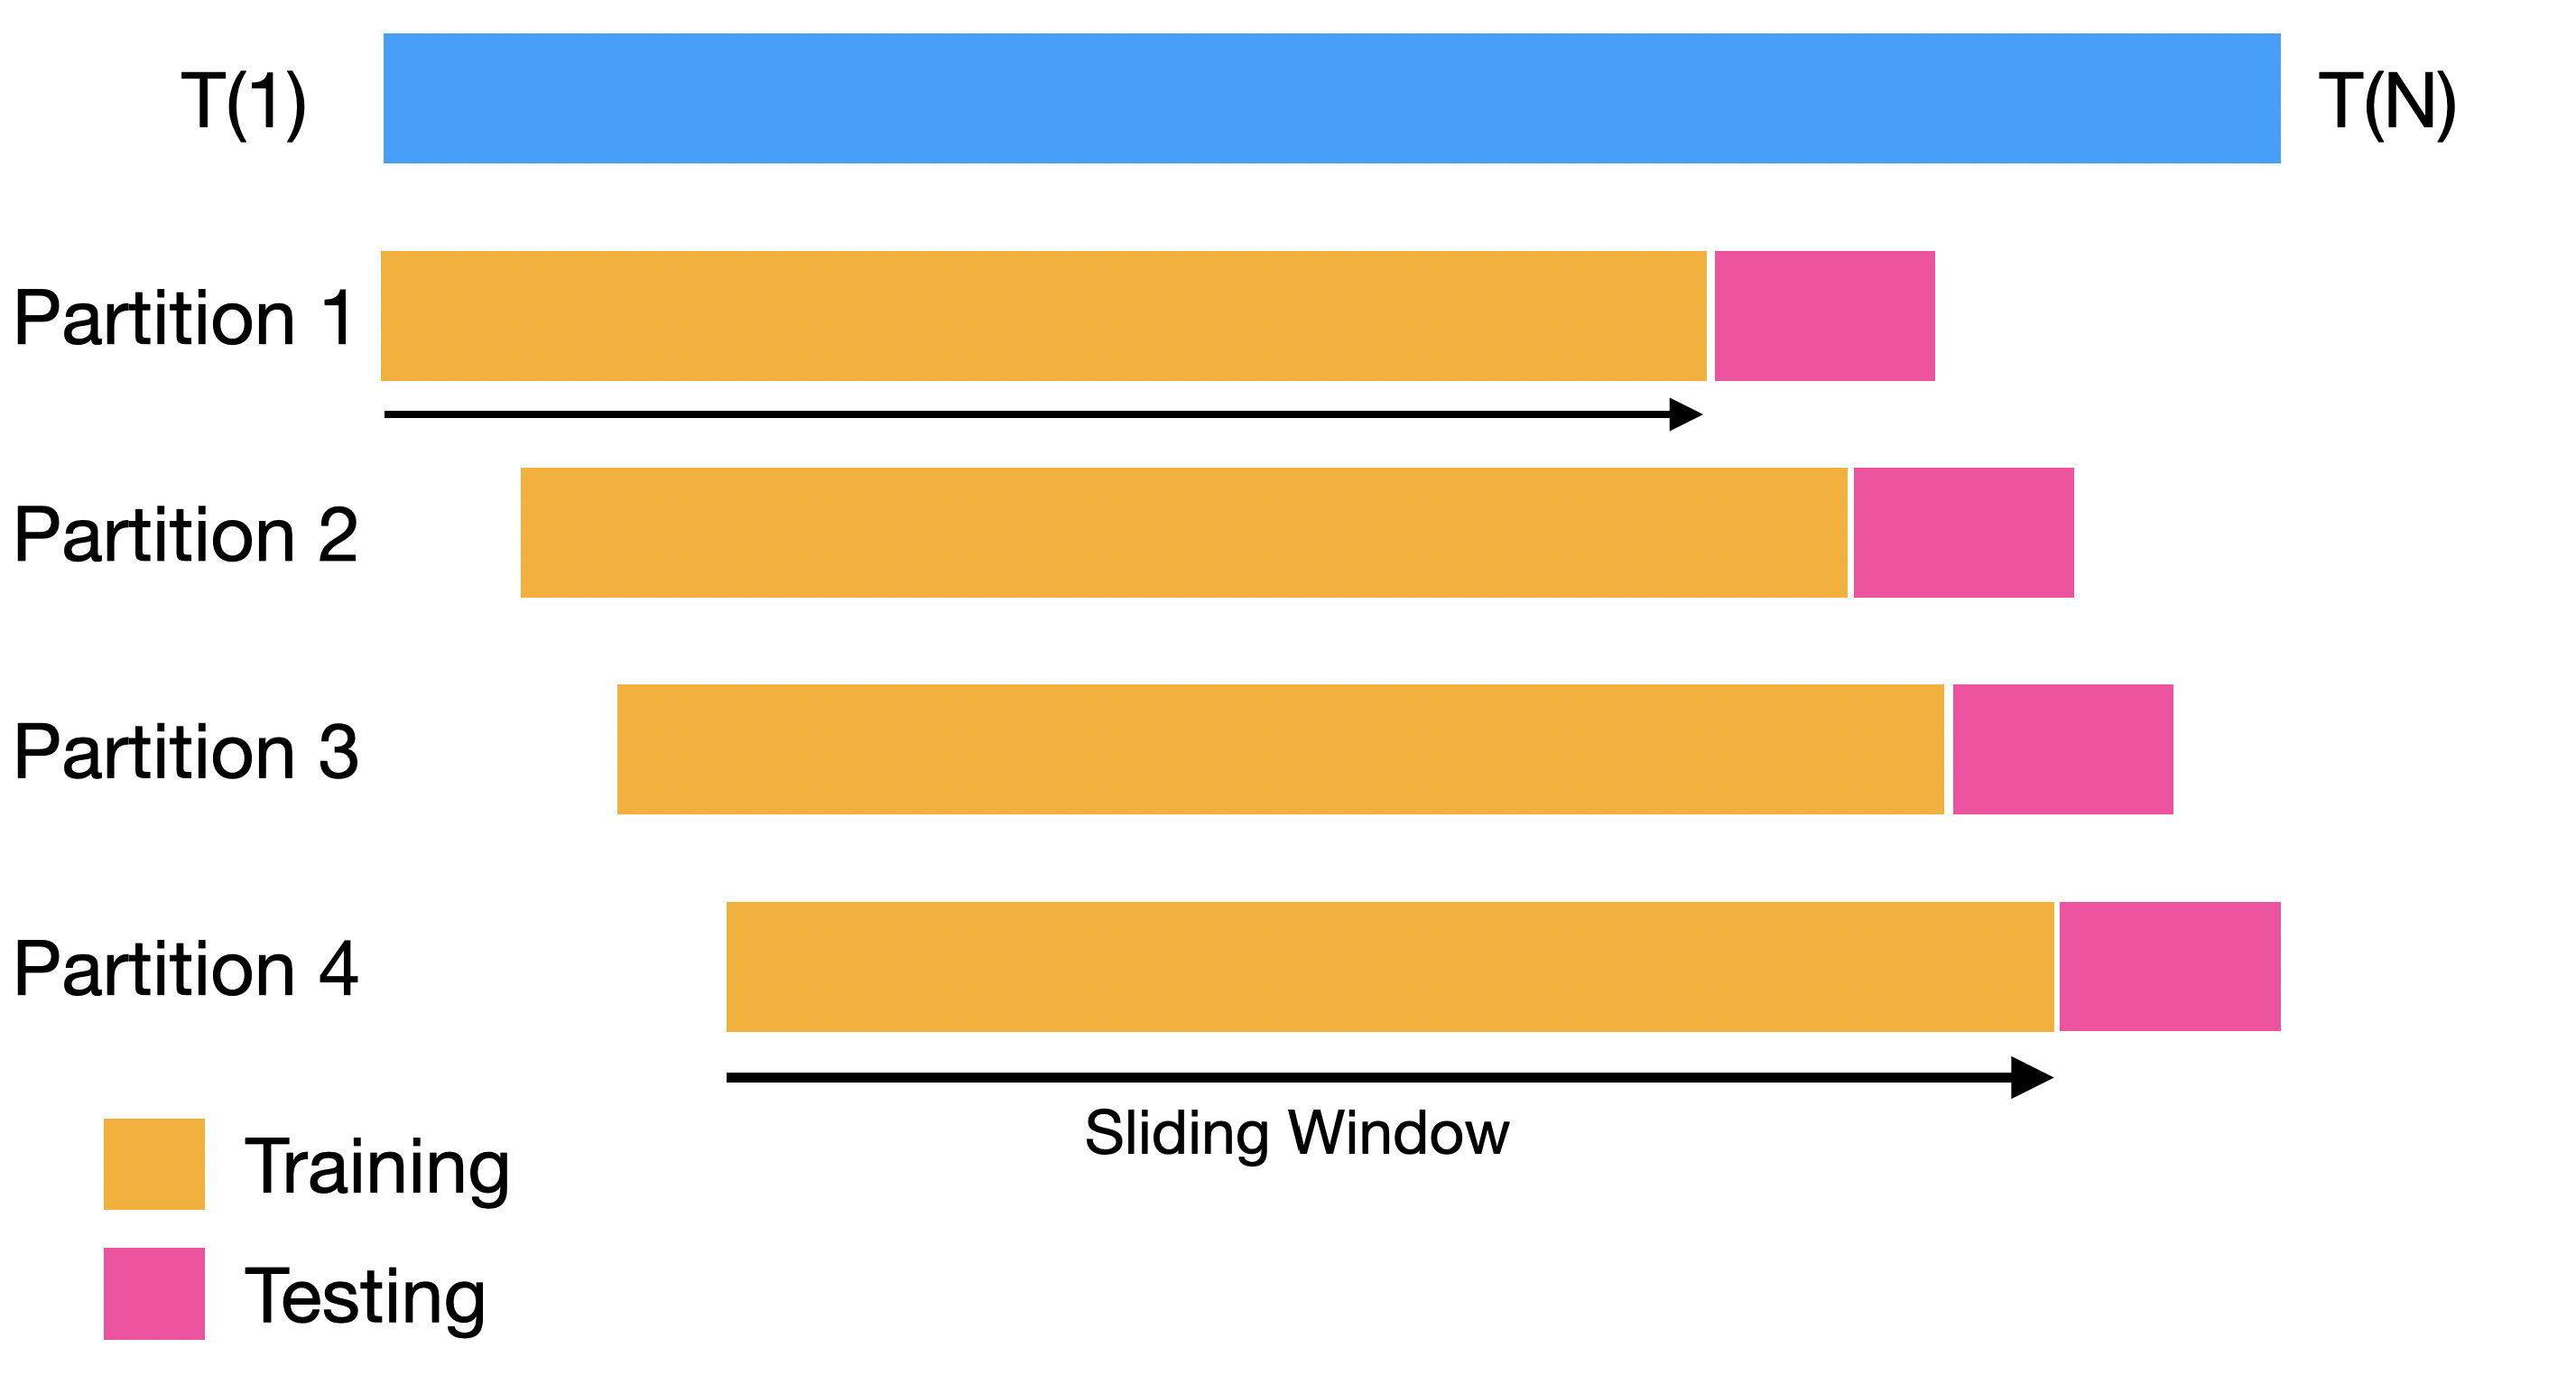
La fenêtre « sliding » maintient la même taille d'échantillon par partition

Concevoir des pipelines de prévision pour la production

Backtesting

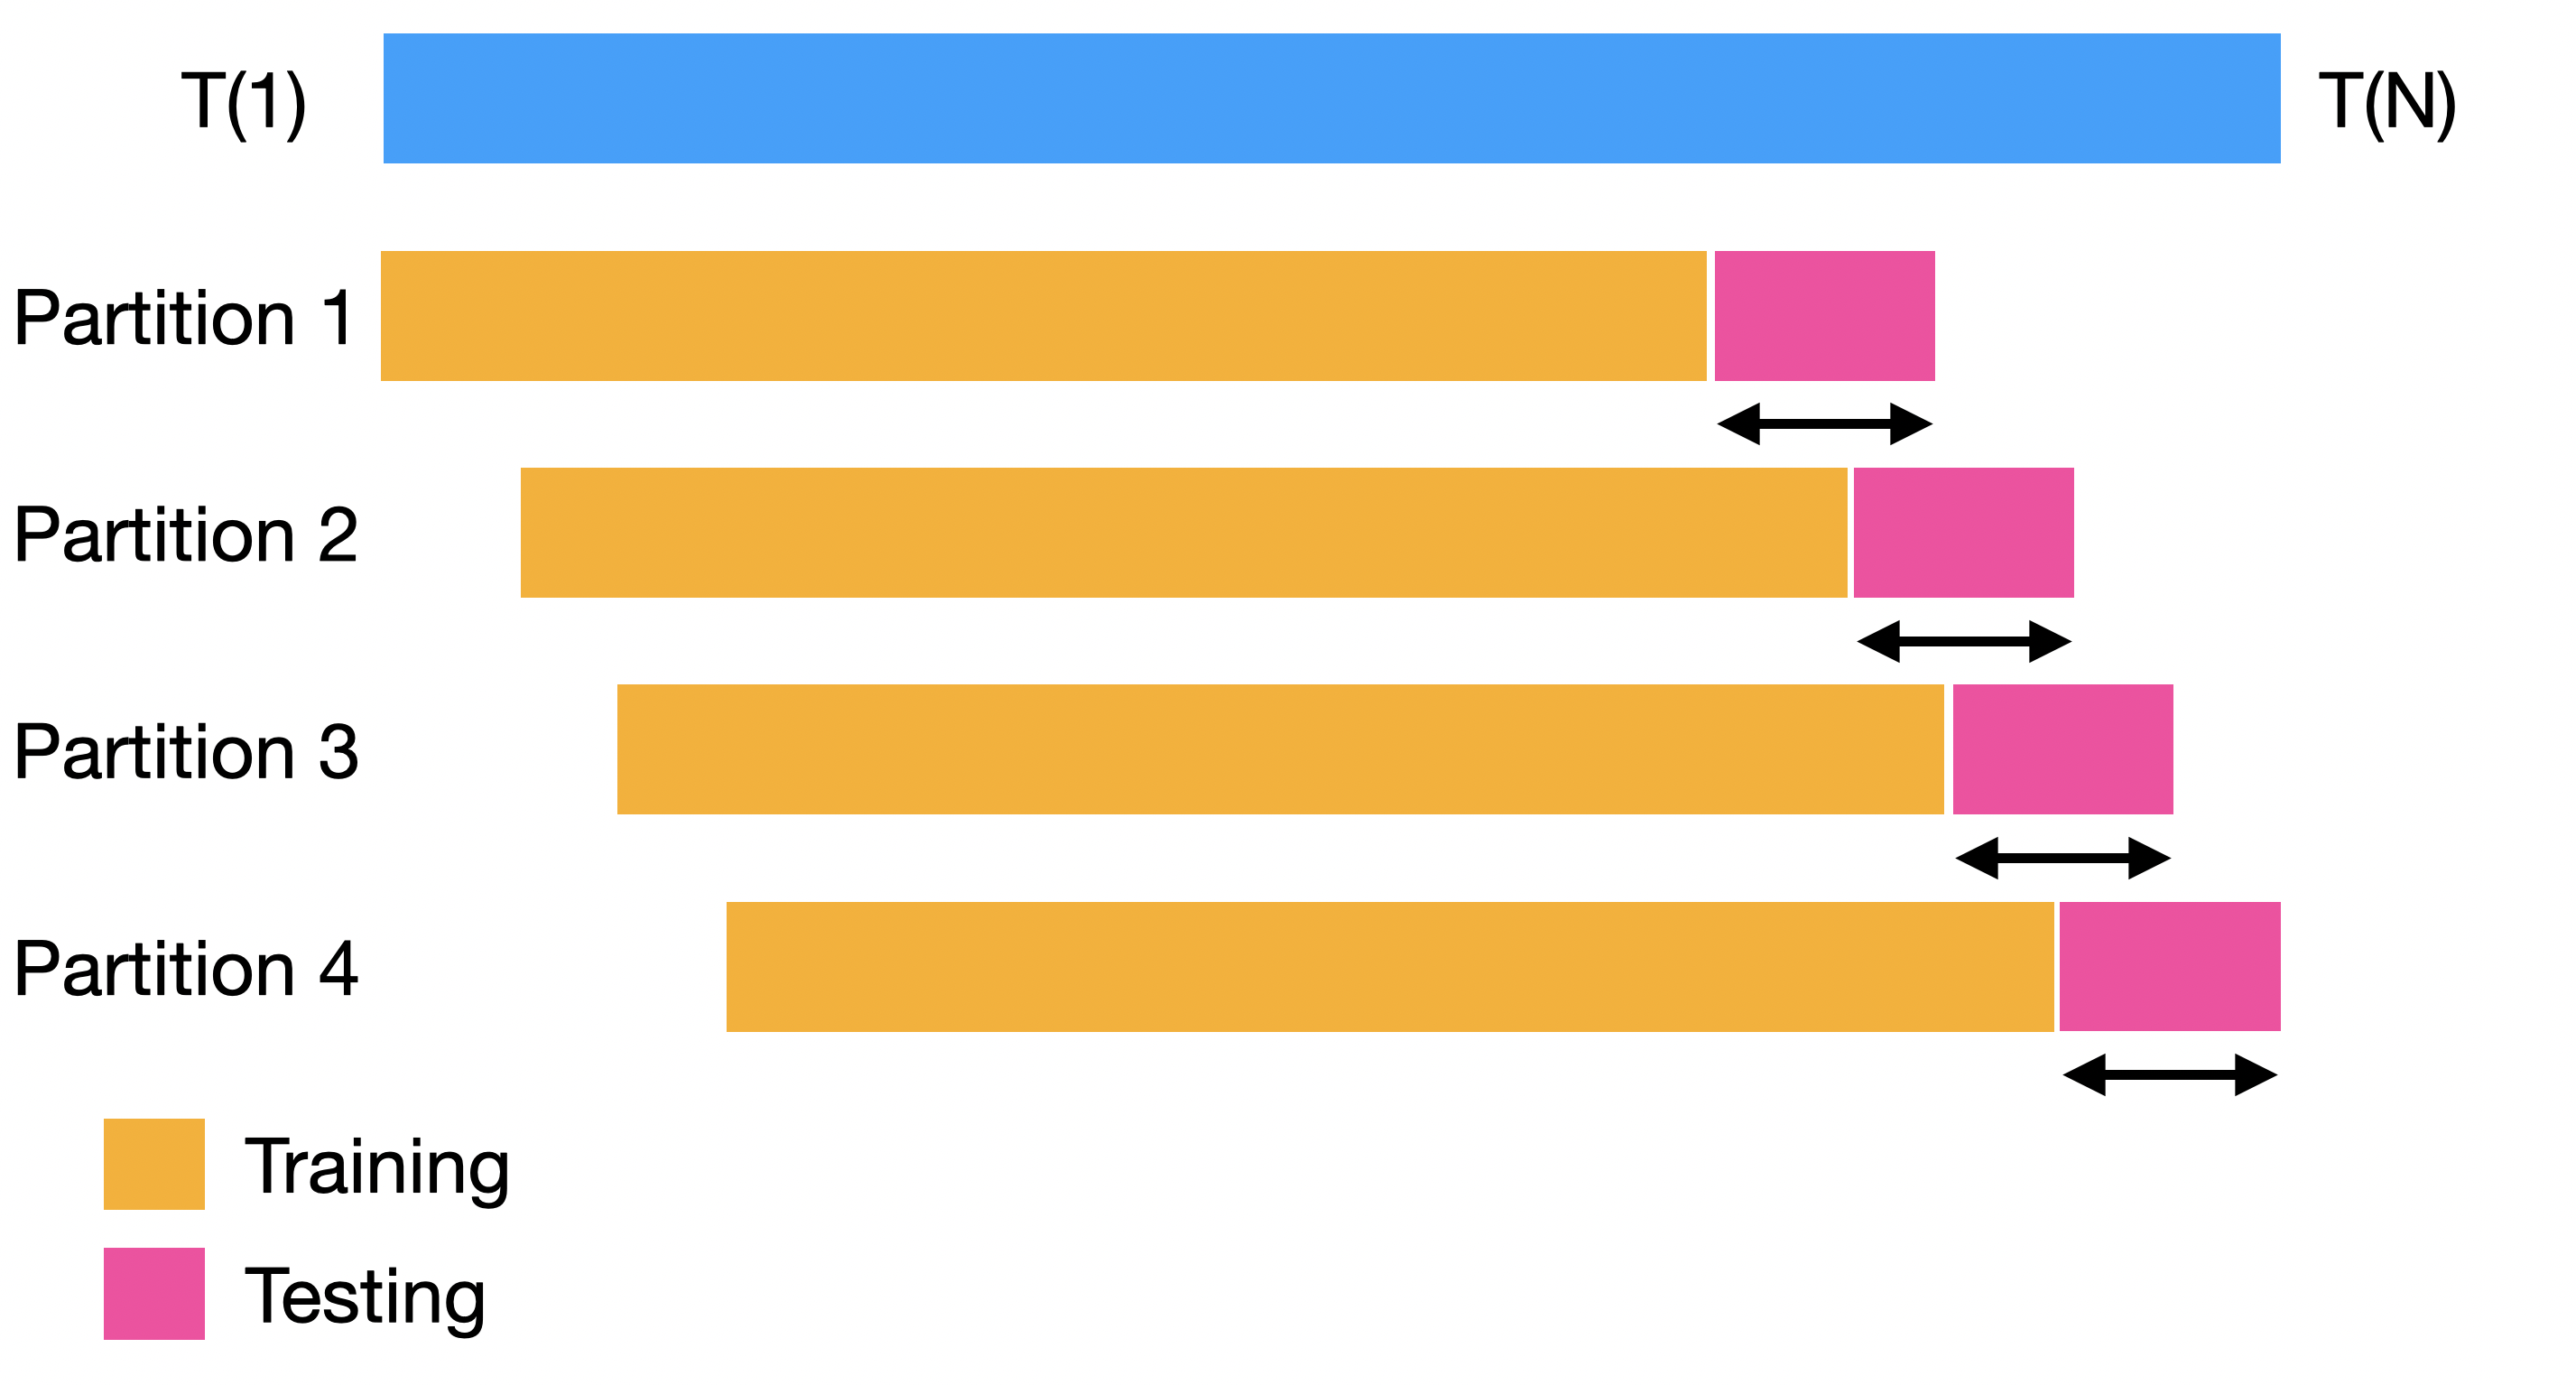
Dans les deux approches, la taille des ensembles de test reste inchangée

Concevoir des pipelines de prévision pour la production

Backtesting

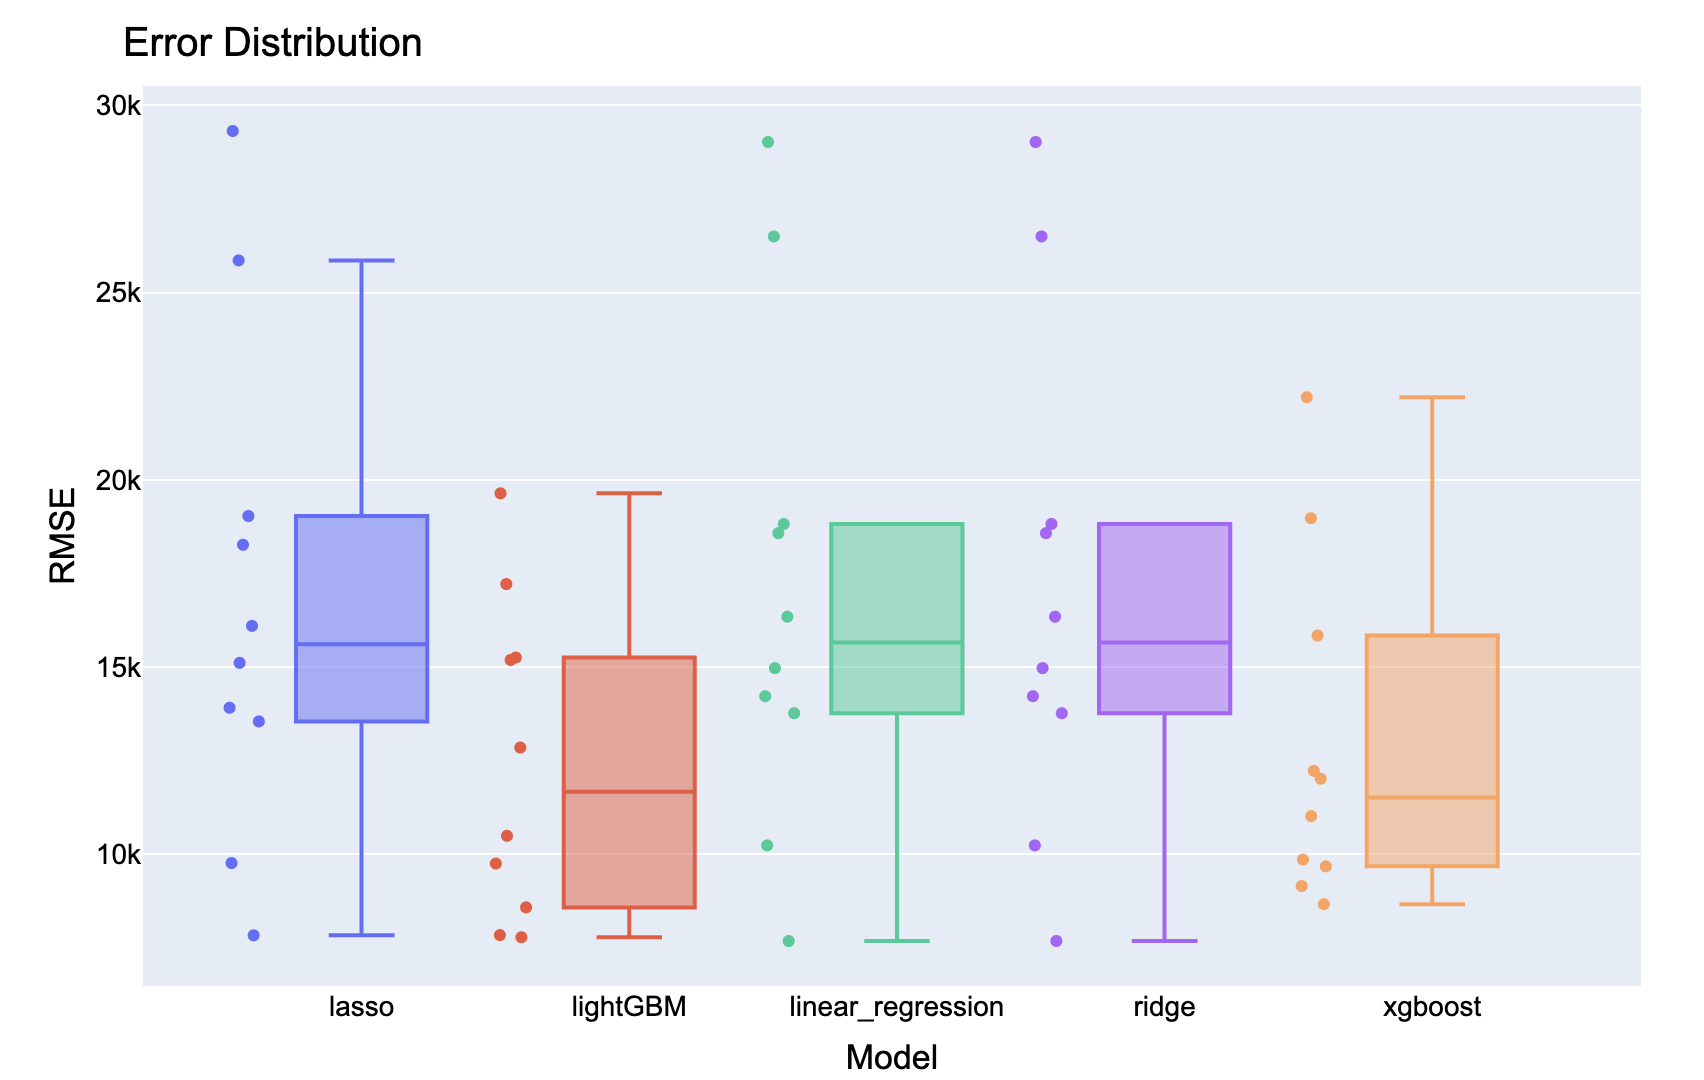
Boîtes à moustaches des scores RMSE pour cinq modèles : Lasso, LightGBM, Régression linéaire, Ridge et XGBoost

Concevoir des pipelines de prévision pour la production

Paramètres de backtesting

Modèles

  • XGBoost
  • Light Gradient-Boosting Machine
  • Ridge
  • Lasso
  • Régression linéaire
Concevoir des pipelines de prévision pour la production

Paramètres de backtesting

Paramètres des partitions
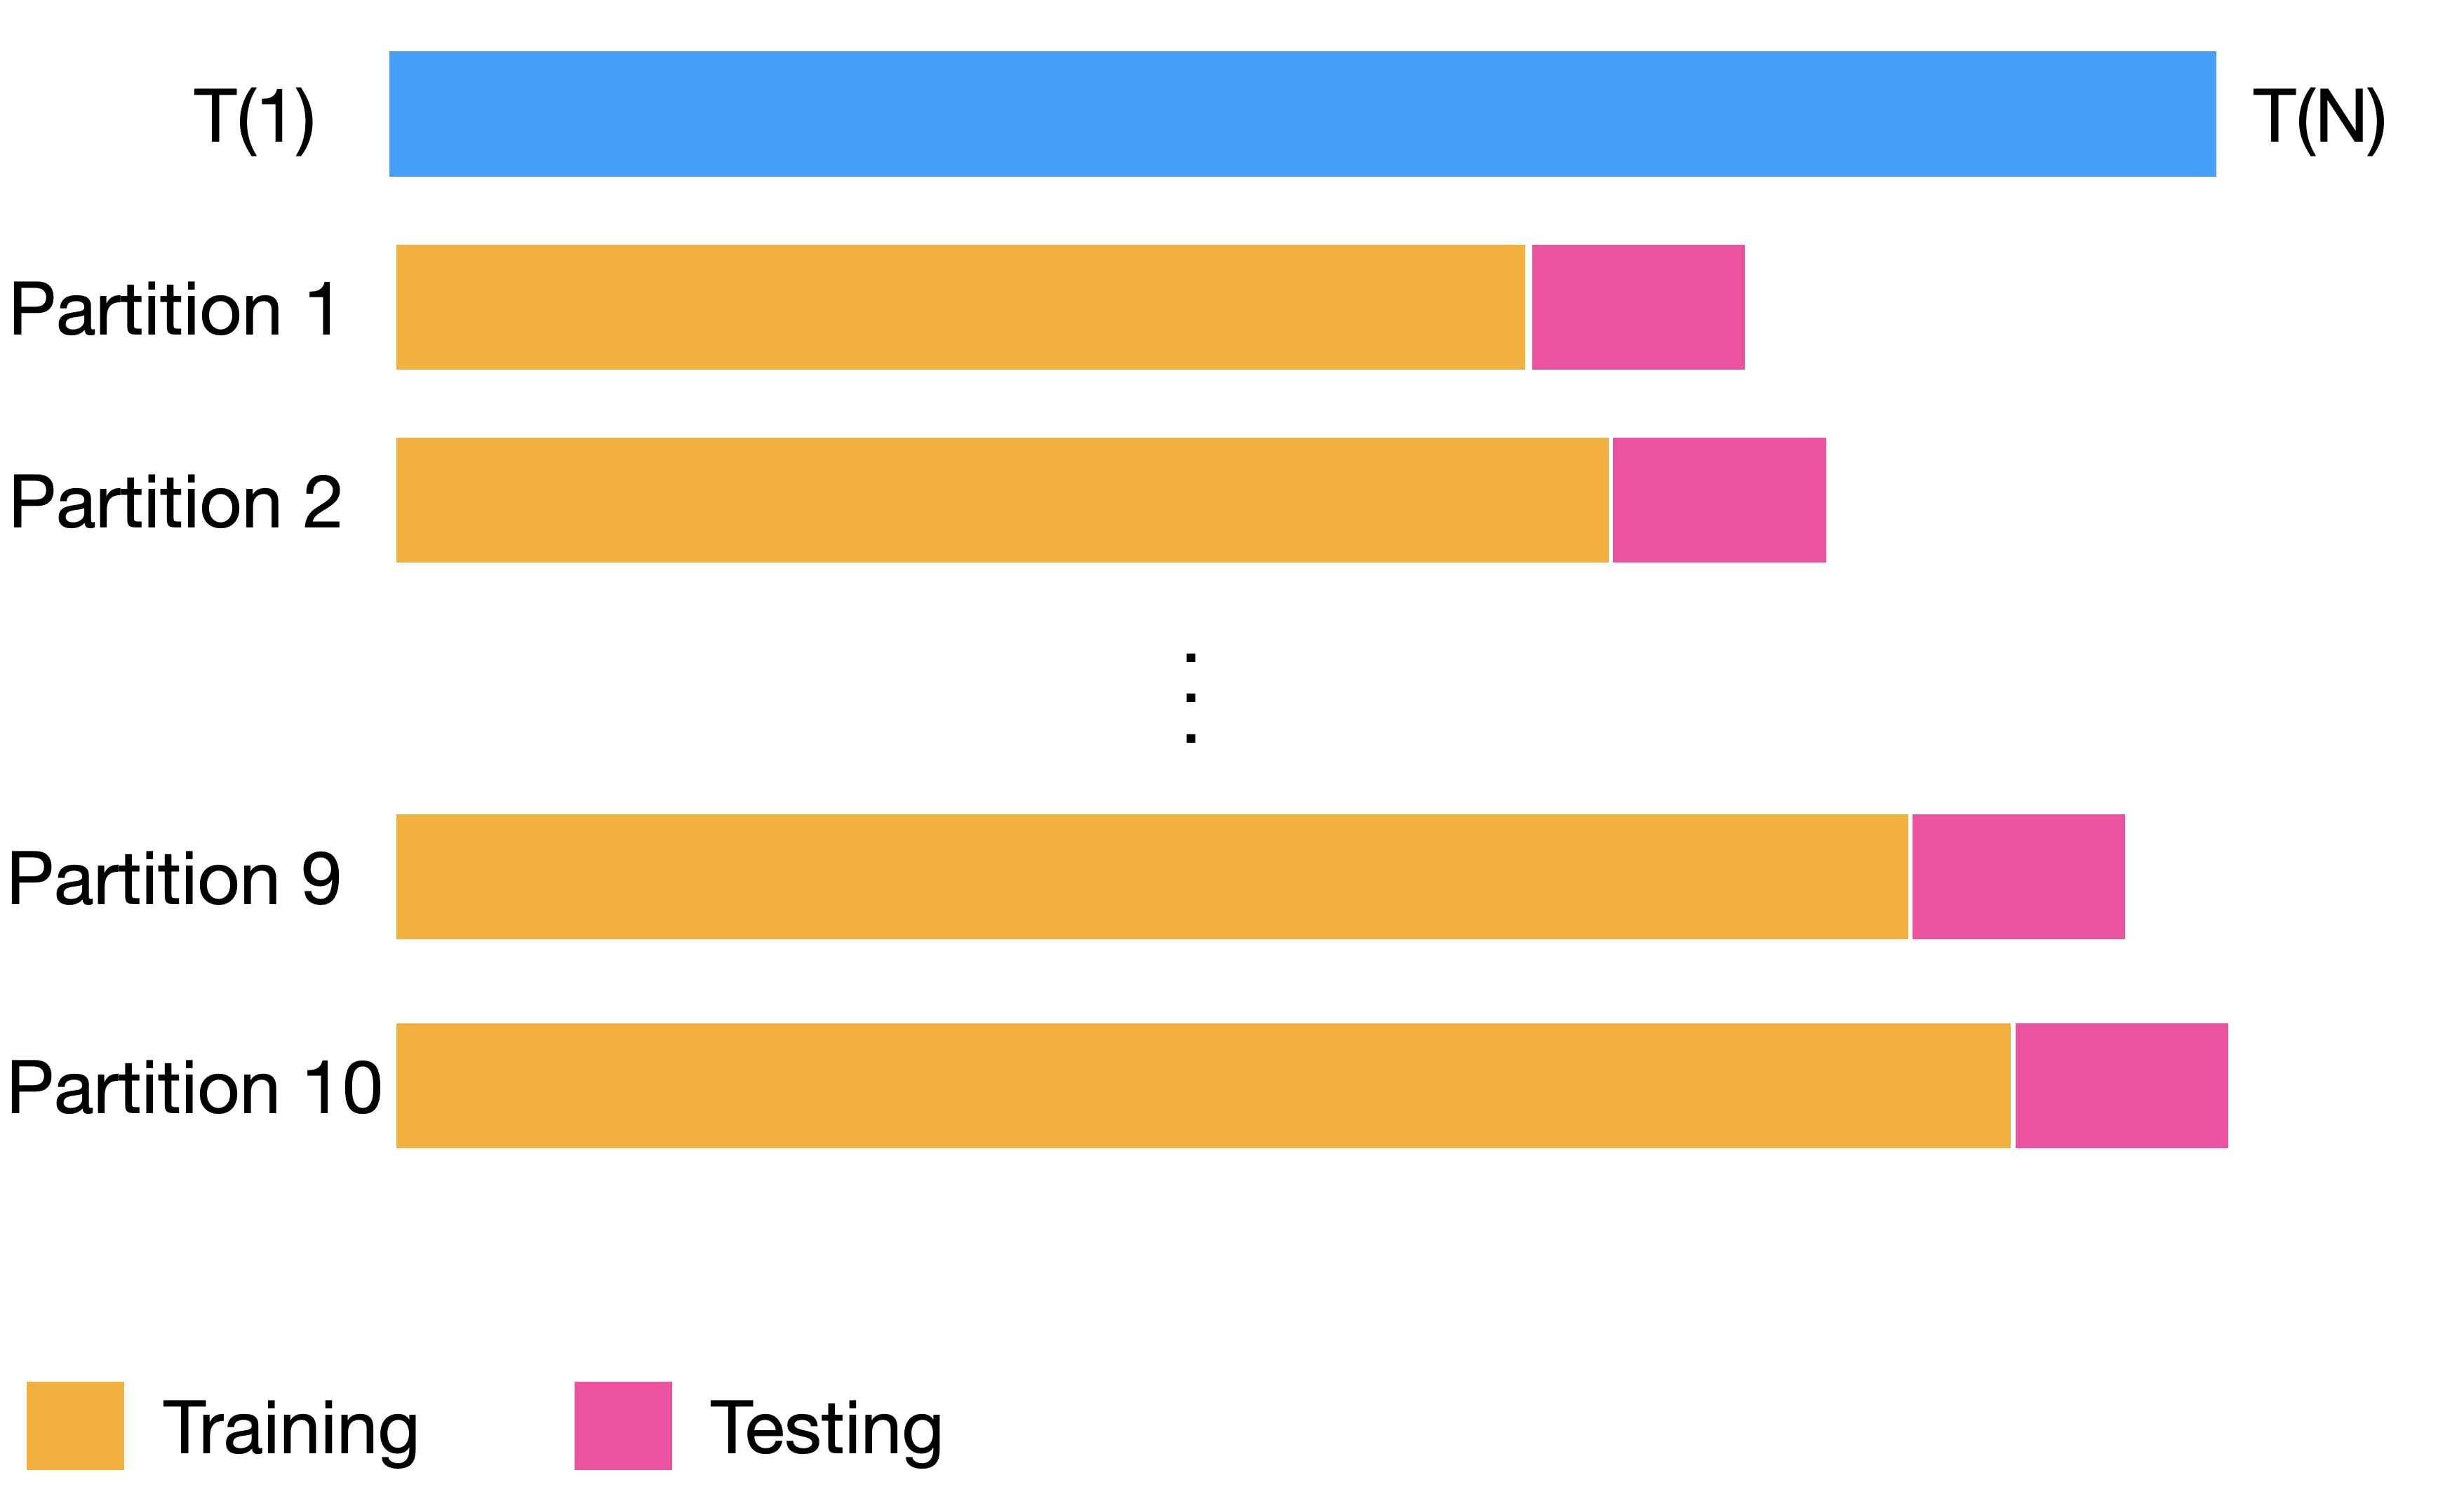
Paramètres de backtesting

Concevoir des pipelines de prévision pour la production

Paramètres de backtesting

Paramètres des partitions
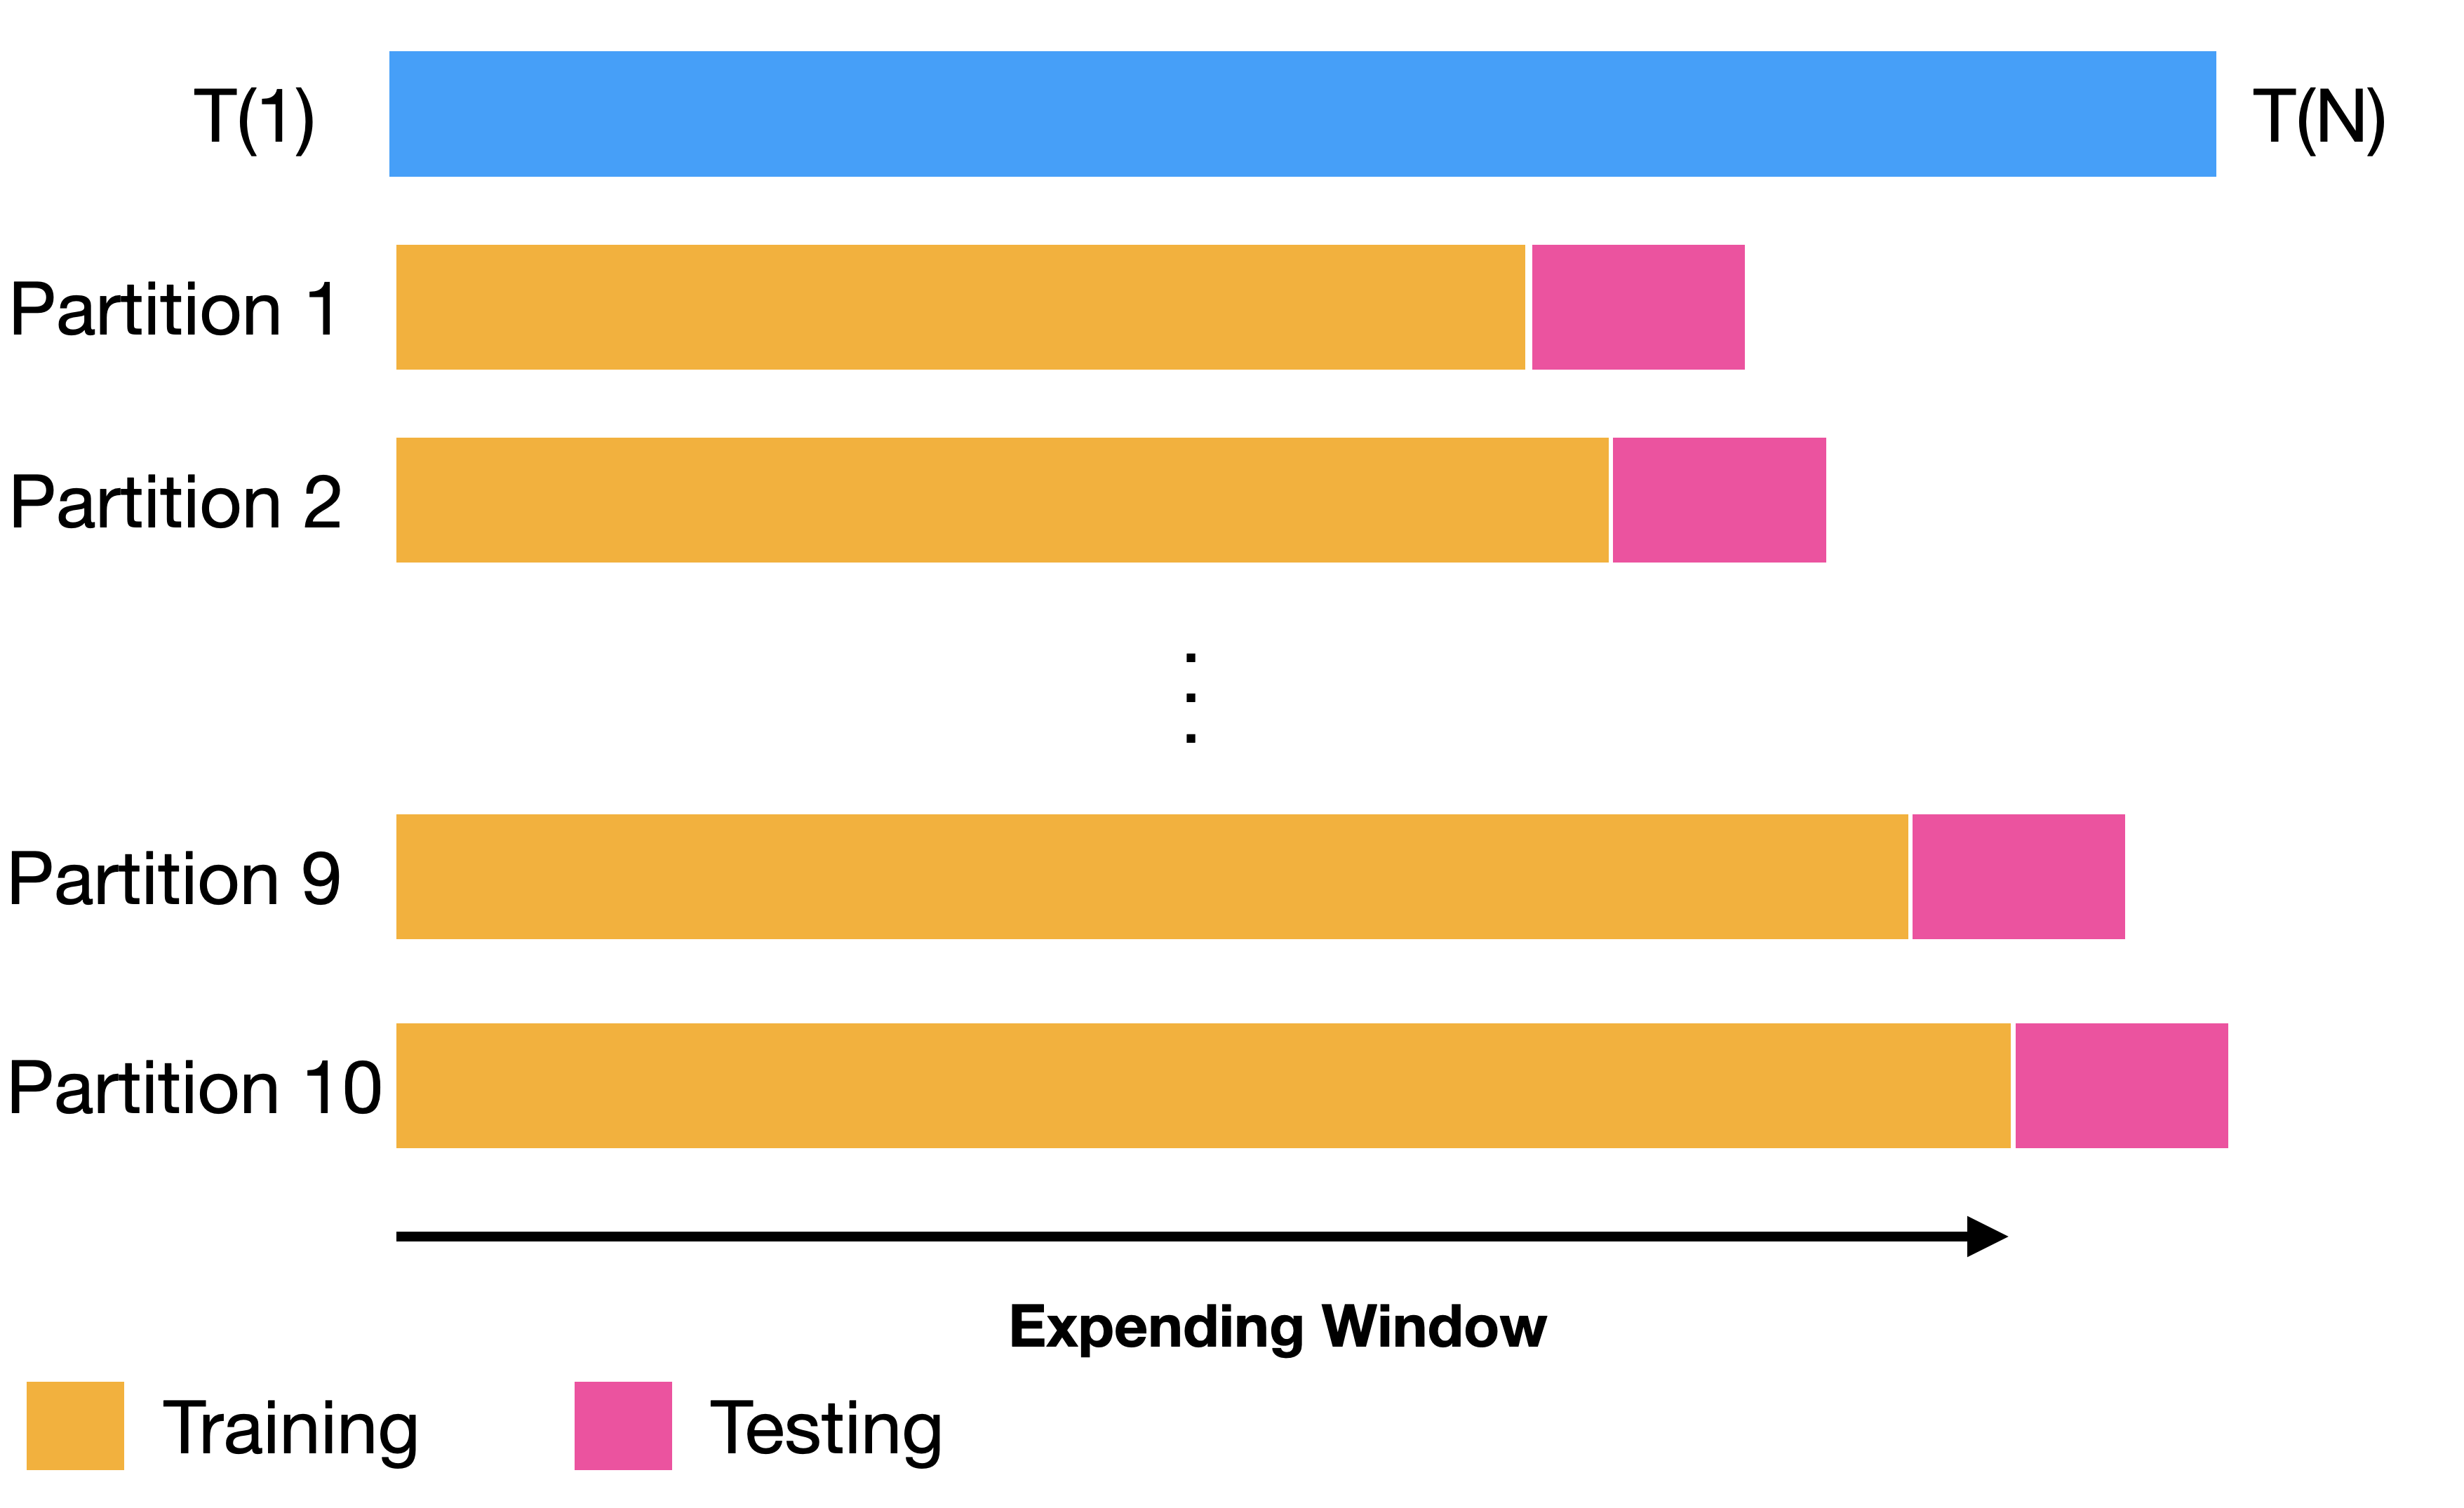
Paramètres de backtesting

Concevoir des pipelines de prévision pour la production

Paramètres de backtesting

Paramètres des partitions
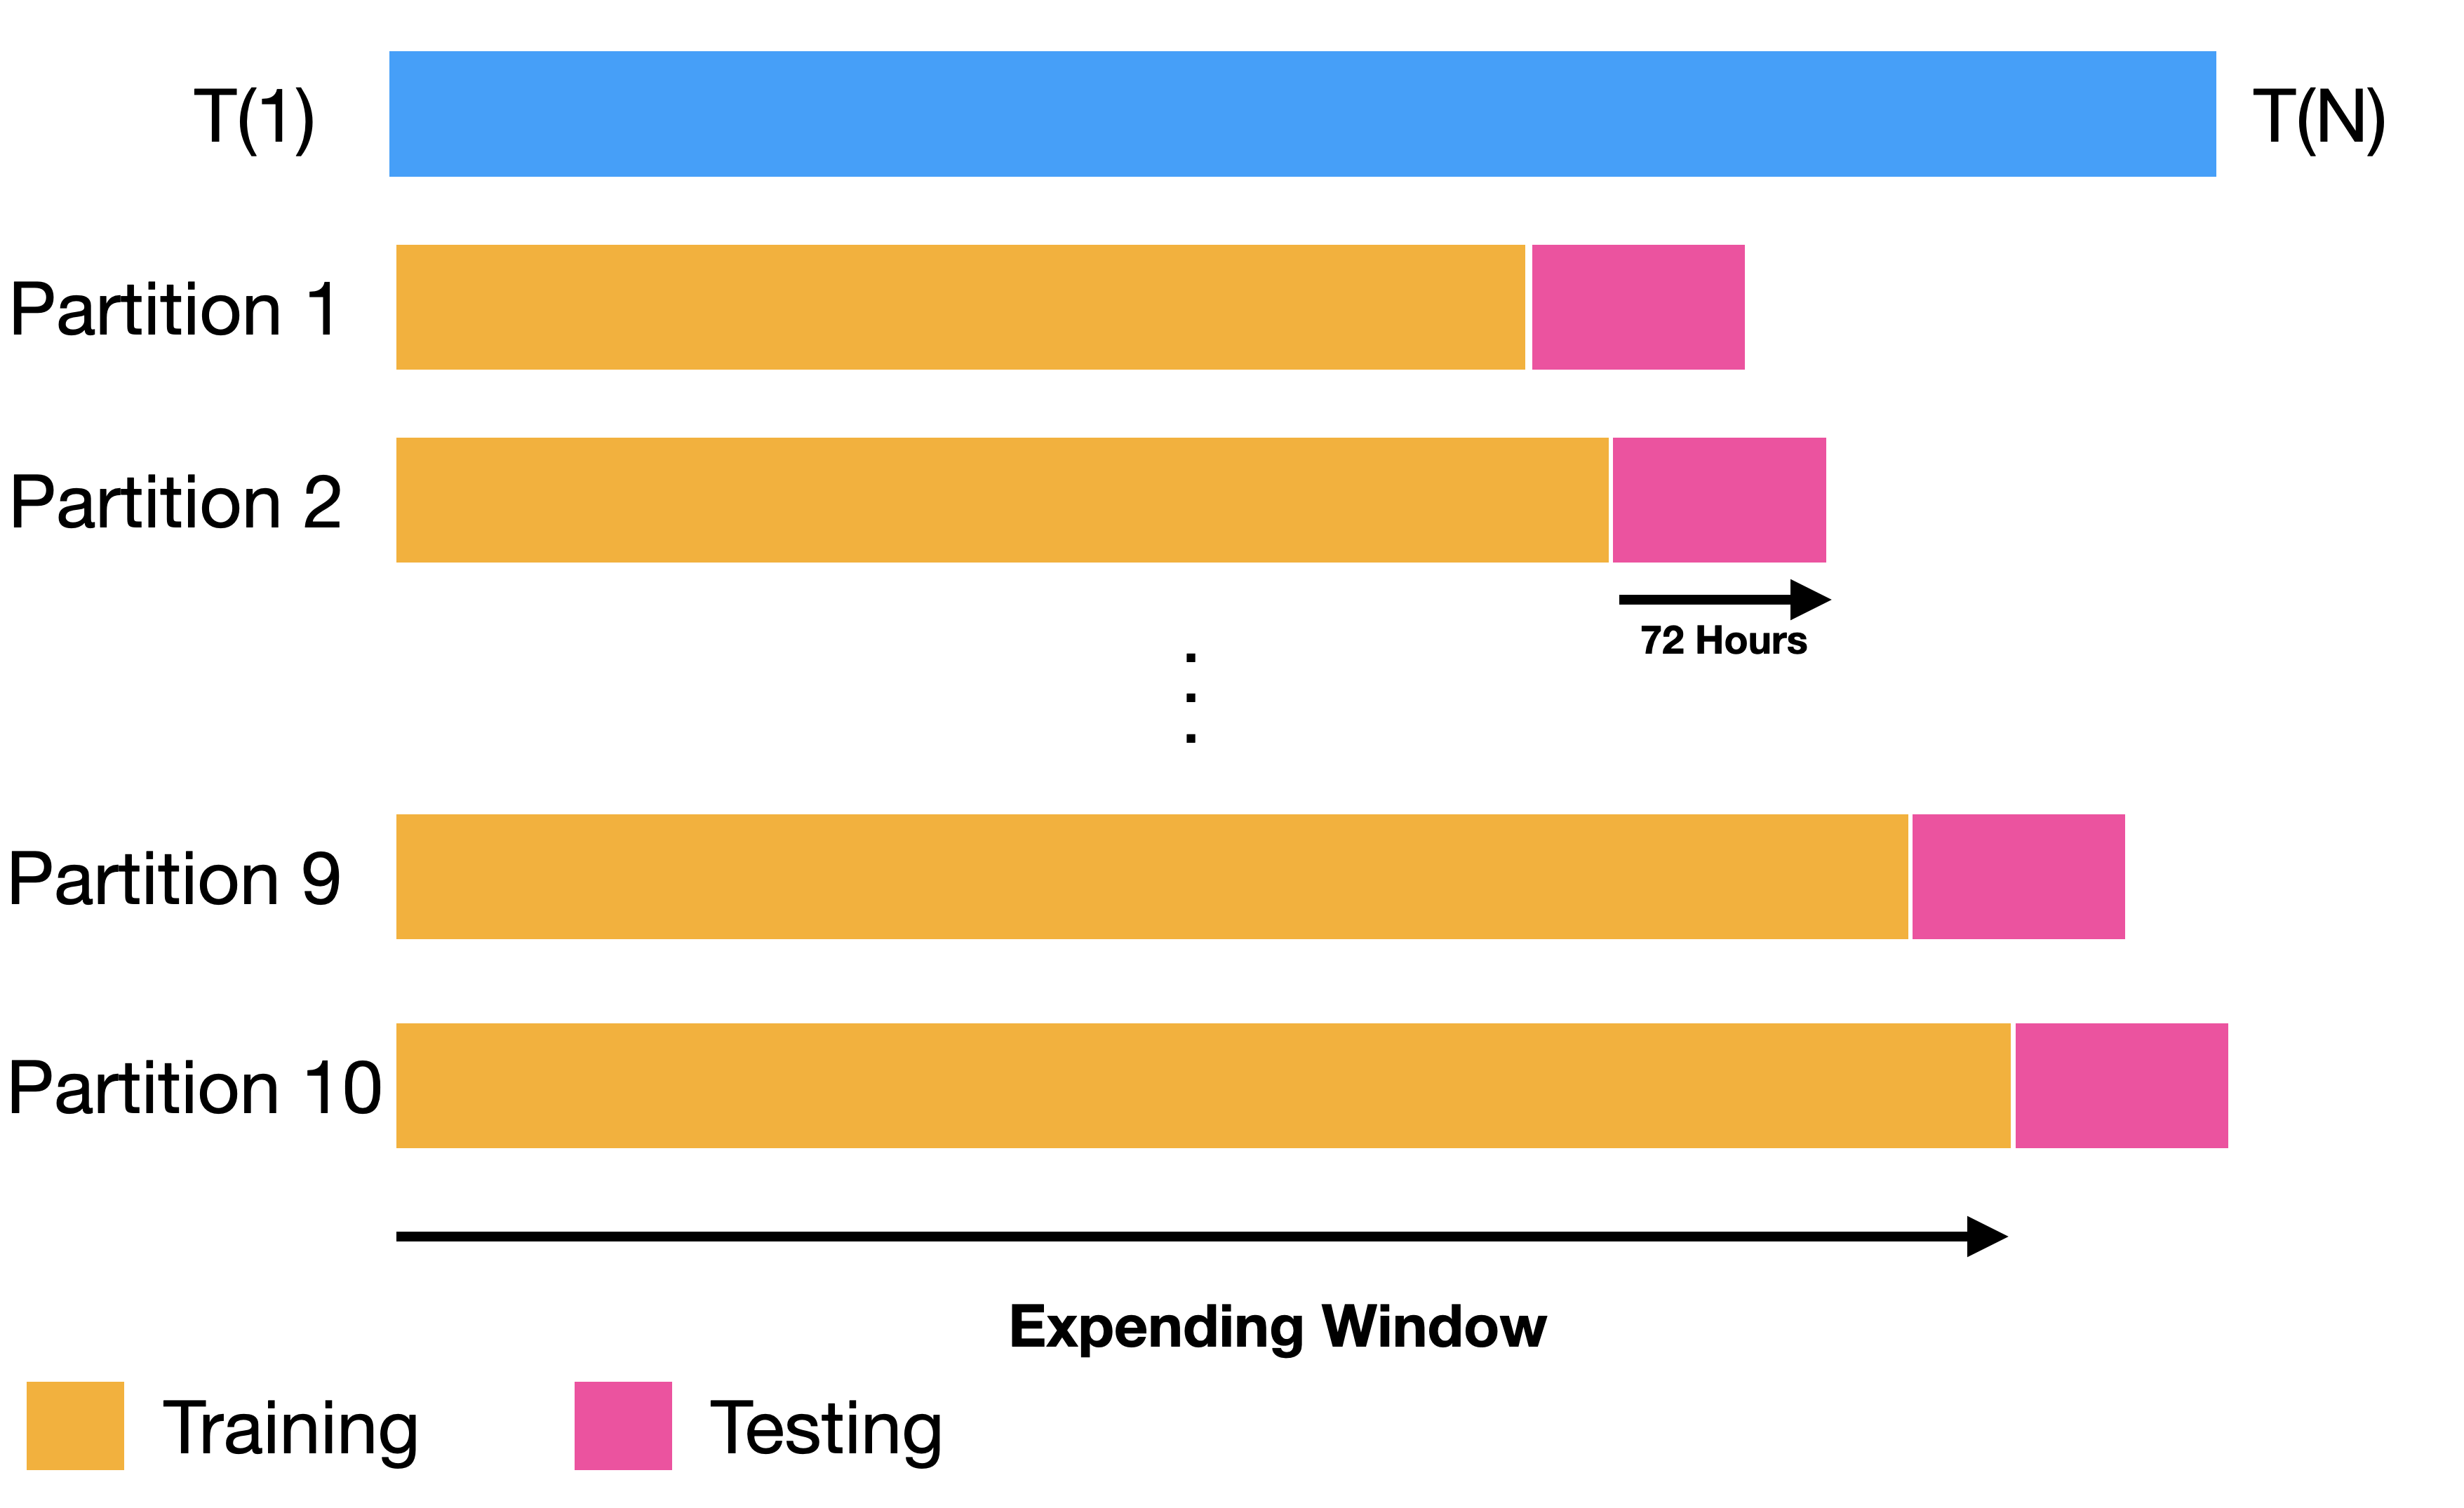
Paramètres de backtesting

Concevoir des pipelines de prévision pour la production

Paramètres de backtesting

Paramètres des partitions
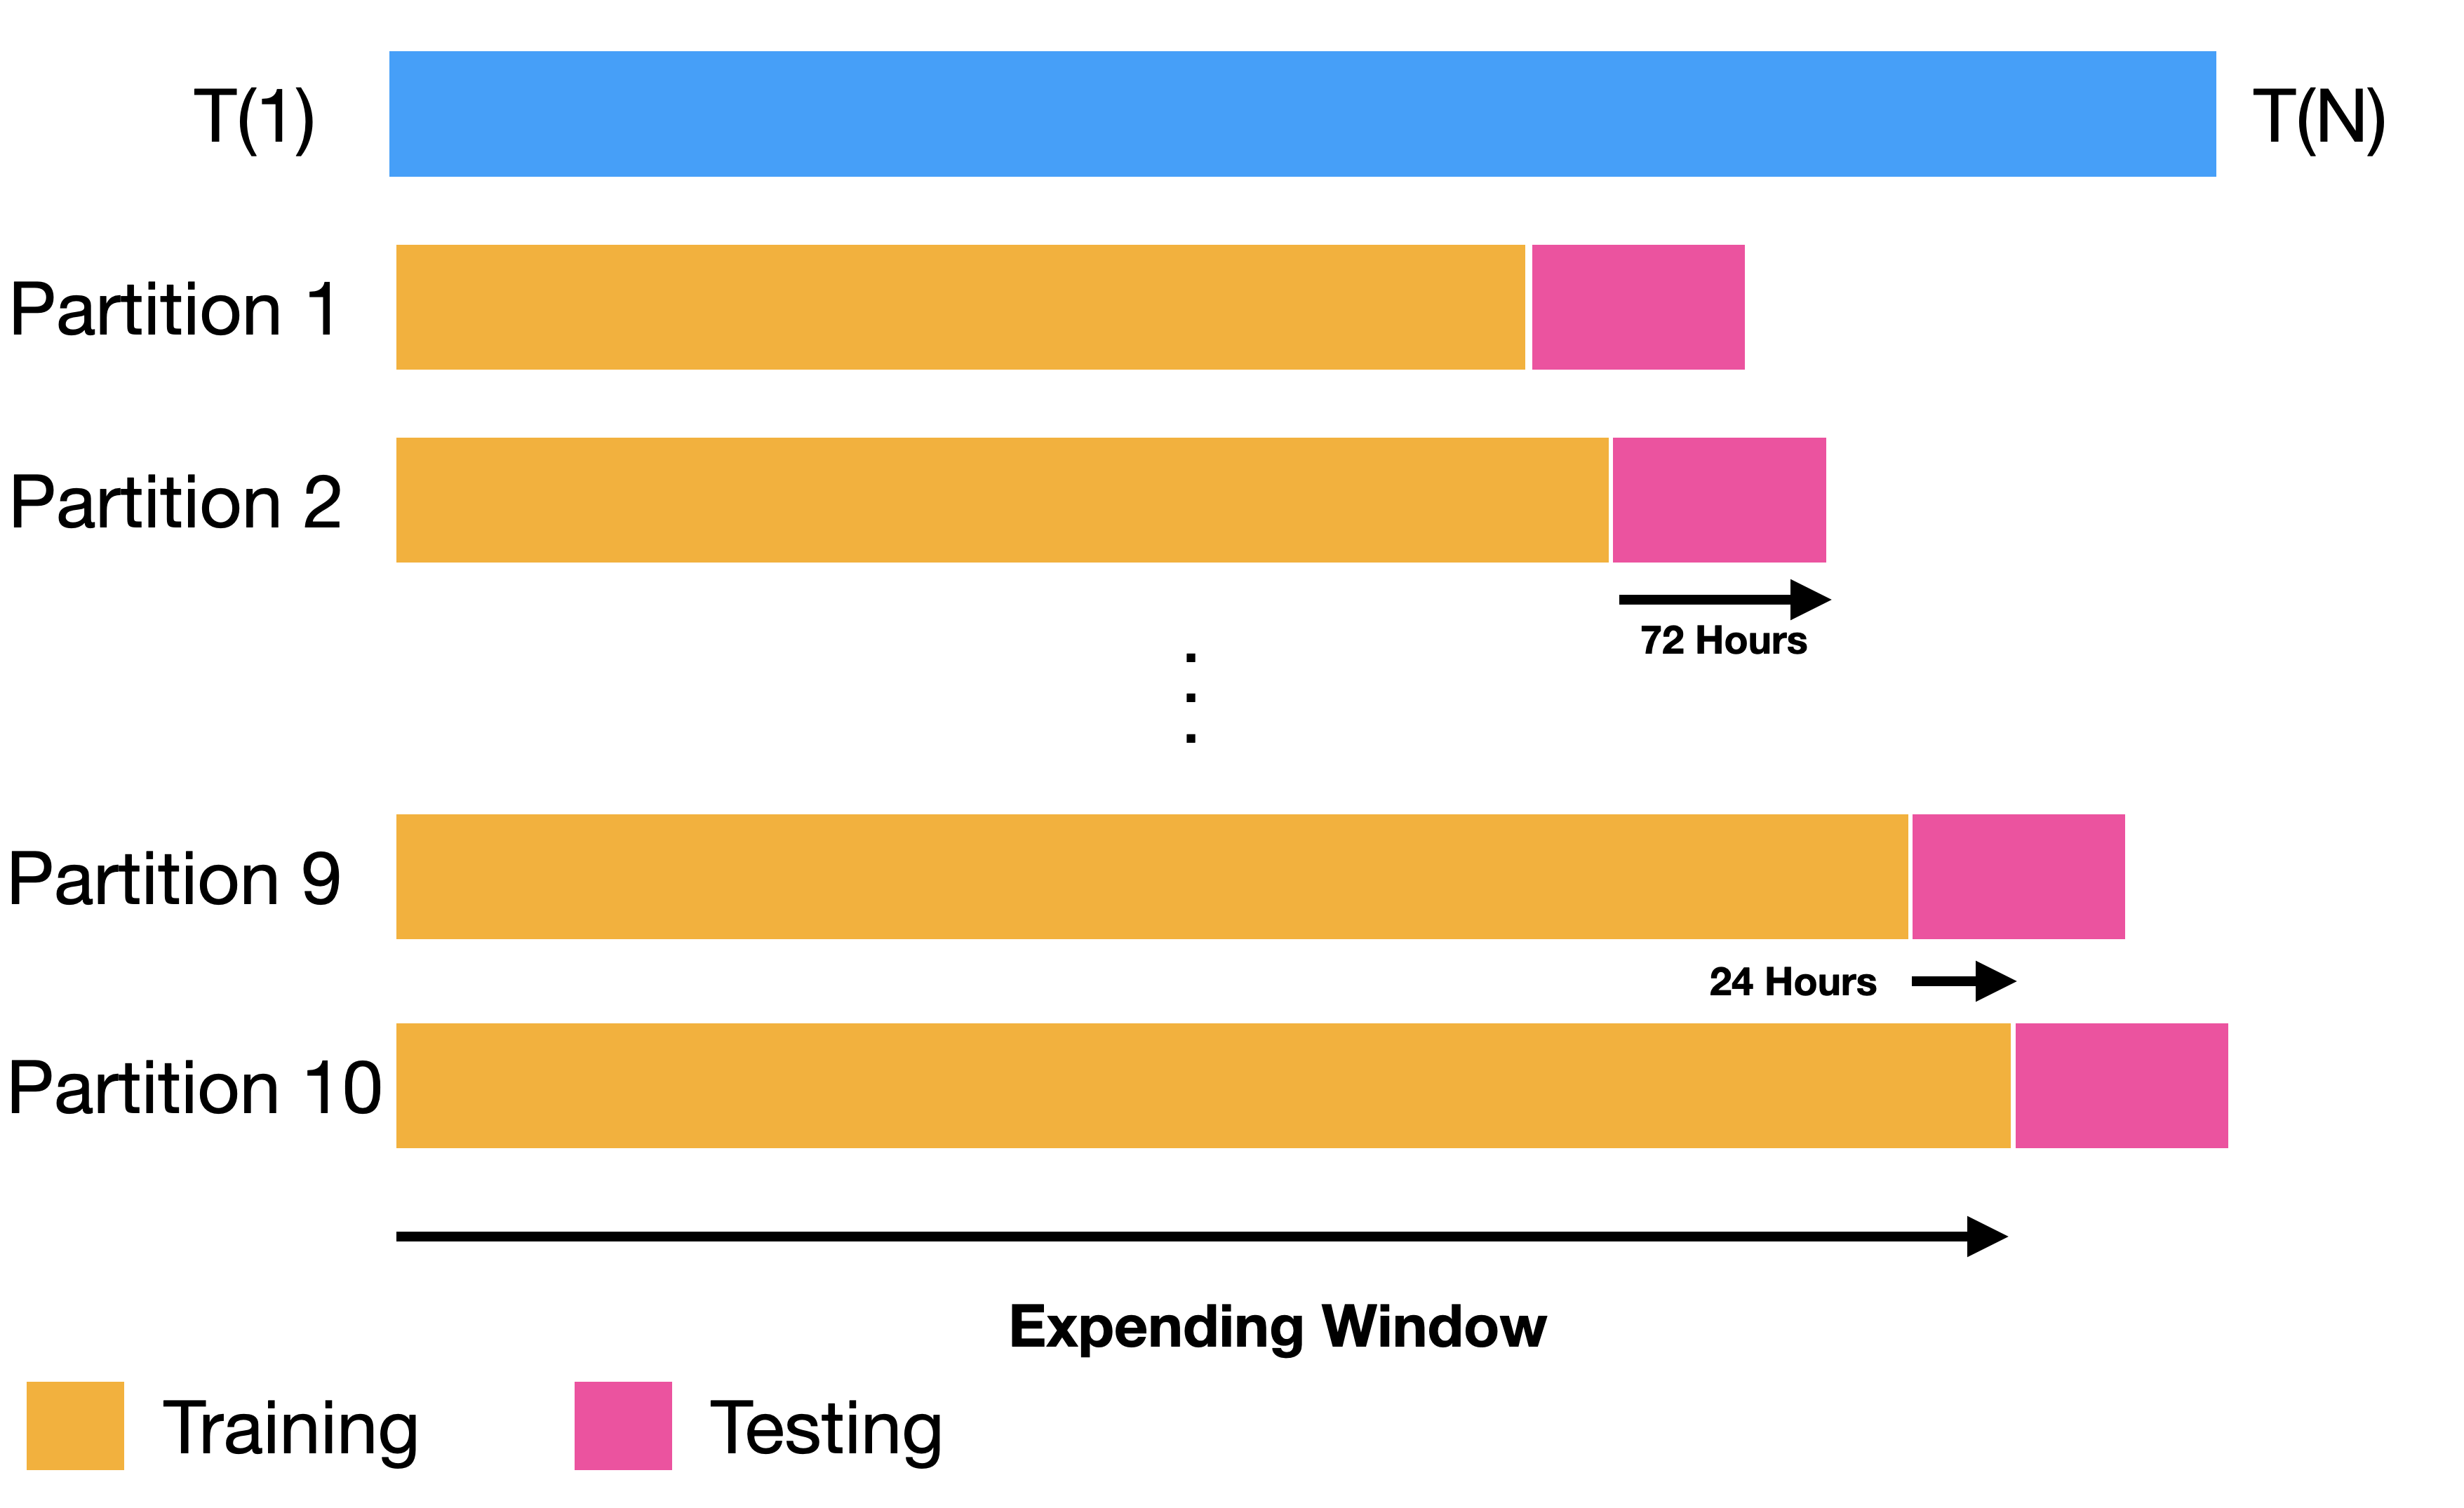
Paramètres de backtesting

Concevoir des pipelines de prévision pour la production

Paramètres de backtesting

Incertitude du modèle

  • Intervalles de prédiction conformes
    • Gèrent les modèles non paramétriques et paramétriques
  • Niveau de signification : 95 %
Concevoir des pipelines de prévision pour la production

Bibliothèques requises

from mlforecast import MLForecast
from mlforecast.target_transforms import Differences
from mlforecast.utils import PredictionIntervals
from window_ops.expanding import expanding_mean
from lightgbm import LGBMRegressor
from xgboost import XGBRegressor
from sklearn.linear_model import Lasso, LinearRegression, Ridge
from sklearn.neural_network import MLPRegressor
from sklearn.ensemble import RandomForestRegressor
from utilsforecast.plotting import plot_series


Concevoir des pipelines de prévision pour la production

Bibliothèques requises

import pandas as pd
import numpy as np
import requests
import json
import os
import datetime
from statistics import mean
Concevoir des pipelines de prévision pour la production

Préparation des données

ts = pd.read_csv("data/data.csv")
ts["ds"] = pd.to_datetime(ts["ds"])
ts = ts.sort_values("ds")
ts = ts[["unique_id", "ds", "y"]]

end = ts["ds"].max() start = end - datetime.timedelta(hours = 24 * 31 * 25) ts = ts[ts["ds"] >= start]
os.environ['NIXTLA_ID_AS_COL'] = '1'
Concevoir des pipelines de prévision pour la production

Définir les modèles de prévision

ml_models = {
    "lightGBM": LGBMRegressor(n_estimators=500, verbosity=-1),
    "xgboost": XGBRegressor(),
    "linear_regression": LinearRegression(),
    "lasso": Lasso(),
    "ridge": Ridge()
}

mlf = MLForecast( models= ml_models, freq='h', lags=list(range(1, 24)), date_features=["month", "day", "dayofweek", "week", "hour"])
Concevoir des pipelines de prévision pour la production

Définir les paramètres du backtesting

Paramètres des fenêtres

partitions = 10  
step_size = 24  
h = 72

Paramètres des intervalles de prédiction

n_windows = 5
method = "conformal_distribution"
pi = PredictionIntervals(h=h, n_windows = n_windows , method = method)
levels = [95]
Concevoir des pipelines de prévision pour la production

Entraîner les modèles avec backtesting

bkt_df = mlf.cross_validation(
        df = ts,
        h = h,
        step_size = step_size,
        n_windows = partitions,
        prediction_intervals = pi, 
        level = levels)
Concevoir des pipelines de prévision pour la production

Entraîner les modèles avec backtesting

print(bkt_df.head())
     unique_id    ds                     cutoff                 y            lightGBM         
0    1            2024-04-22 00:00:00    2024-04-21 23:00:00    421082.60    421089.155837    
1    1            2024-04-22 01:00:00    2024-04-21 23:00:00    429728.30    425700.453391    
2    1            2024-04-22 02:00:00    2024-04-21 23:00:00    430690.96    424382.613668    
3    1            2024-04-22 03:00:00    2024-04-21 23:00:00    420094.58    409967.877157    
4    1            2024-04-22 04:00:00    2024-04-21 23:00:00    403292.36    393175.446116    
Concevoir des pipelines de prévision pour la production

Résultats du backtesting au format large
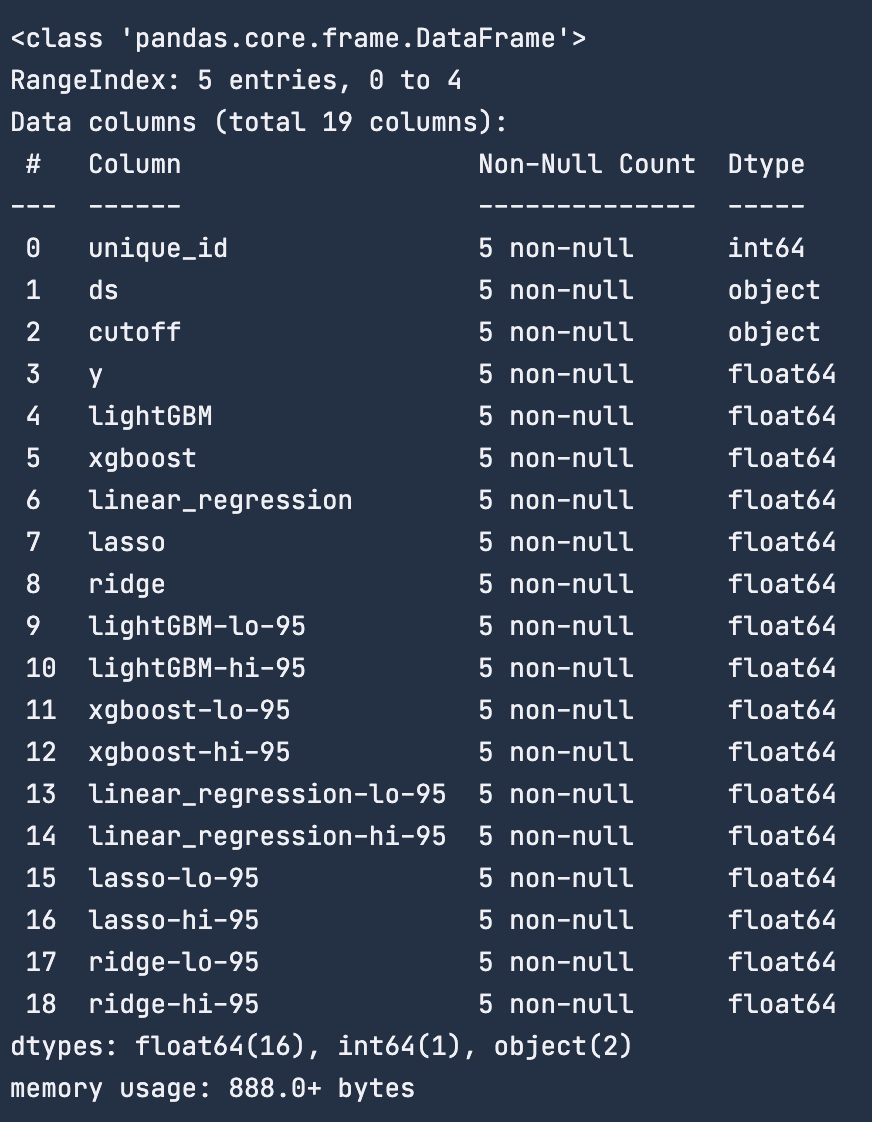
Informations sur le DataFrame bkt_df, contenant 19 colonnes dont l'identifiant unique, ds, y et les valeurs des modèles

Concevoir des pipelines de prévision pour la production

Passons à la pratique !

Concevoir des pipelines de prévision pour la production

Preparing Video For Download...