Datenaufbereitung für Clusteranalyse

Cluster Analysis in Python

Shaumik Daityari

Business Analyst

Warum Daten fürs Clustering vorbereiten?

  • Variablen haben nicht vergleichbare Einheiten (Produktmaße in cm, Preis in $)
  • Gleiche Einheit, aber sehr unterschiedliche Skalen/Varianzen (Ausgaben für Müsli, Reisen)
  • Rohdaten können Clustering verzerren
  • Cluster können stark von einer Variable abhängen
  • Lösung: Normalisierung einzelner Variablen
Cluster Analysis in Python

Normalisierung von Daten

Normalisierung: Daten auf eine Standardabweichung von 1 skalieren

x_new = x / std_dev(x)

from scipy.cluster.vq import whiten
data = [5, 1, 3, 3, 2, 3, 3, 8, 1, 2, 2, 3, 5]
scaled_data = whiten(data)
print(scaled_data)
[2.73, 0.55, 1.64, 1.64, 1.09, 1.64, 1.64, 4.36, 0.55, 1.09, 1.09, 1.64, 2.73]
Cluster Analysis in Python

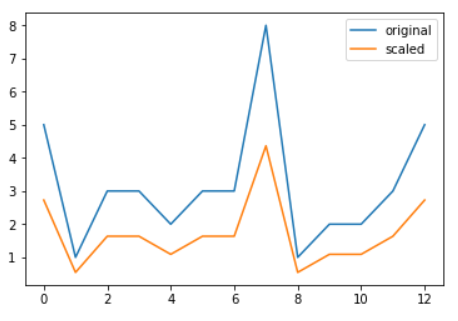
Beispiel: Normalisierung von Daten

# Import plotting library
from matplotlib import pyplot as plt

# Initialize original, scaled data
plt.plot(data, 
         label="original")
plt.plot(scaled_data, 
         label="scaled")
# Show legend and display plot
plt.legend()
plt.show()

Cluster Analysis in Python

Als Nächstes: ein paar DIY-Übungen

Cluster Analysis in Python

Preparing Video For Download...