Dokumenten-Clustering

Cluster Analysis in Python

Shaumik Daityari

Business Analyst

Dokumenten-Clustering: Konzepte

  1. Daten vorverarbeiten
  2. Wichtigkeit der Terme im Dokument bestimmen (in TF-IDF-Matrix)
  3. TF-IDF-Matrix clustern
  4. Top-Terme und -Dokumente je Cluster finden
Cluster Analysis in Python

Daten bereinigen und tokenisieren

  • Text in kleinere Einheiten (Tokens) umwandeln, Daten zum Verarbeiten bereinigen
from nltk.tokenize import word_tokenize
import re

def remove_noise(text, stop_words = []):
    tokens = word_tokenize(text)

cleaned_tokens = [] for token in tokens: token = re.sub('[^A-Za-z0-9]+', '', token)
if len(token) > 1 and token.lower() not in stop_words: # Get lowercase cleaned_tokens.append(token.lower()) return cleaned_tokens
remove_noise("It is lovely weather we are having. I hope the weather continues.")
['lovely', 'weather', 'hope', 'weather', 'continues']
Cluster Analysis in Python

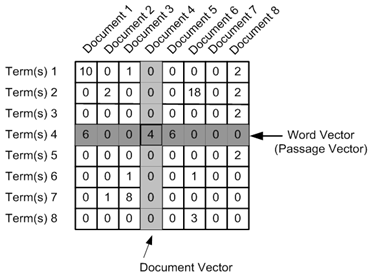
Dokument-Term-Matrix und Sparse-Matrizen

  • Dokument-Term-Matrix erstellt
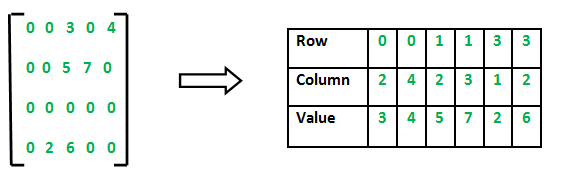
  • Die meisten Elemente sind Nullen

Quelle

  • Sparse-Matrix wird erstellt

Quelle

Cluster Analysis in Python

TF-IDF (Term Frequency – Inverse Document Frequency)

  • Gewichtetes Maß: bewertet, wie wichtig ein Wort für ein Dokument in einer Sammlung ist
from sklearn.feature_extraction.text import TfidfVectorizer

tfidf_vectorizer = TfidfVectorizer(max_df=0.8, max_features=50, min_df=0.2, tokenizer=remove_noise)
tfidf_matrix = tfidf_vectorizer.fit_transform(data)
Cluster Analysis in Python

Clustering mit Sparse-Matrix

  • kmeans() in SciPy unterstützt keine Sparse-Matrizen
  • Mit .todense() in eine dichte Matrix umwandeln
cluster_centers, distortion = kmeans(tfidf_matrix.todense(), num_clusters)
Cluster Analysis in Python

Top-Terme pro Cluster

  • Clusterzentren: Listen mit Größe = Anzahl der Terme
  • Jeder Wert im Zentrum = Wichtigkeit
  • Wörterbuch erstellen und Top-Terme ausgeben
terms = tfidf_vectorizer.get_feature_names_out()

for i in range(num_clusters):
    center_terms = dict(zip(terms, list(cluster_centers[i])))

sorted_terms = sorted(center_terms, key=center_terms.get, reverse=True)
print(sorted_terms[:3])
['room', 'hotel', 'staff']

['bad', 'location', 'breakfast']
Cluster Analysis in Python

Weitere Hinweise

  • Mit Hyperlinks, Emoticons etc. umgehen
  • Wörter normalisieren (run, ran, running -> run)
  • .todense() ist bei großen Datensätzen evtl. ungeeignet
Cluster Analysis in Python

Als Nächstes: Übungen!

Cluster Analysis in Python

Preparing Video For Download...