Grundlagen des k-means-Clustering

Cluster Analysis in Python

Shaumik Daityari

Business Analyst

Warum k-means-Clustering?

  • Ein wesentlicher Nachteil des hierarchischen Clusterings: Laufzeit
  • K-means ist bei großen Datensätzen deutlich schneller
Cluster Analysis in Python

Schritt 1: Clusterzentren erzeugen

kmeans(obs, k_or_guess, iter, thresh, check_finite)
  • obs: standardisierte Beobachtungen
  • k_or_guess: Anzahl Cluster
  • iter: Anzahl Iterationen (Standard: 20)
  • thres: Schwellwert (Standard: 1e-05)
  • check_finite: prüft, ob Beobachtungen nur endliche Werte enthalten (Standard: True)

Gibt zwei Objekte zurück: Clusterzentren, Verzerrung

Cluster Analysis in Python

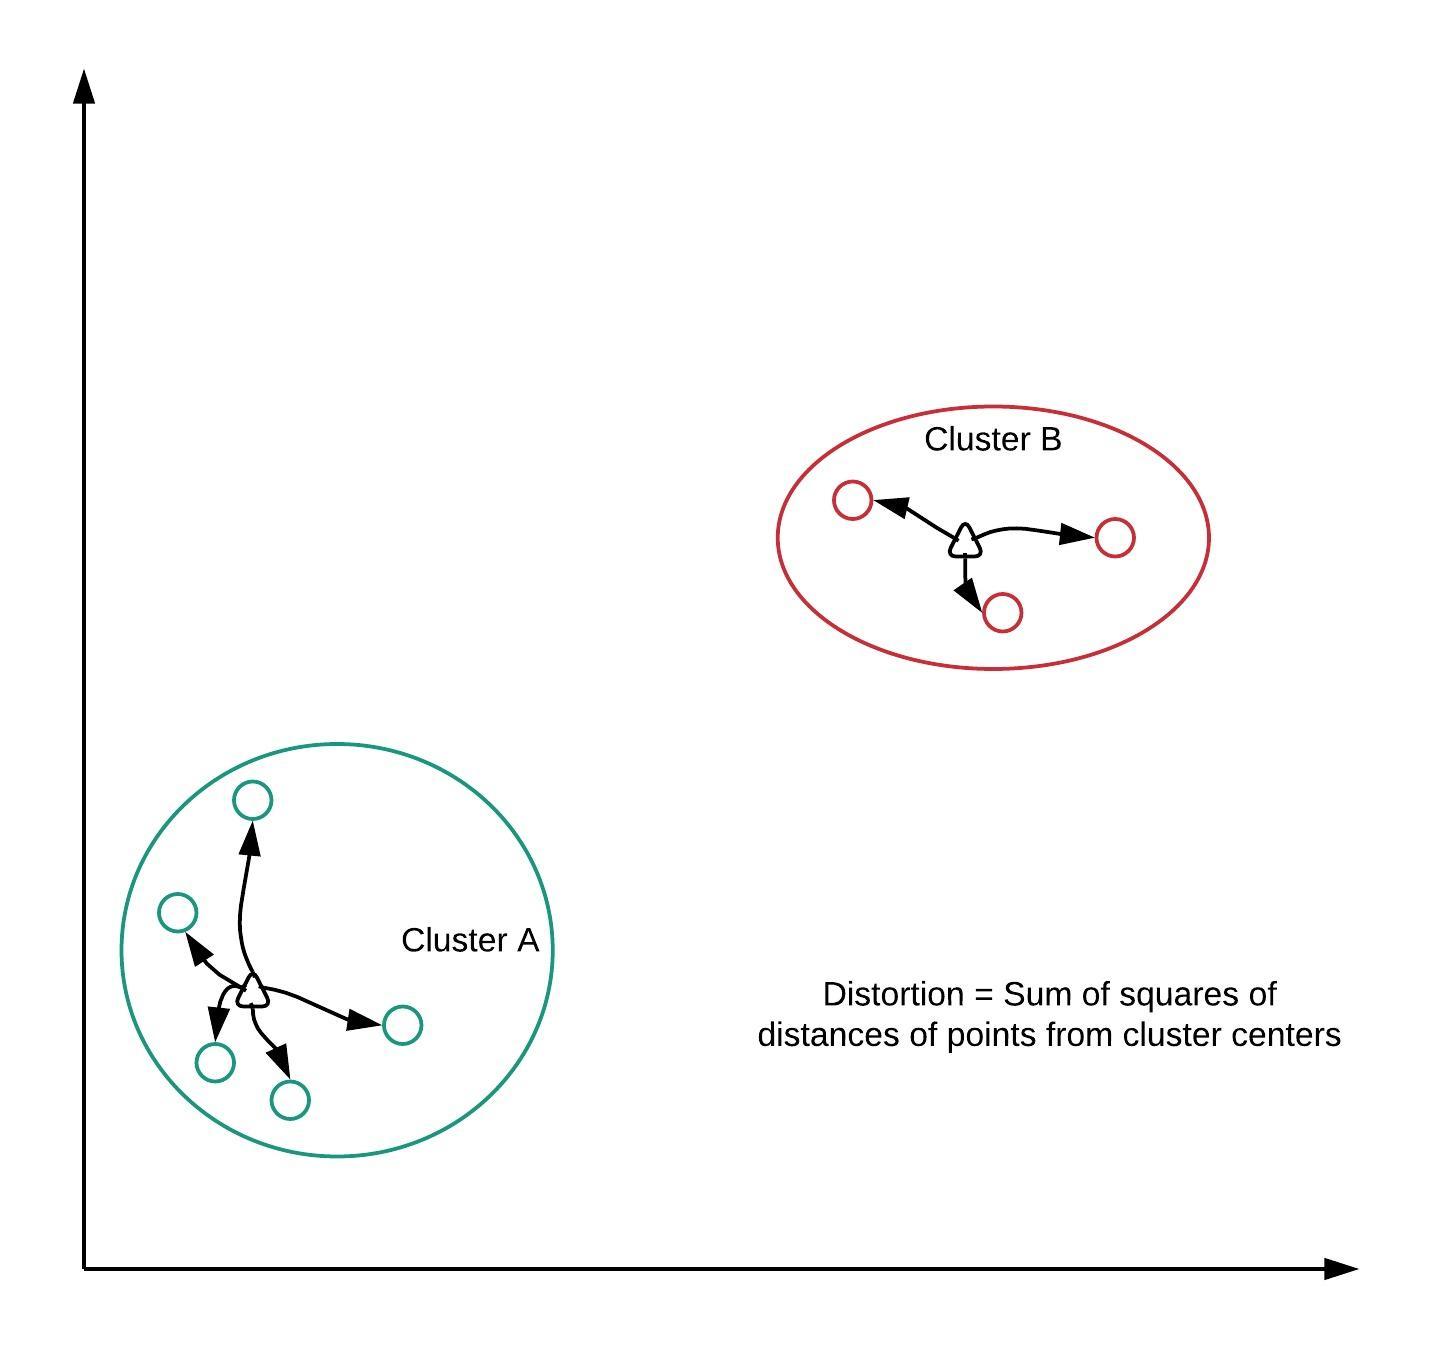
Wie wird die Verzerrung berechnet?

Cluster Analysis in Python

Schritt 2: Clusterlabels erzeugen

vq(obs, code_book, check_finite=True)
  • obs: standardisierte Beobachtungen
  • code_book: Clusterzentren
  • check_finite: prüft, ob Beobachtungen nur endliche Werte enthalten (Standard: True)

Gibt zwei Objekte zurück: eine Liste von Clusterlabels, eine Liste von Verzerrungen

Cluster Analysis in Python

Hinweis zu Verzerrungen

  • kmeans gibt einen einzelnen Verzerrungswert zurück
  • vq gibt eine Liste von Verzerrungen zurück.
Cluster Analysis in Python

k-means ausführen

# Import kmeans and vq functions
from scipy.cluster.vq import kmeans, vq
# Generate cluster centers and labels
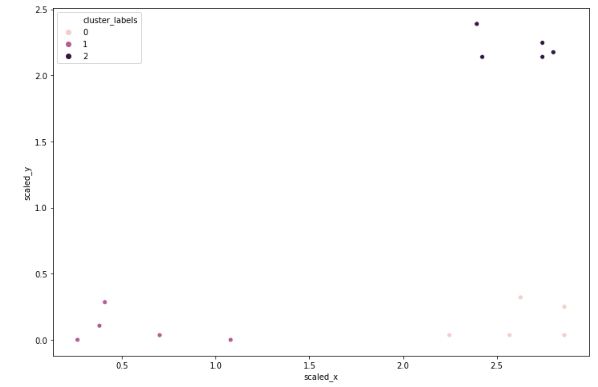
cluster_centers, _ = kmeans(df[['scaled_x', 'scaled_y']], 3)
df['cluster_labels'], _ = vq(df[['scaled_x', 'scaled_y']], cluster_centers)
# Plot clusters
sns.scatterplot(x='scaled_x', y='scaled_y', hue='cluster_labels', data=df)
plt.show()
Cluster Analysis in Python

Cluster Analysis in Python

Als Nächstes: Übungen!

Cluster Analysis in Python

Preparing Video For Download...