Fortgeschrittene Regression mit statsmodels in Python
Maarten Van den Broeck
Content Developer at DataCamp
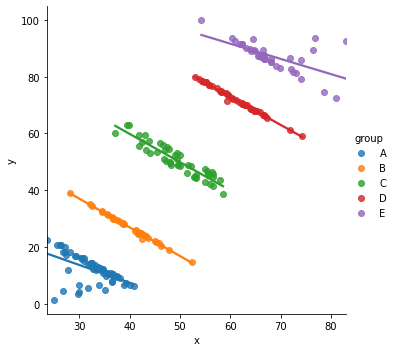
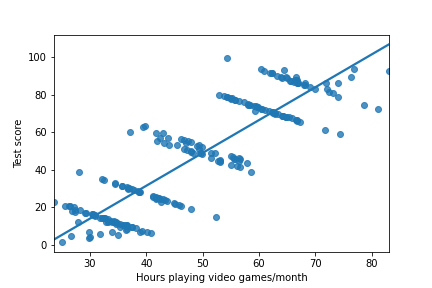
Simpsons Paradox tritt auf, wenn der Trend eines Modells auf dem gesamten Datensatz stark von den Trends der Modelle auf Teilmengen abweicht.
trend = Steigungskoeffizient
| x | y | group |
|---|---|---|
| 62.24344 | 70.60840 | D |
| 52.33499 | 14.70577 | B |
| 56.36795 | 46.39554 | C |
| 66.80395 | 66.17487 | D |
| 66.53605 | 89.24658 | E |
| 62.38129 | 91.45260 | E |
mdl_whole = ols("y ~ x",
data=simpsons_paradox).fit()
print(mdl_whole.params)
Intercept -38.554
x 1.751
mdl_by_group = ols("y ~ group + group:x + 0",
data = simpsons_paradox).fit()
print(mdl_by_group.params)
groupA groupB groupC groupD groupE
32.5051 67.3886 99.6333 132.3932 123.8242
groupA:x groupB:x groupC:x groupD:x groupE:x
-0.6266 -1.0105 -0.9940 -0.9908 -0.5364
sns.regplot(x="x",
y="y",
data=simpsons_paradox,
ci=None)

sns.lmplot(x="x",
y="y",
data=simpsons_paradox,
hue="group",
ci=None)

Wenn möglich, plote den Datensatz.
Du kannst nicht generell das beste Modell wählen – es hängt vom Datensatz und der Frage ab, die du beantworten willst.
Formuliere eine Frage, bevor du mit dem Modellieren startest.


Fortgeschrittene Regression mit statsmodels in Python