Einführung in Spark SQL mit Python
Mark Plutowski
Data Scientist
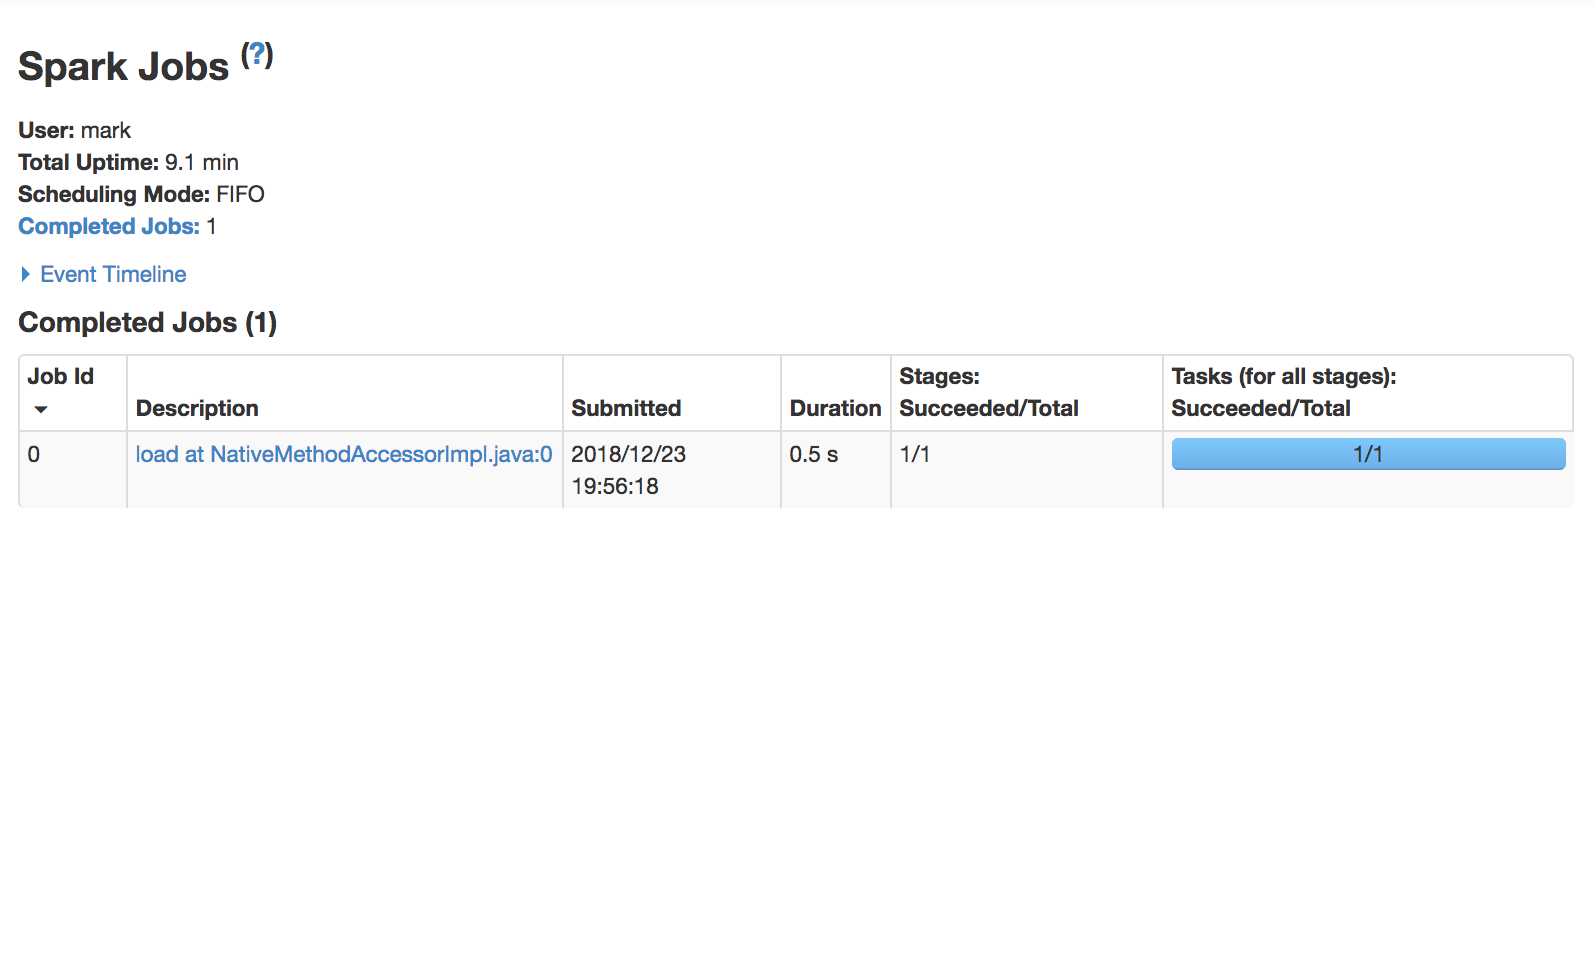
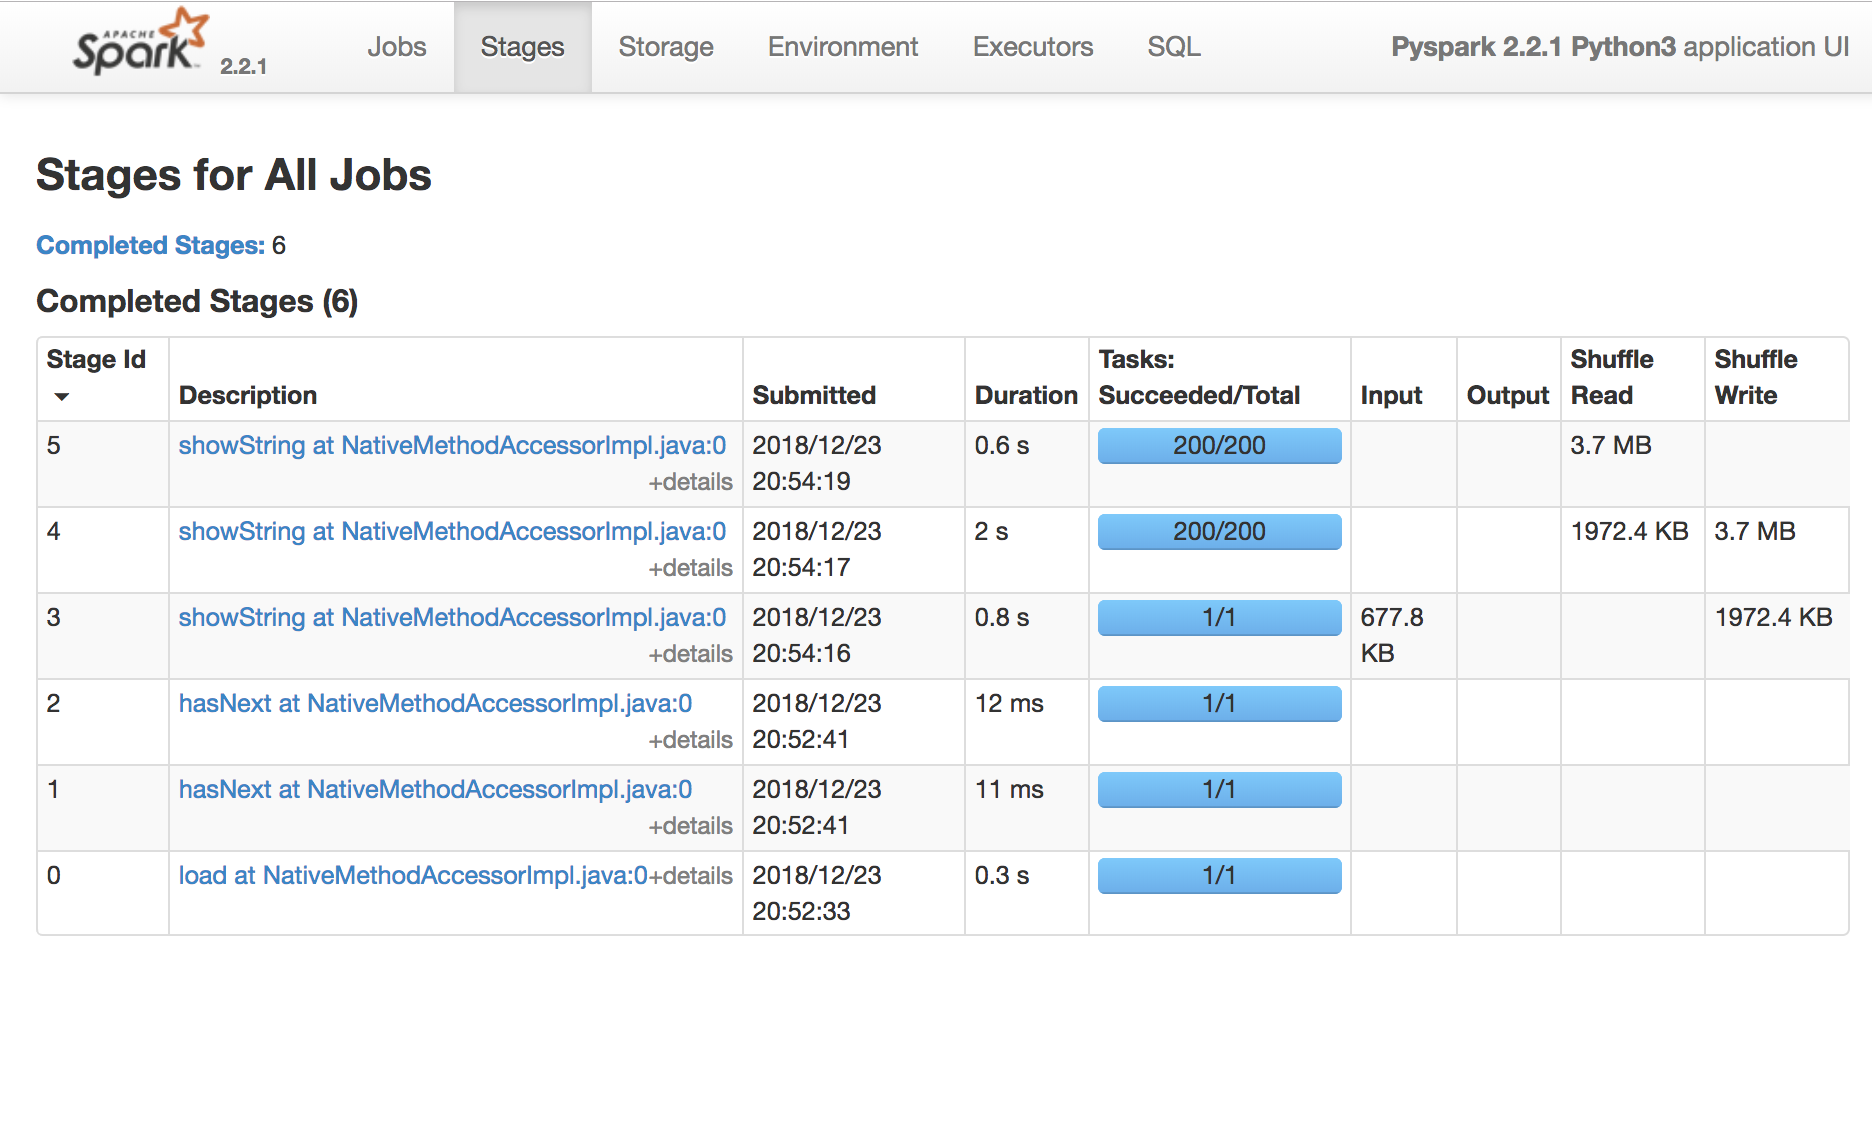
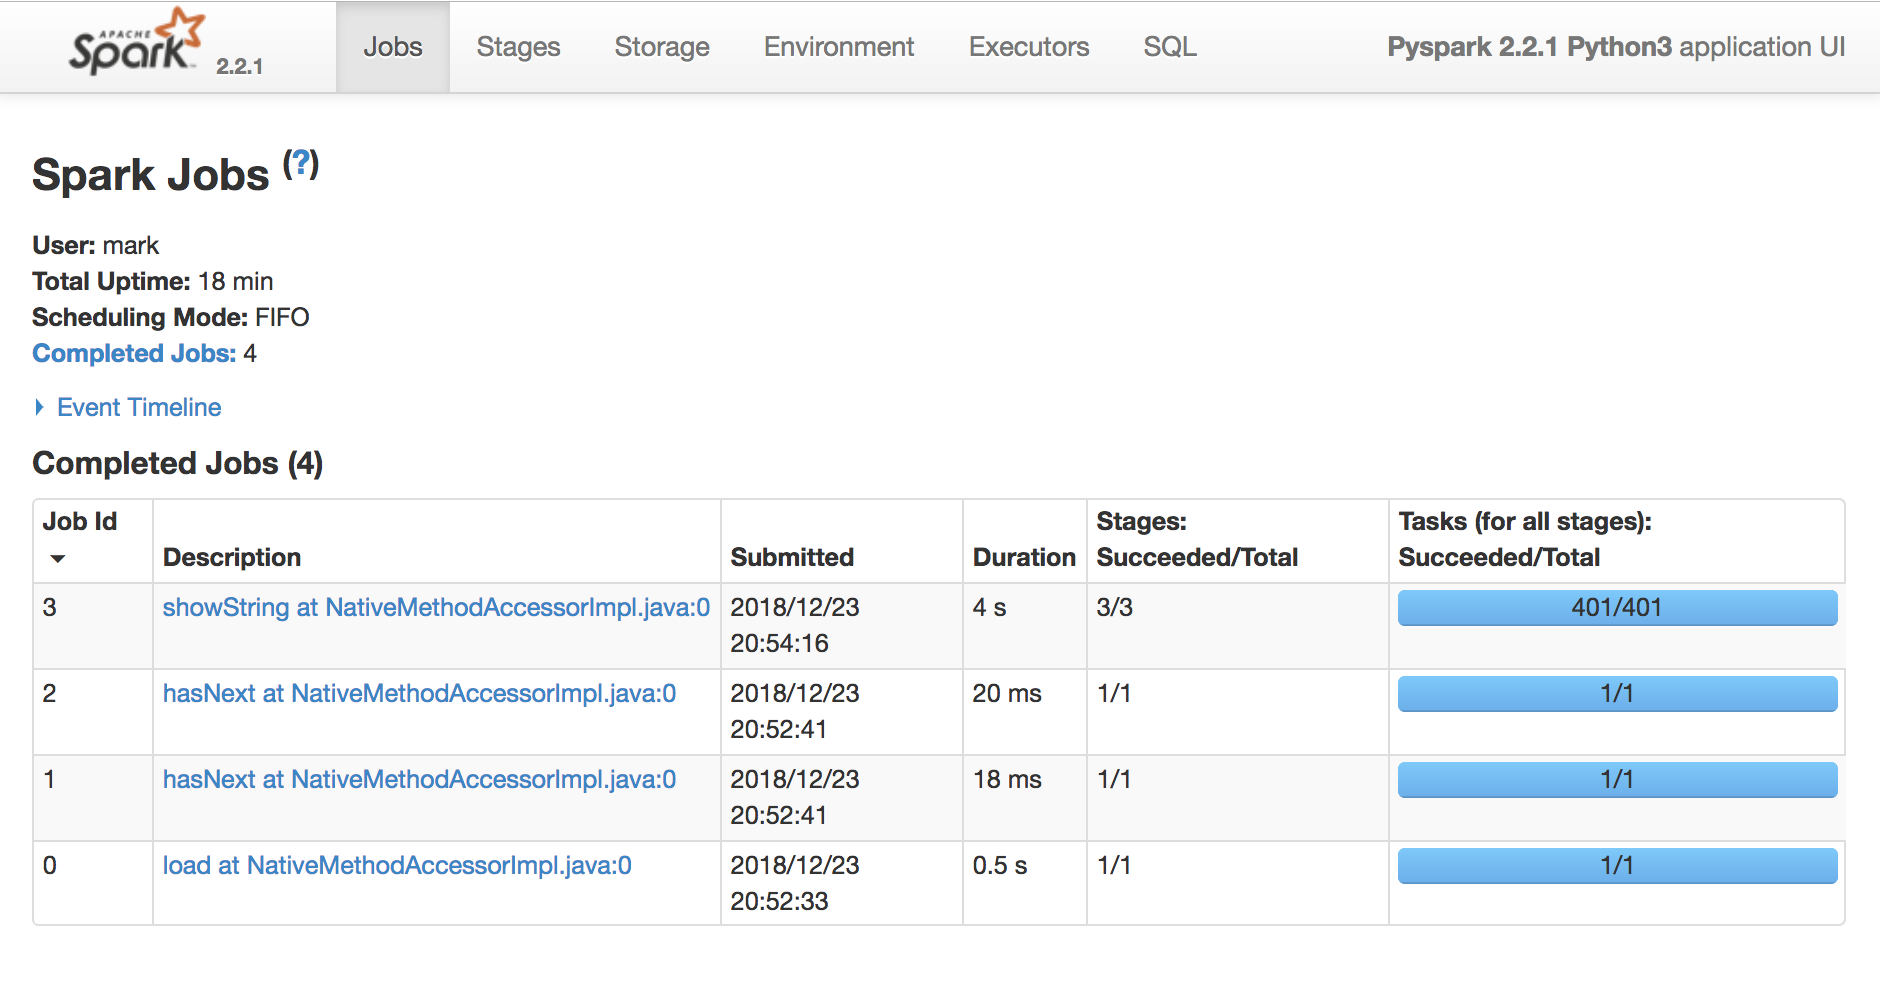
Ein Spark-Task ist eine Ausführungseinheit auf einer CPU.
Eine Spark-Stage ist eine Gruppe gleichartiger Tasks, parallel auf unterschiedlichen Datenteilen.
Ein Spark-Job ist eine durch eine Action ausgelöste Berechnung, aufgeteilt in eine oder mehrere Stages.


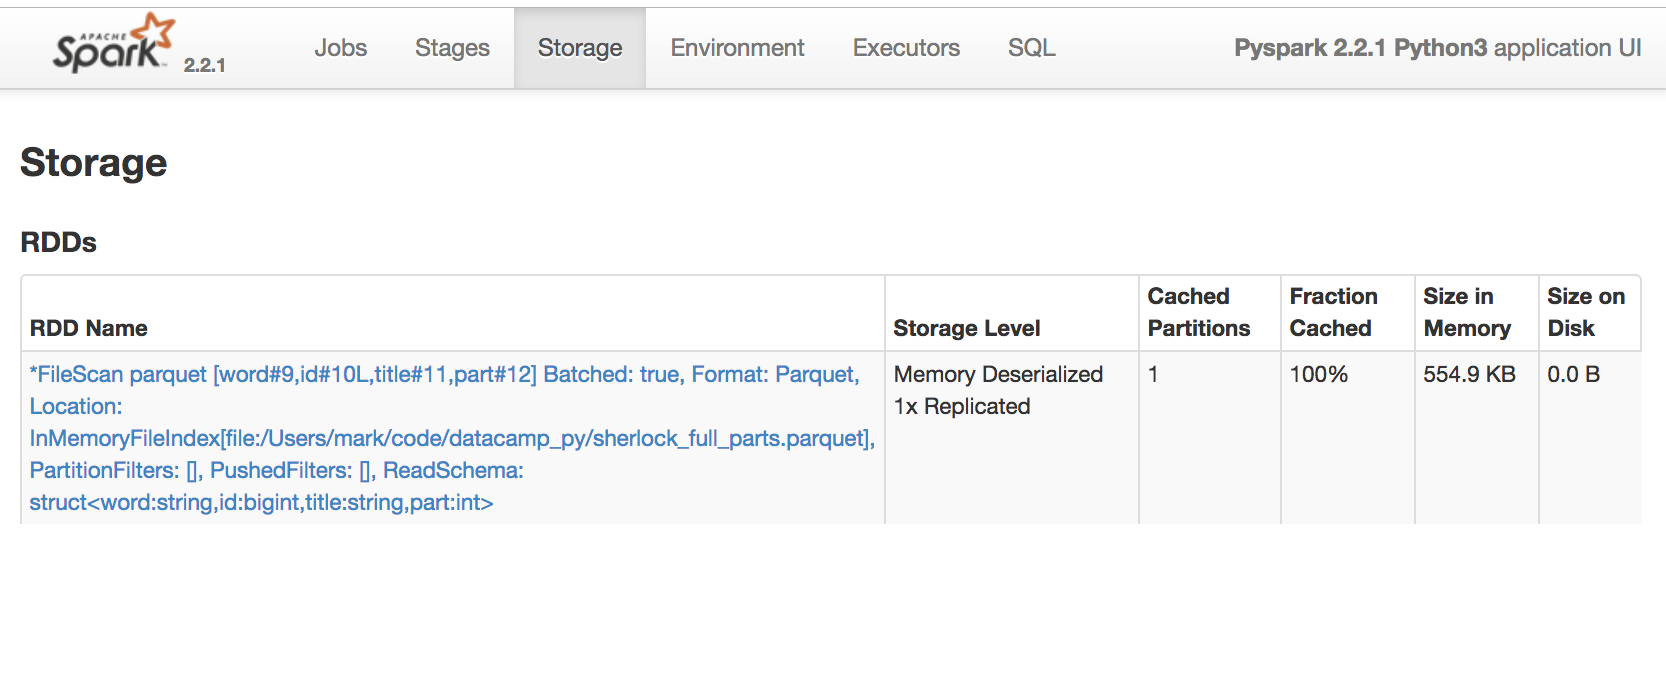
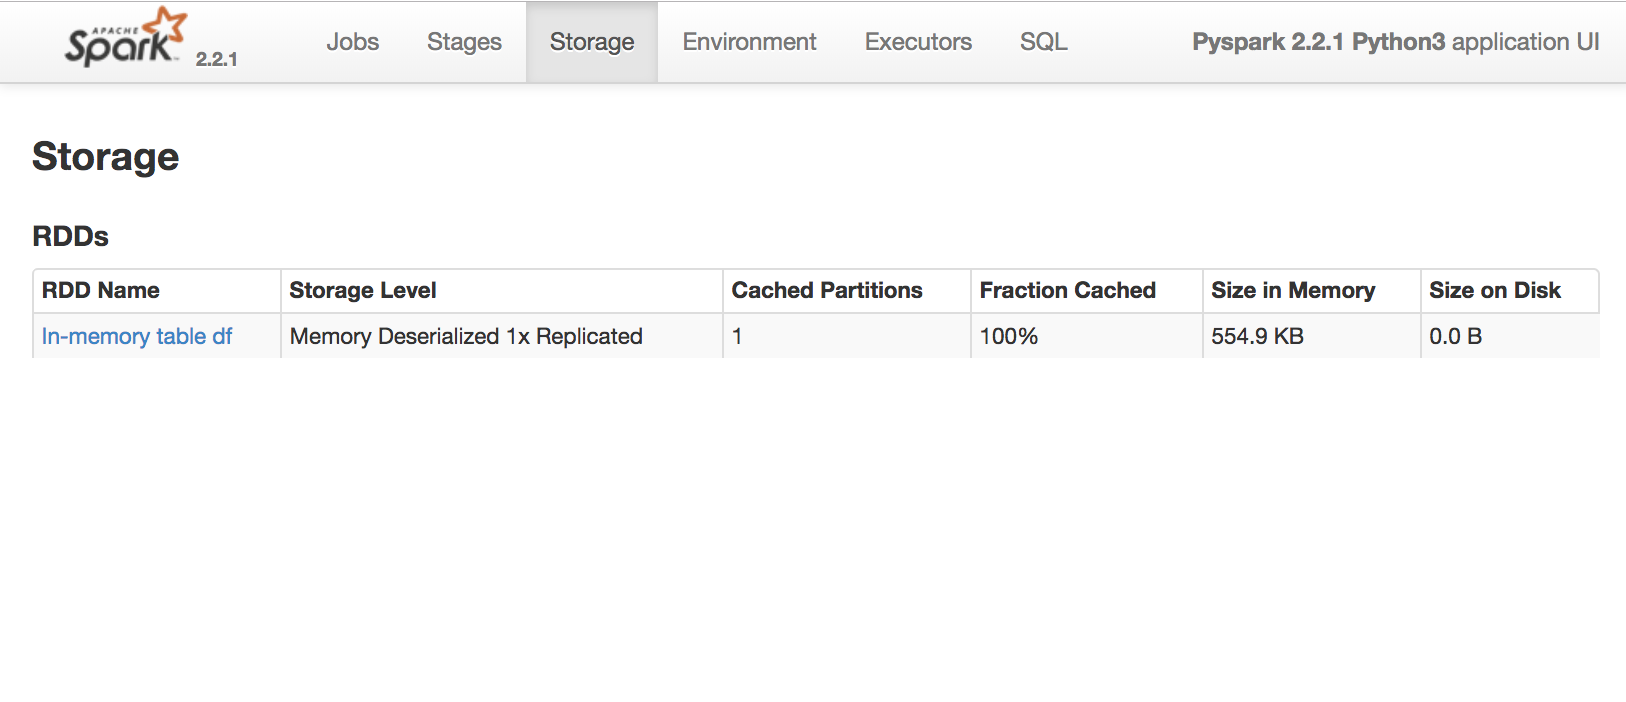
spark.catalog.cacheTable('table1')spark.catalog.uncacheTable('table1')spark.catalog.isCached('table1')spark.catalog.dropTempView('table1')spark.catalog.listTables()
[Table(name='text', database=None, description=None, tableType='TEMPORARY', isTemporary=True)]


Zeigt, wo Datenpartitionen liegen
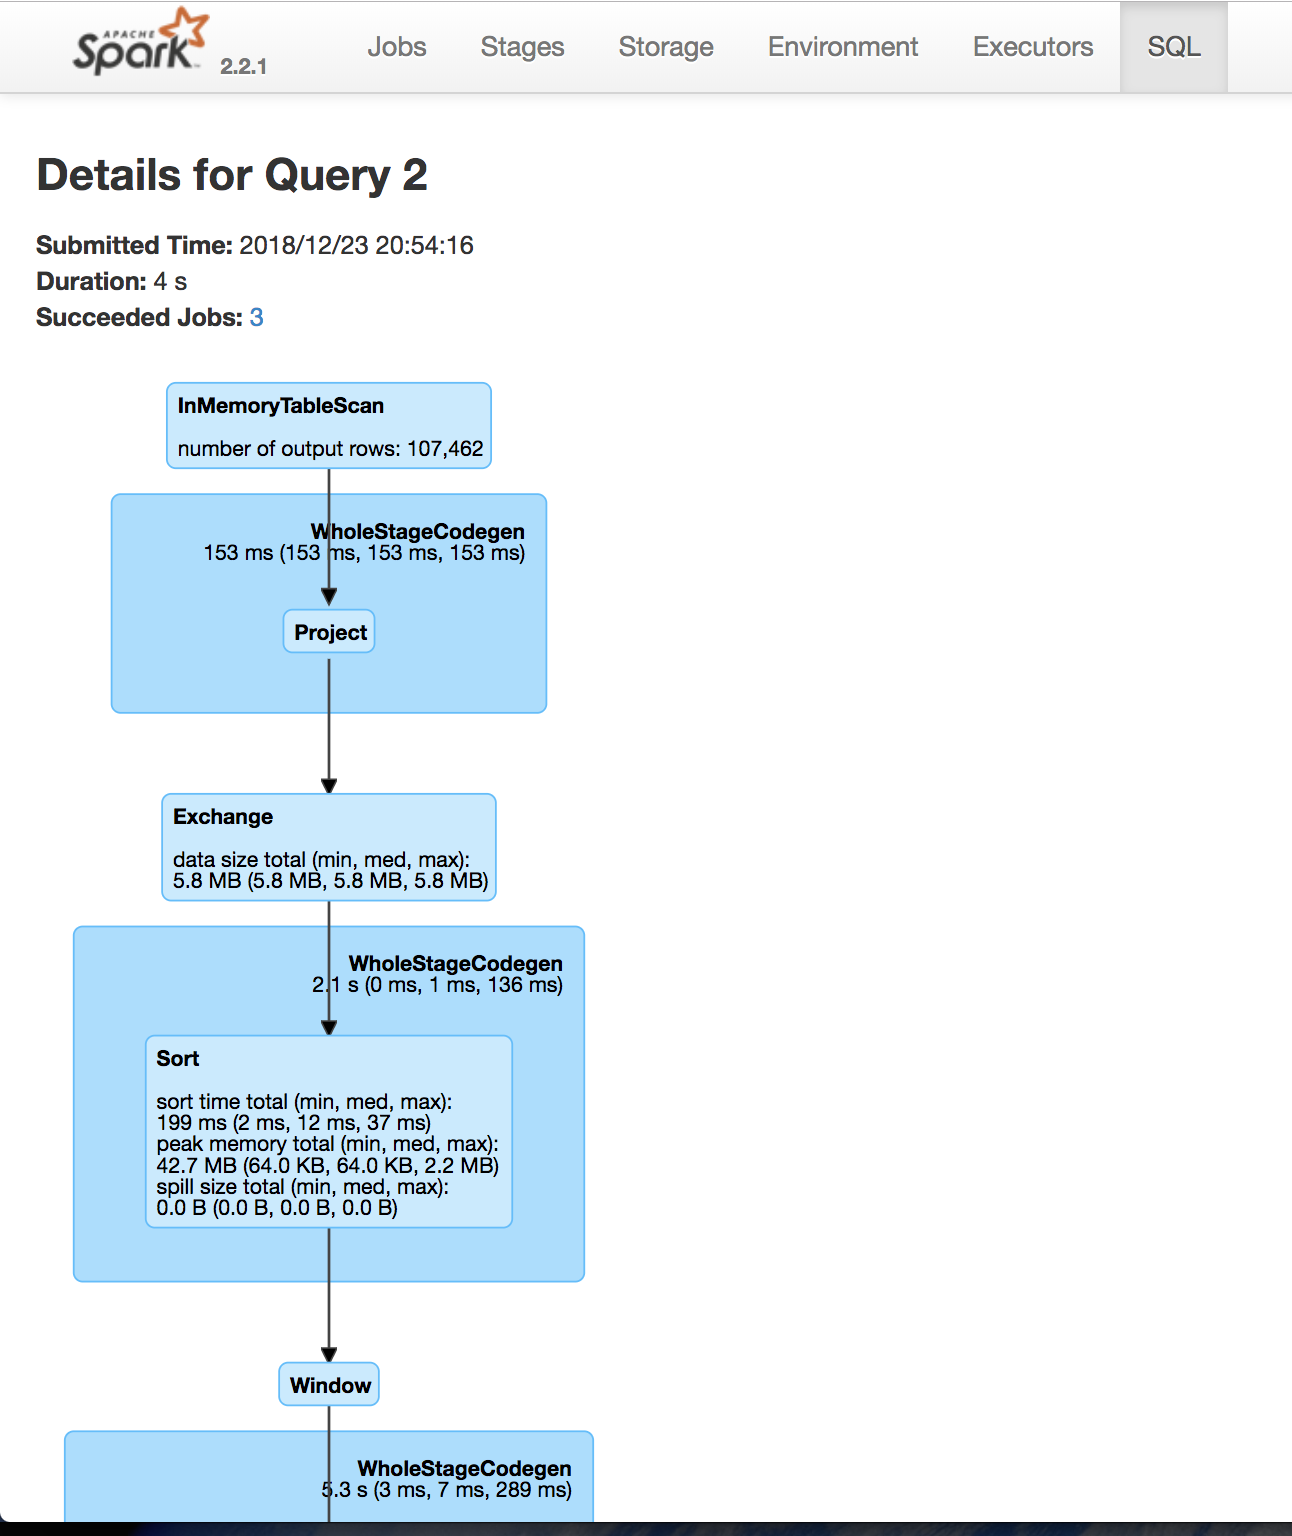
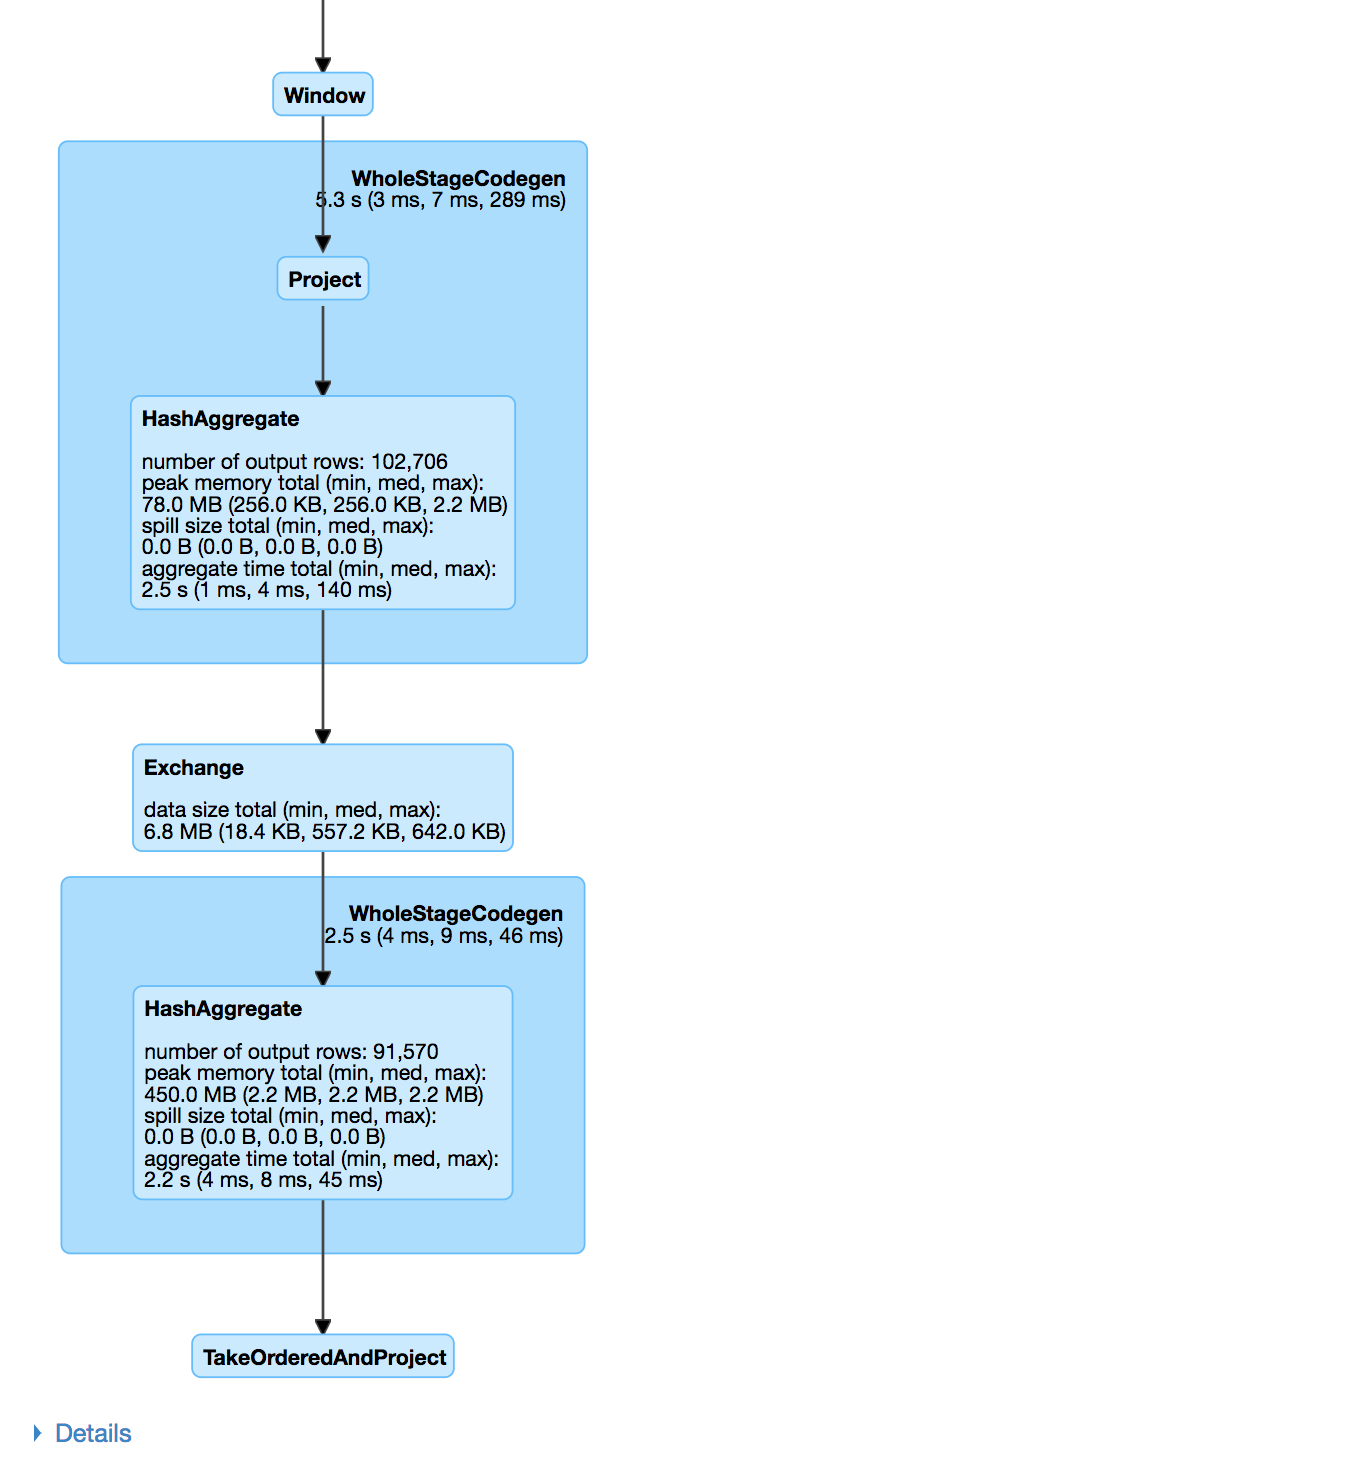
query3agg = """ SELECT w1, w2, w3, COUNT(*) as count FROM ( SELECT word AS w1, LEAD(word,1) OVER(PARTITION BY part ORDER BY id ) AS w2, LEAD(word,2) OVER(PARTITION BY part ORDER BY id ) AS w3 FROM df ) GROUP BY w1, w2, w3 ORDER BY count DESC """spark.sql(query3agg).show()


Einführung in Spark SQL mit Python