Data Engineering in Microsoft Fabric
Daten transformieren und analysieren mit Microsoft Fabric
Luis Silva
Solution Architect - Data & AI
Data Analytics End-to-End
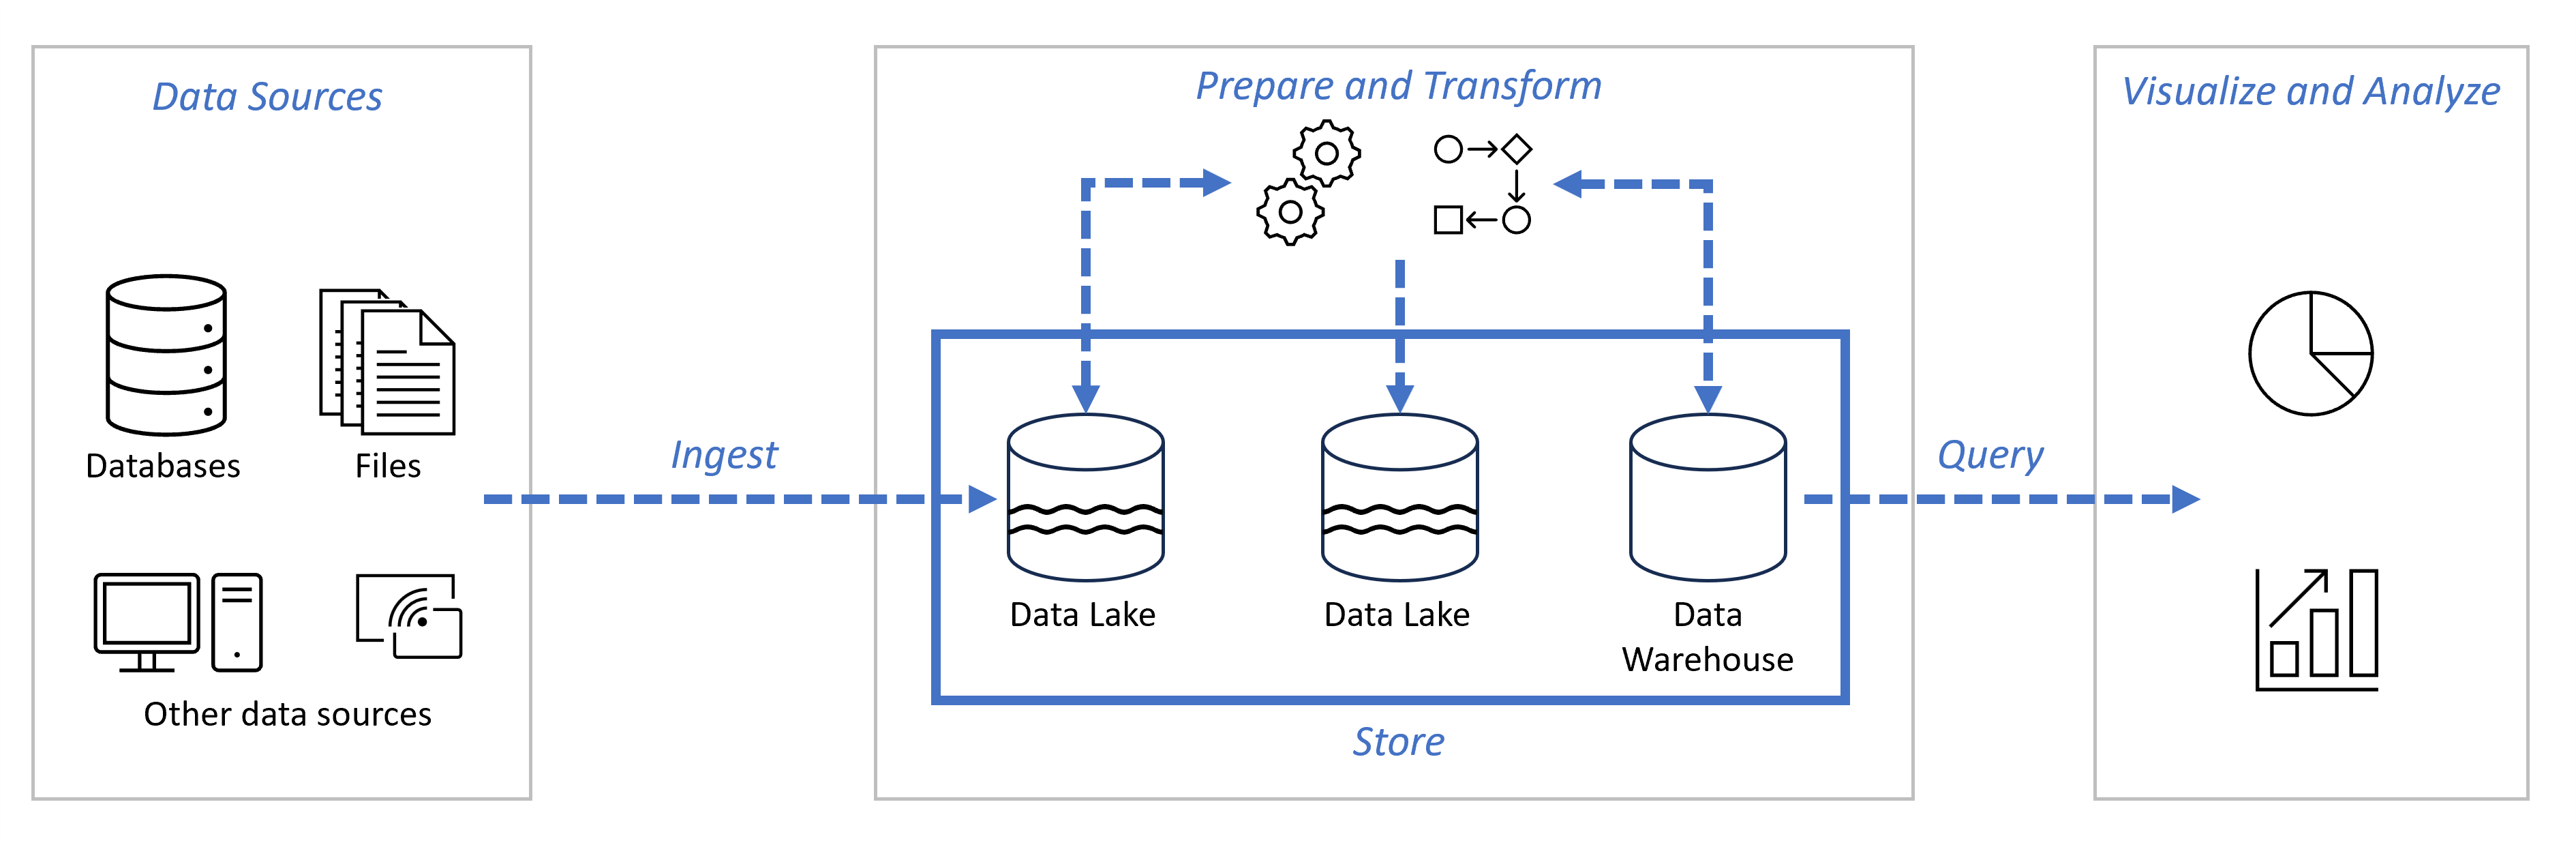
Daten aus der Quelle erfassen und in einem Data Lake speichern
Daten aufbereiten und transformieren
Daten visualisieren und analysieren
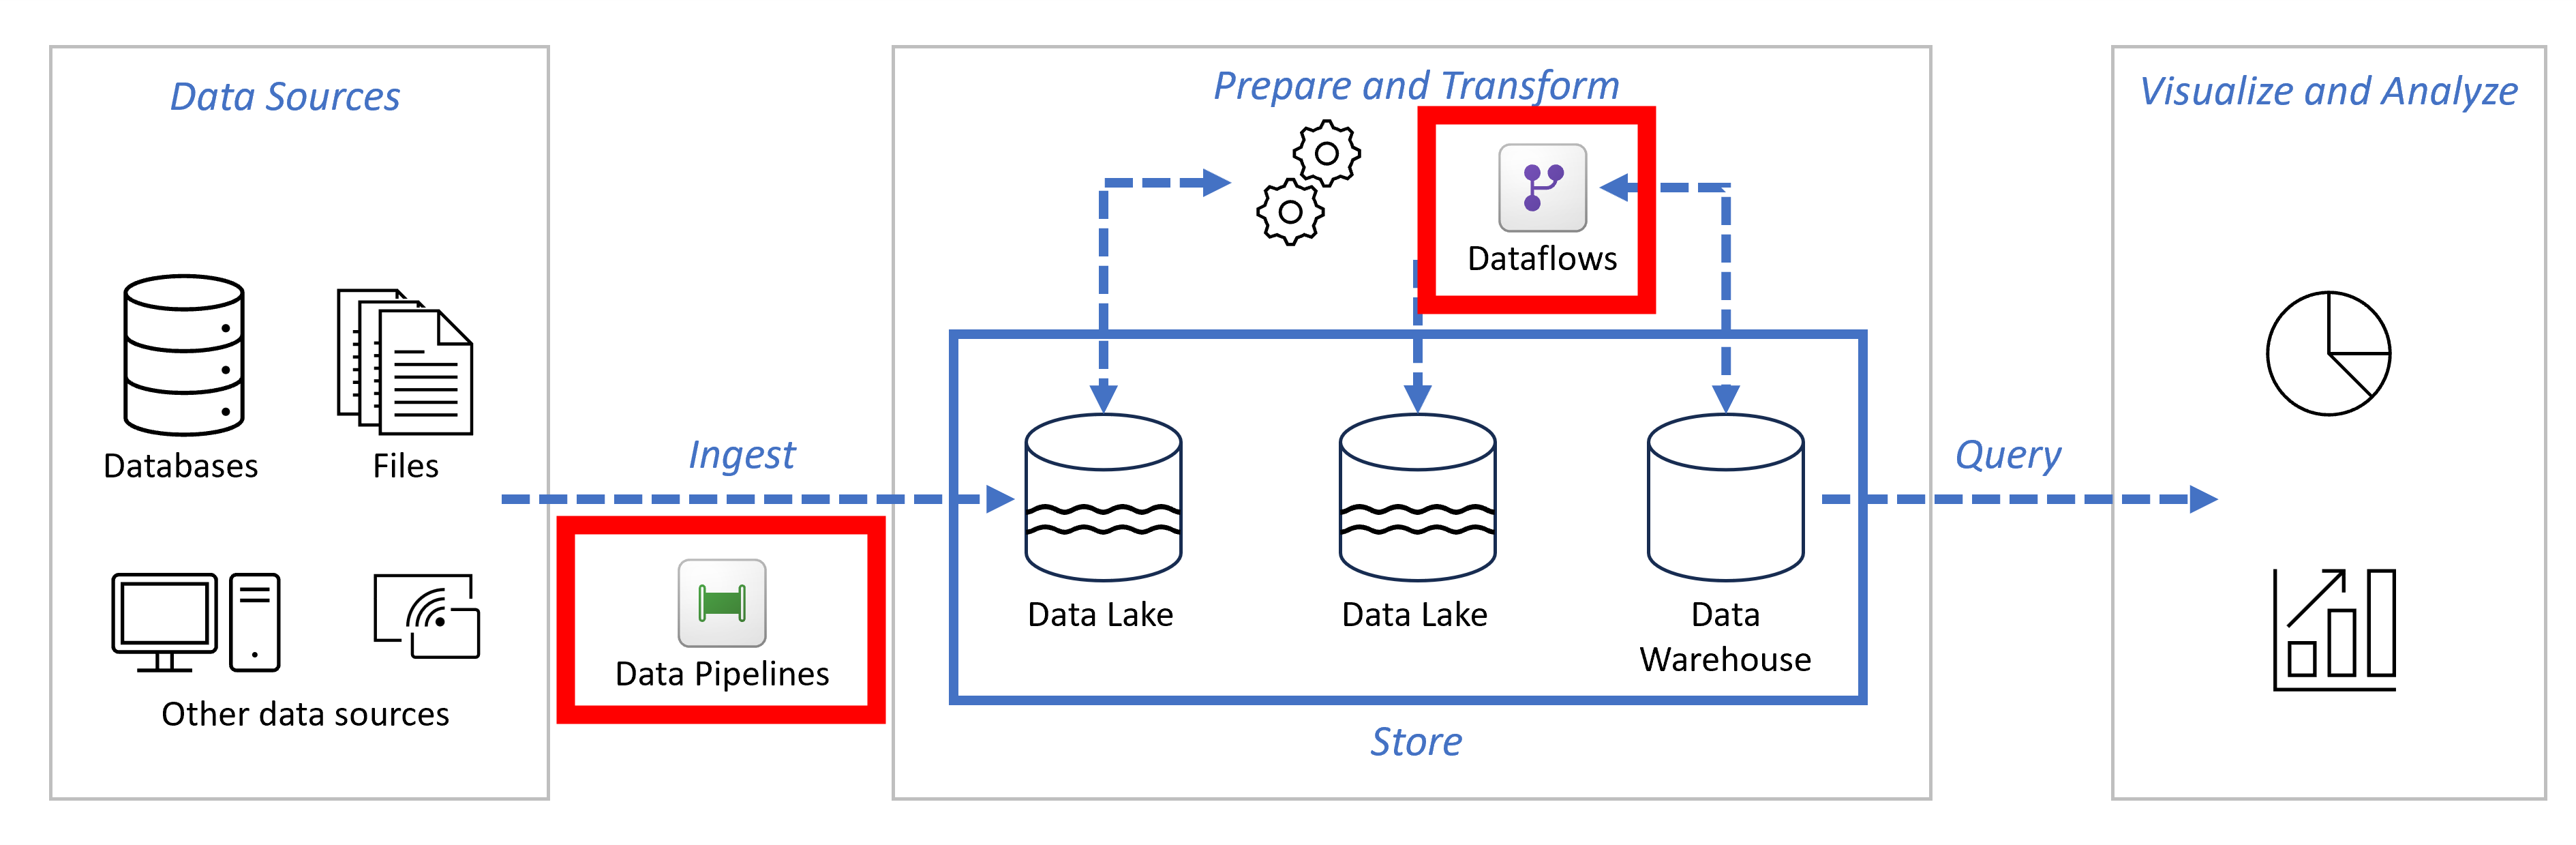
Data Factory
Daten erfassen, aufbereiten und transformieren
Dataflows und Data Pipelines
Dataflows
Low-Code-Oberfläche für Datenerfassung und -transformation
Power Query-Transformationsengine
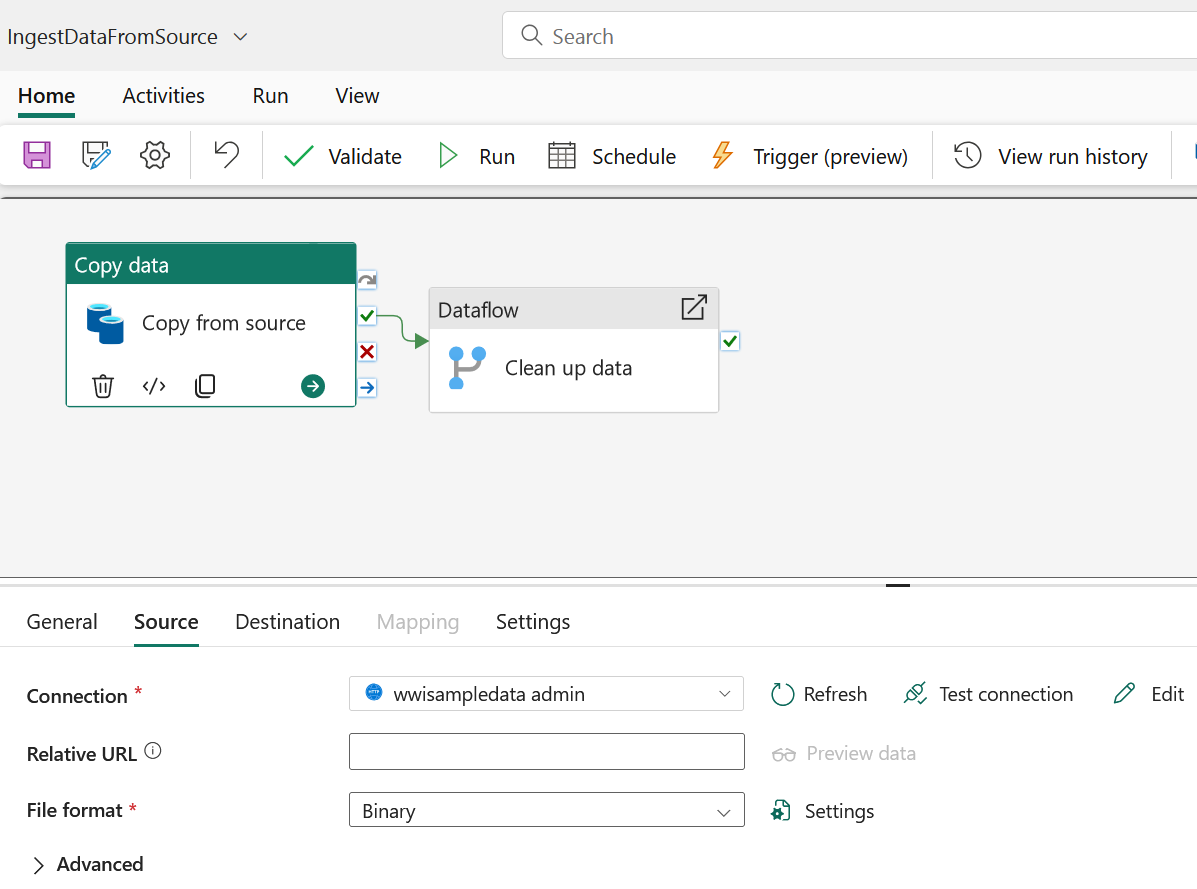
Data Pipelines
Sammlung von Aktivitäten, die eine Aufgabe ausführen
Arten von Aktivitäten:
Datenbewegung (Copy Activity, Dataflow)
Datentransformation (Notebook, Stored Procedure, Script)
Steuerung (Switch, If, ForEach, Wait)
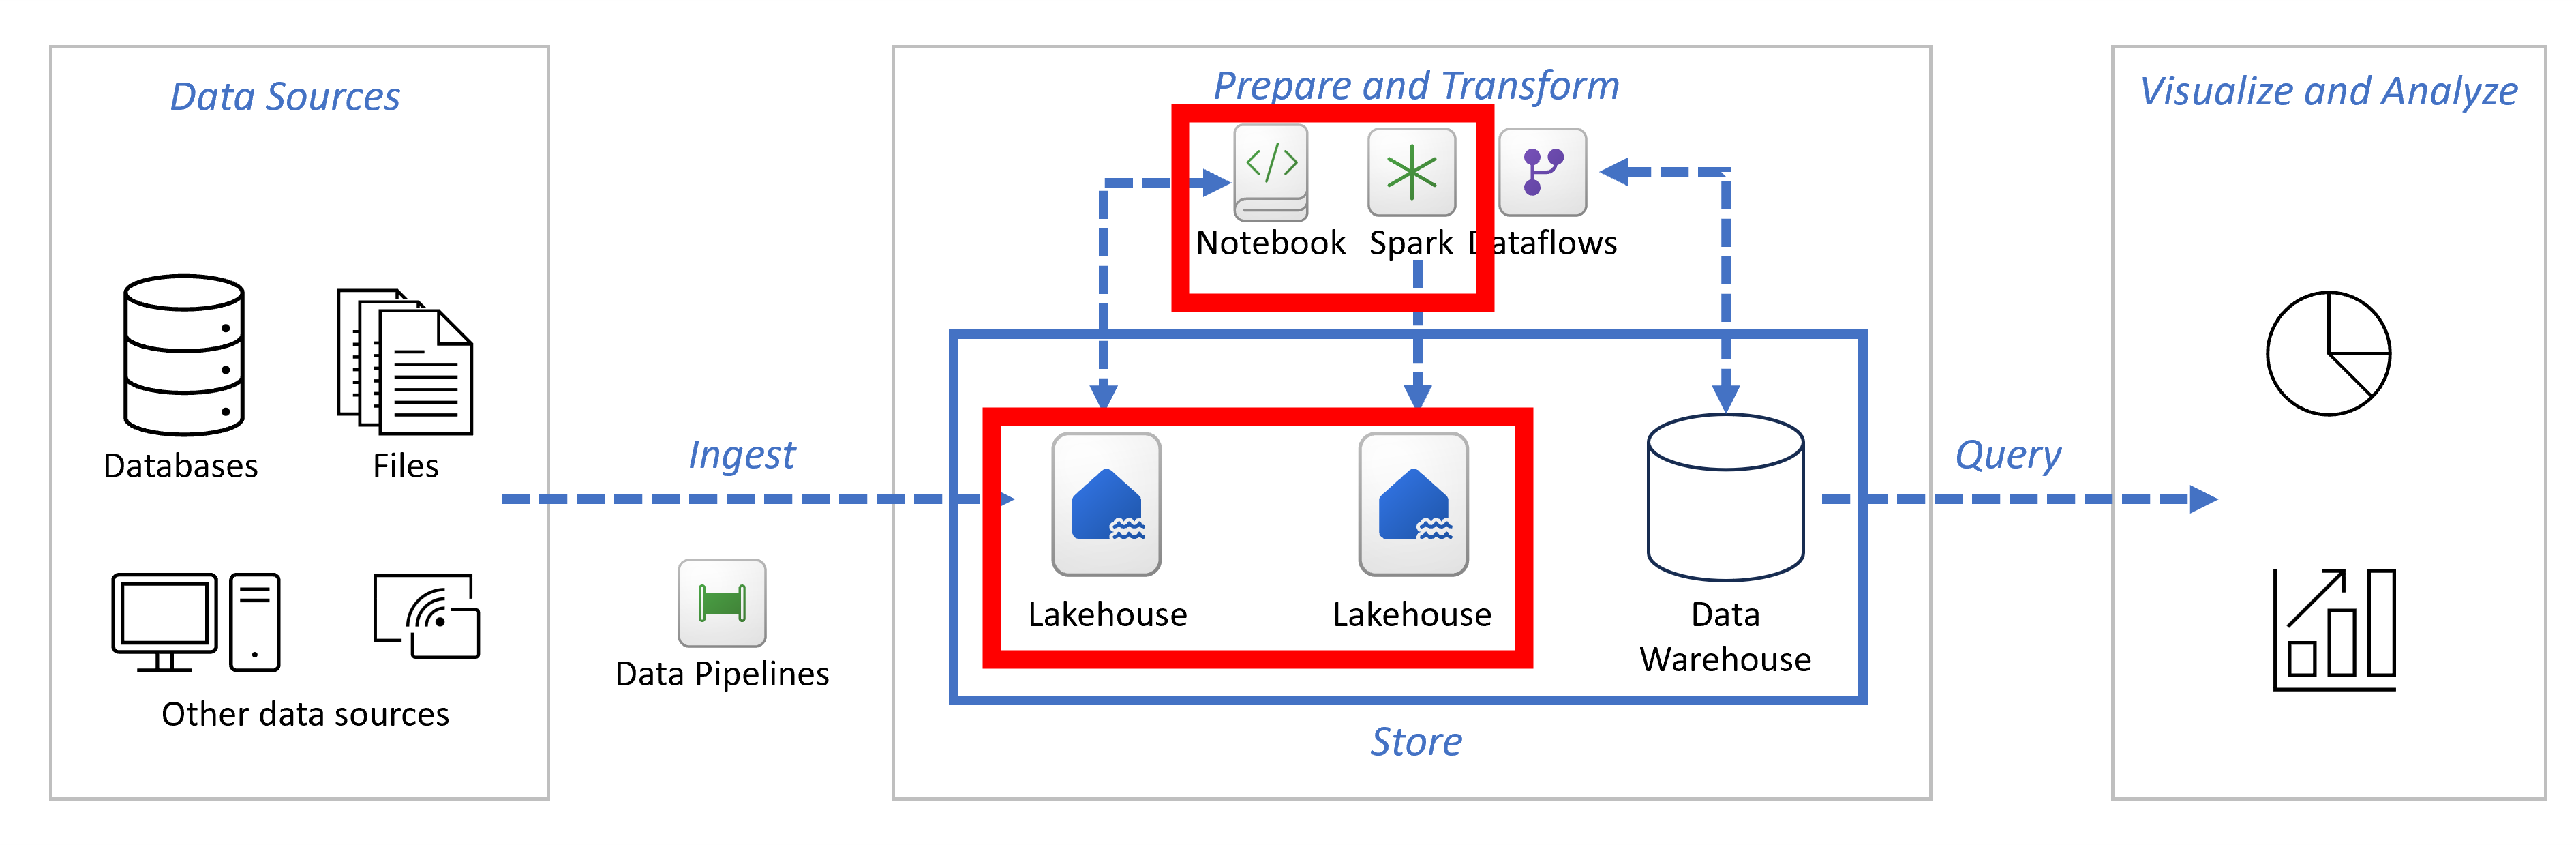
Synapse Data Engineering
Lakehouses
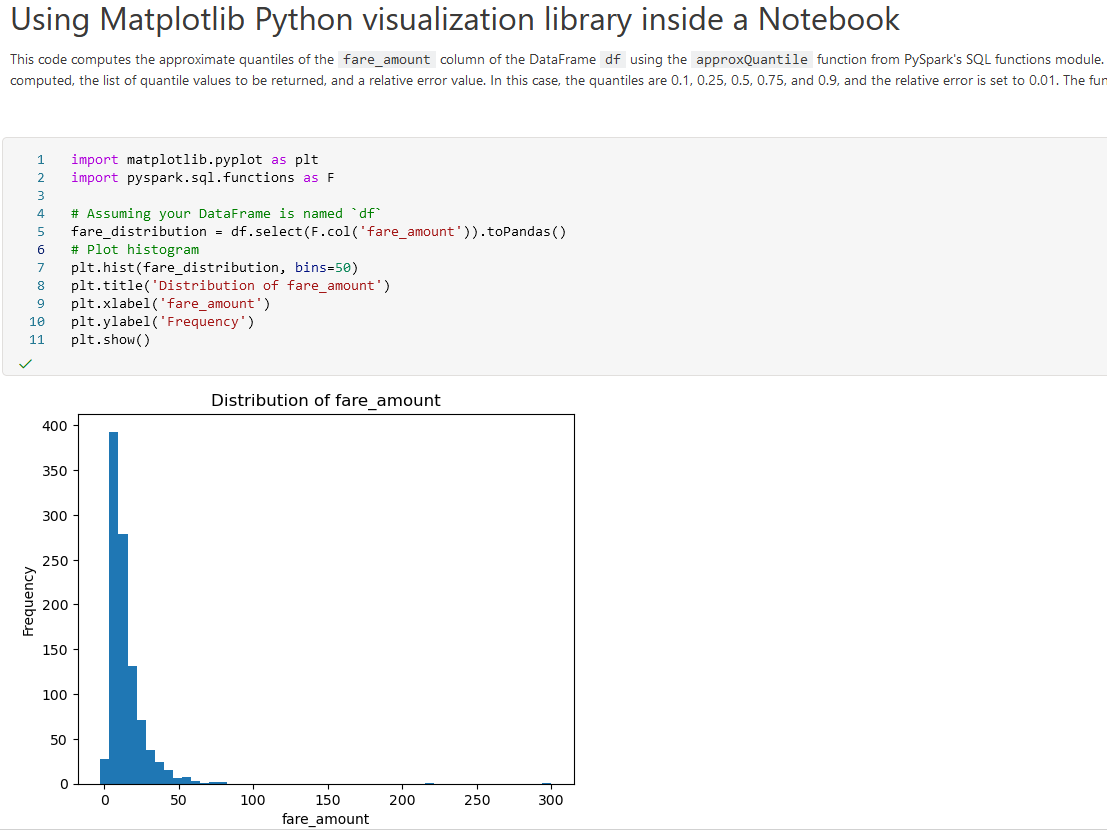
Notebooks
Apache Spark-Jobdefinitionen
Lakehouses
Strukturierte Daten (Tabellen)
Unstrukturierte Daten (Dateien)
Notebooks
Interaktive Weboberfläche
Code zur Datenverarbeitung
Datenvisualisierungen
Kommentare/Erklärungen
Mehrsprachige Unterstützung:
PySpark (Python)
Spark (Scala)
Spark SQL (SQL)
SparkR (R)
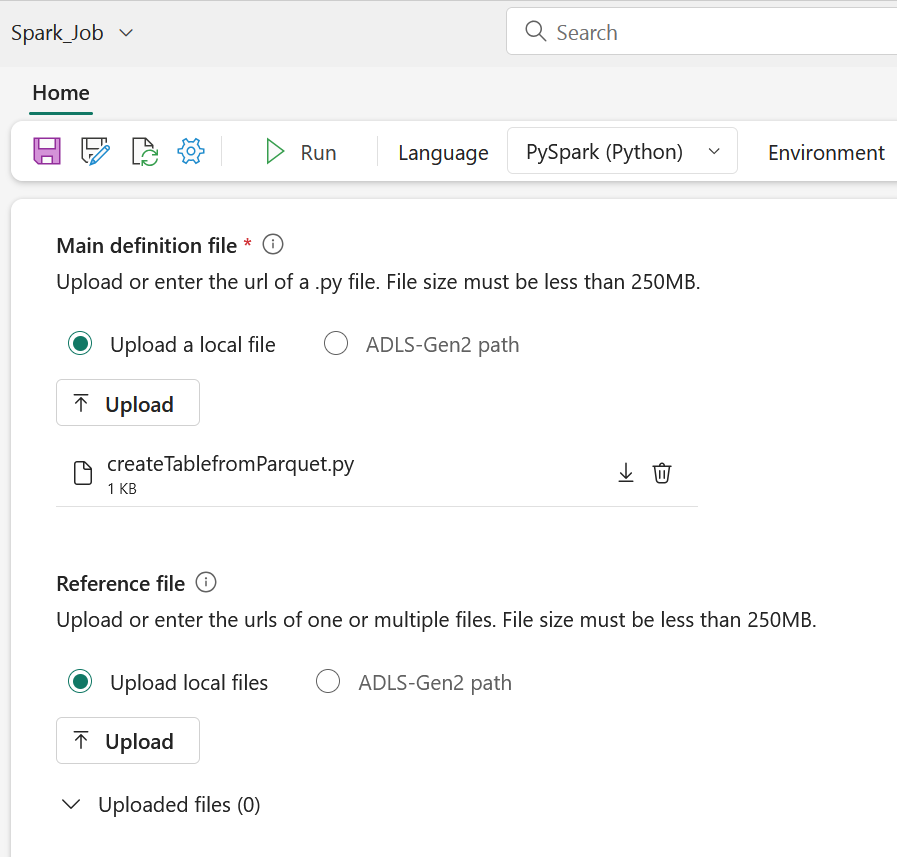
Apache Spark-Jobdefinitionen
Batch-/Streaming-Jobs an Spark-Cluster senden
Alternative oder Ergänzung zu Notebooks:
Notebooks für Datenexploration, Prototyping und kollaborative Entwicklung
Spark-Jobdefinition zur Automatisierung produktionsreifer Datenverarbeitung
Synapse Data Warehouse
Verhält sich wie ein klassisches relationales Data Warehouse
Speichert Daten in OneLake im offenen Delta-Lake-Format
Ermöglicht Interoperabilität mit anderen Fabric-Workloads
Keine mehrfachen Datenkopien nötig
Das richtige Datenspeicher wählen
Lakehouse
Unstrukturierte Daten (Dateien)
Spark als primäre Entwicklungsoberfläche
Warehouse
Strukturierte Daten (Tabellen)
T-SQL als primäre Entwicklungsoberfläche
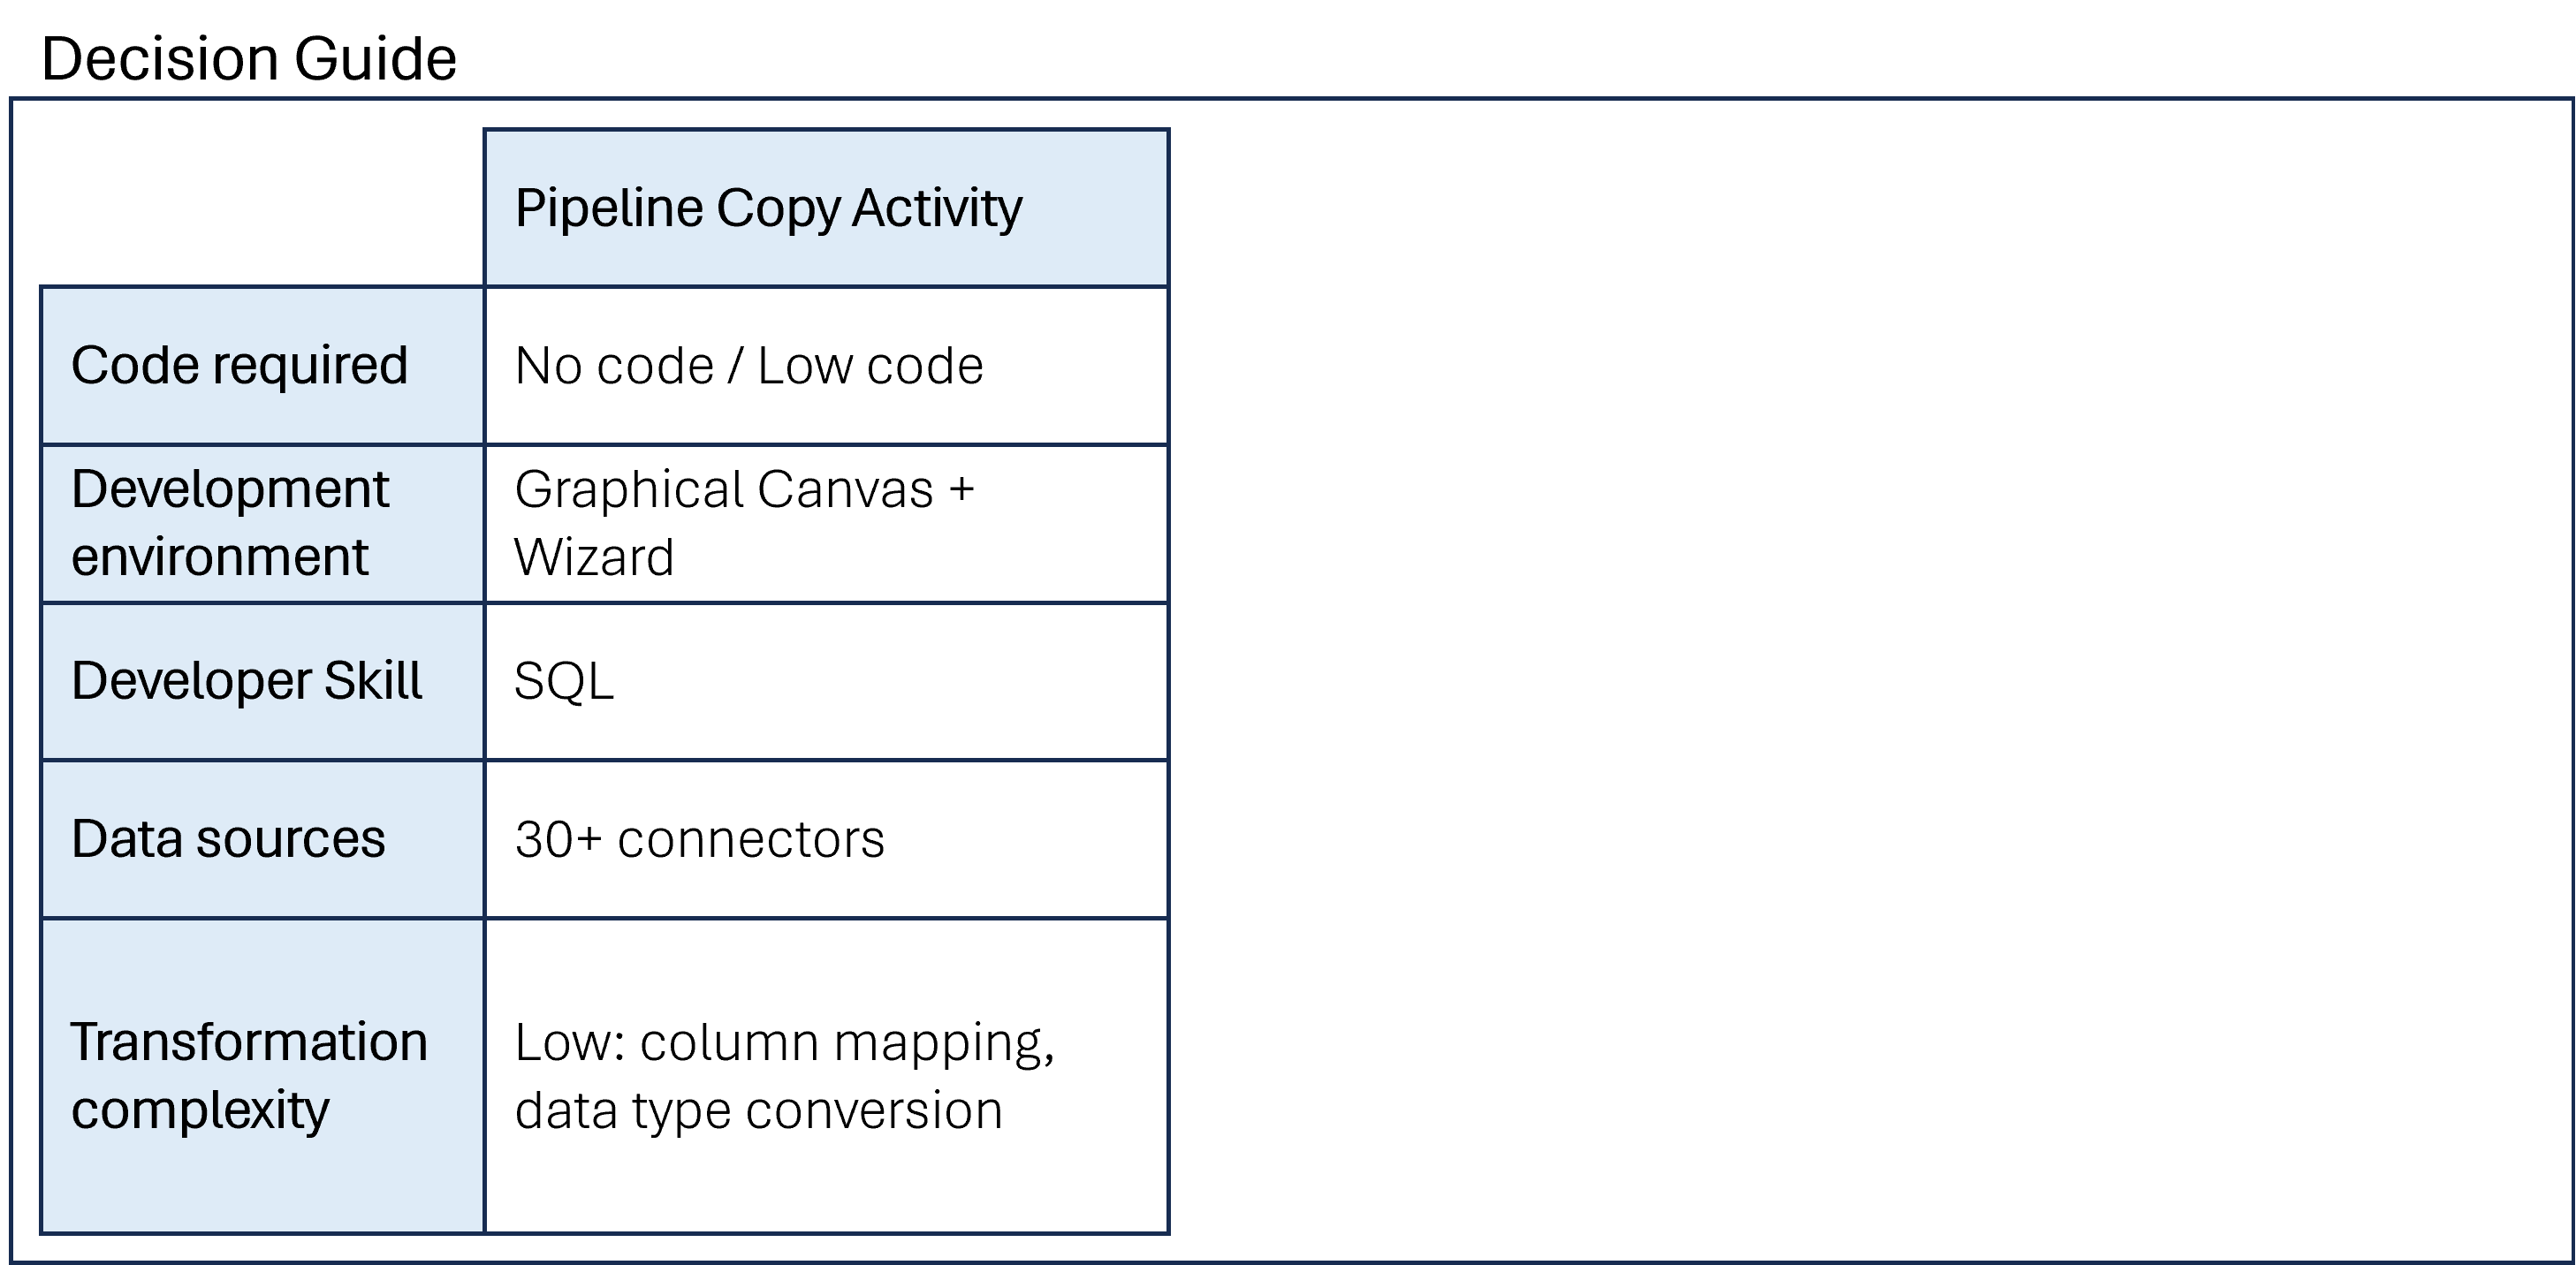
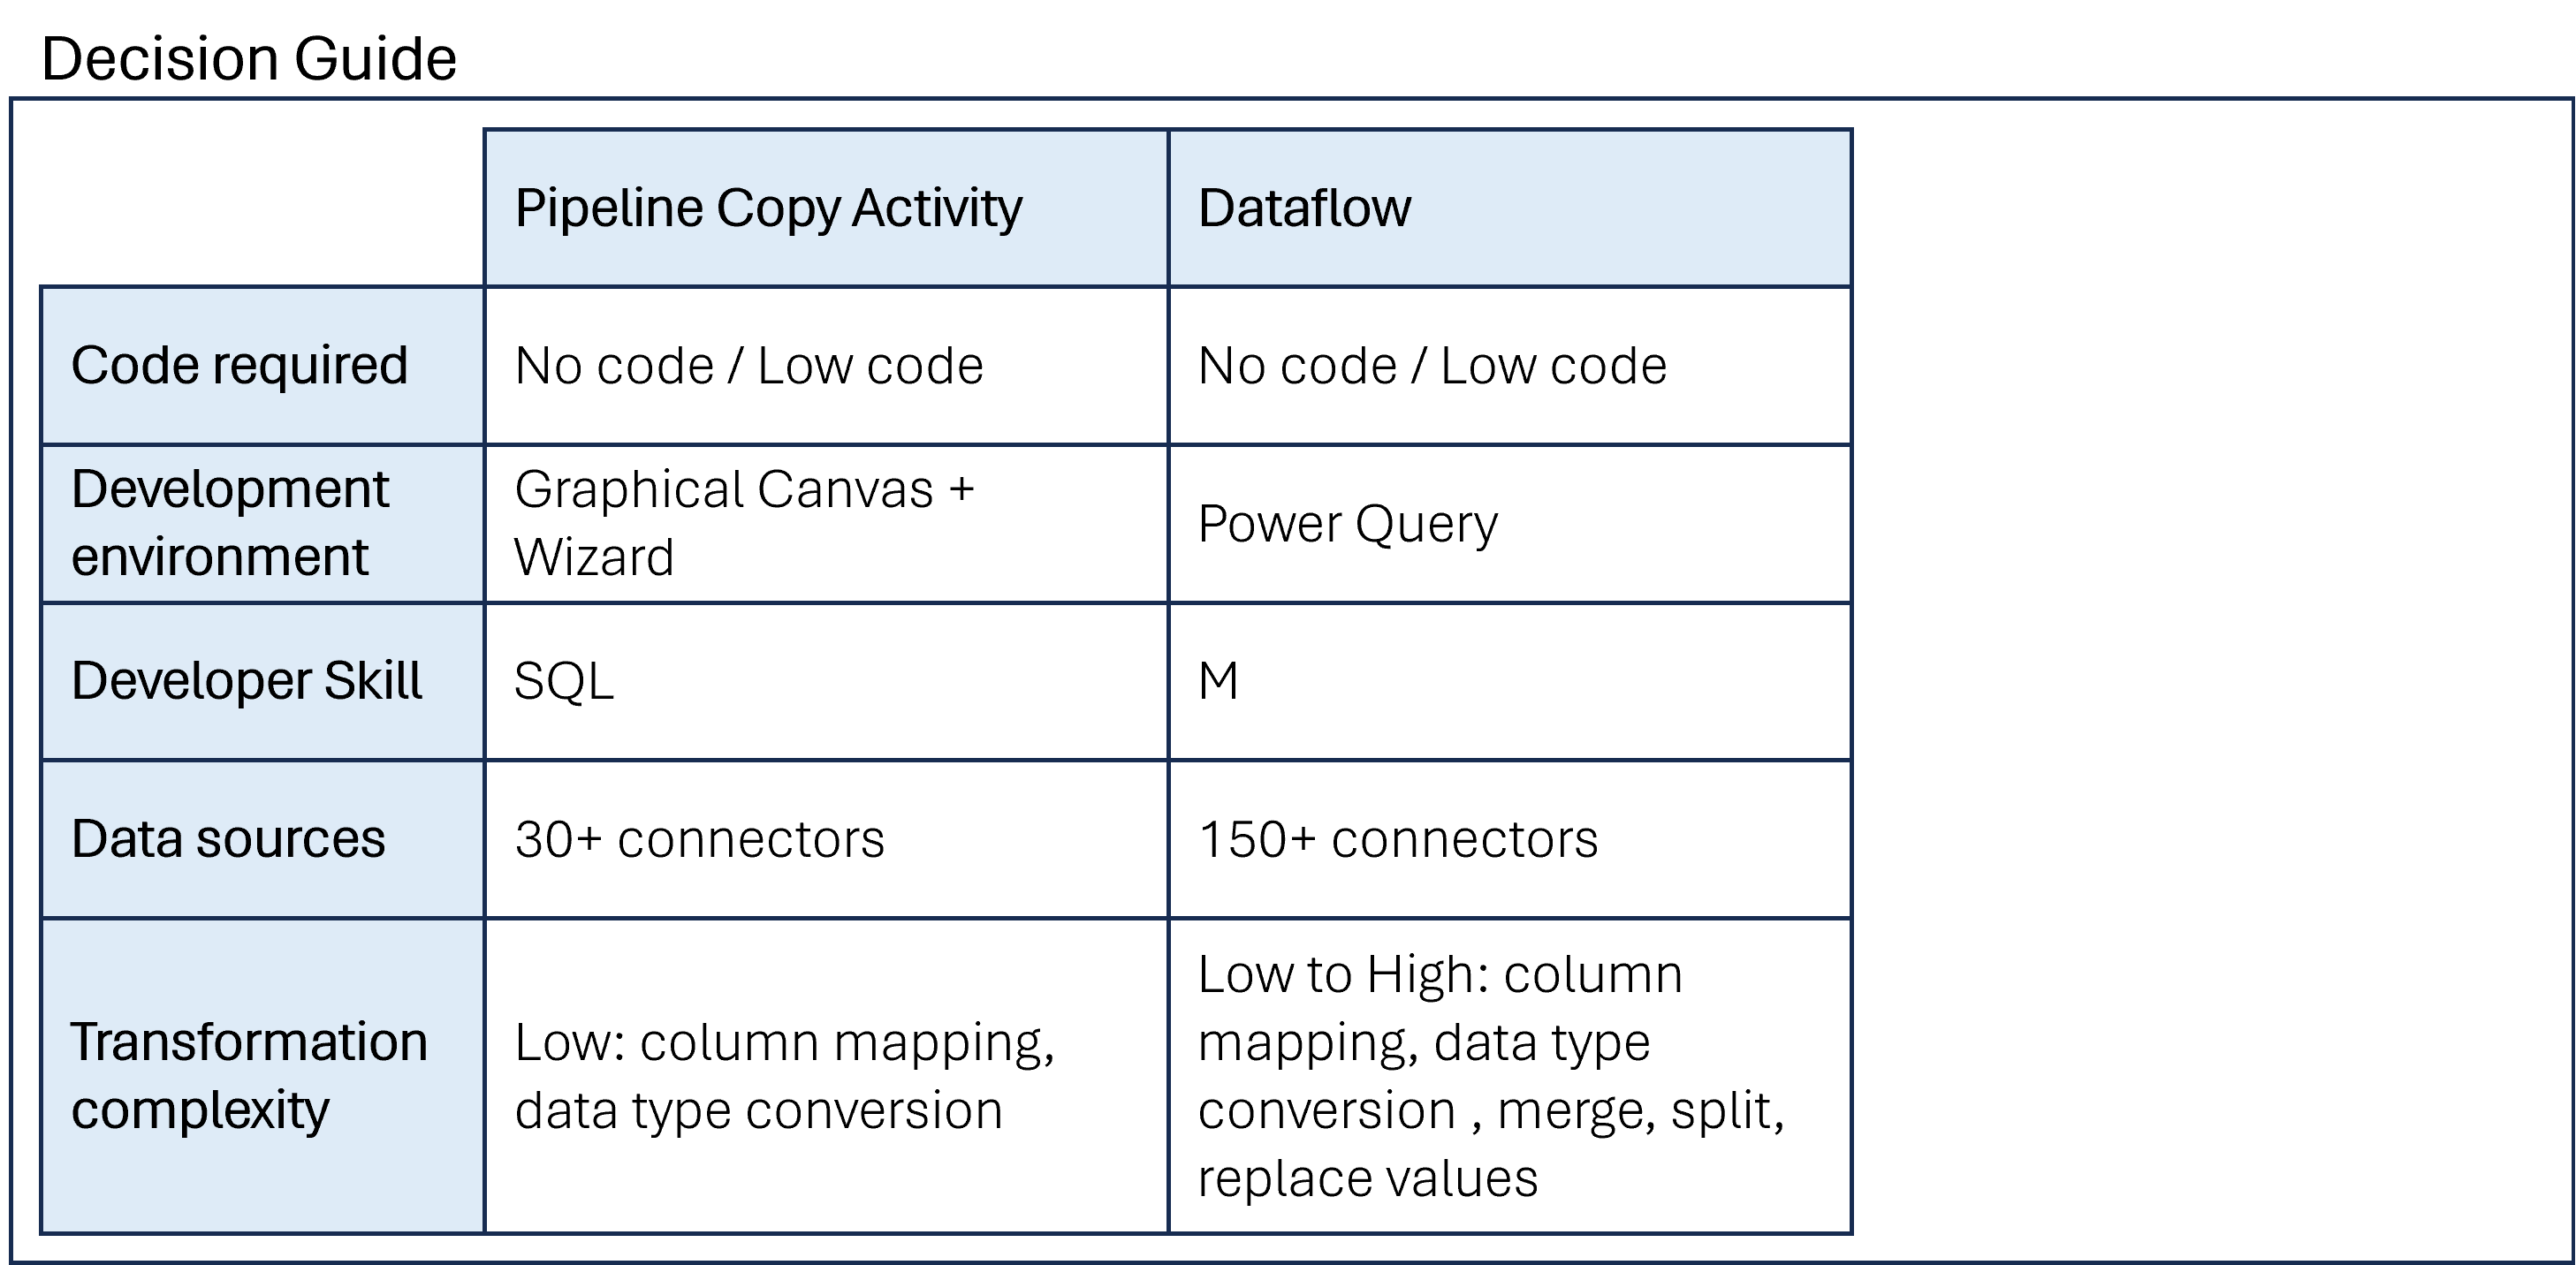
Ein Tool zum Datenkopieren wählen
Lass uns üben!
Daten transformieren und analysieren mit Microsoft Fabric
Preparing Video For Download...