Delta Lake: Tabellenoptimierung

Daten transformieren und analysieren mit Microsoft Fabric

Luis Silva

Solution Architect - Data & AI

Was ist Delta Lake?

  • Open-Source-Speicherschicht für Lakehouses
  • ACID-Transaktionen, Metadatenverwaltung und Versionierung
  • Fabric nutzt das Delta-Lake-Tabellenformat (Parquet) als Standard
  • Interoperabilität über alle Fabric-Erlebnisse hinweg

Diagramm der Fabric-Architektur: Daten werden ingestiert, als Delta-Lake-Tabellen gespeichert und mit Power BI abgefragt

Daten transformieren und analysieren mit Microsoft Fabric

Tabellenwartung

  • Halte Delta-Tabellen in Form
  • Tabellenwartung:
    • Optimize
    • V-Order
    • Vacuum
Daten transformieren und analysieren mit Microsoft Fabric

Optimize

  • Fasse viele kleine Parquet-Dateien zu einer großen zusammen
    • Ideale Dateigröße: 128 MB bis 1 GB
    • Bessere Kompression und Verteilung für schnellere Reads
    • Empfohlen nach dem Laden großer Tabellen
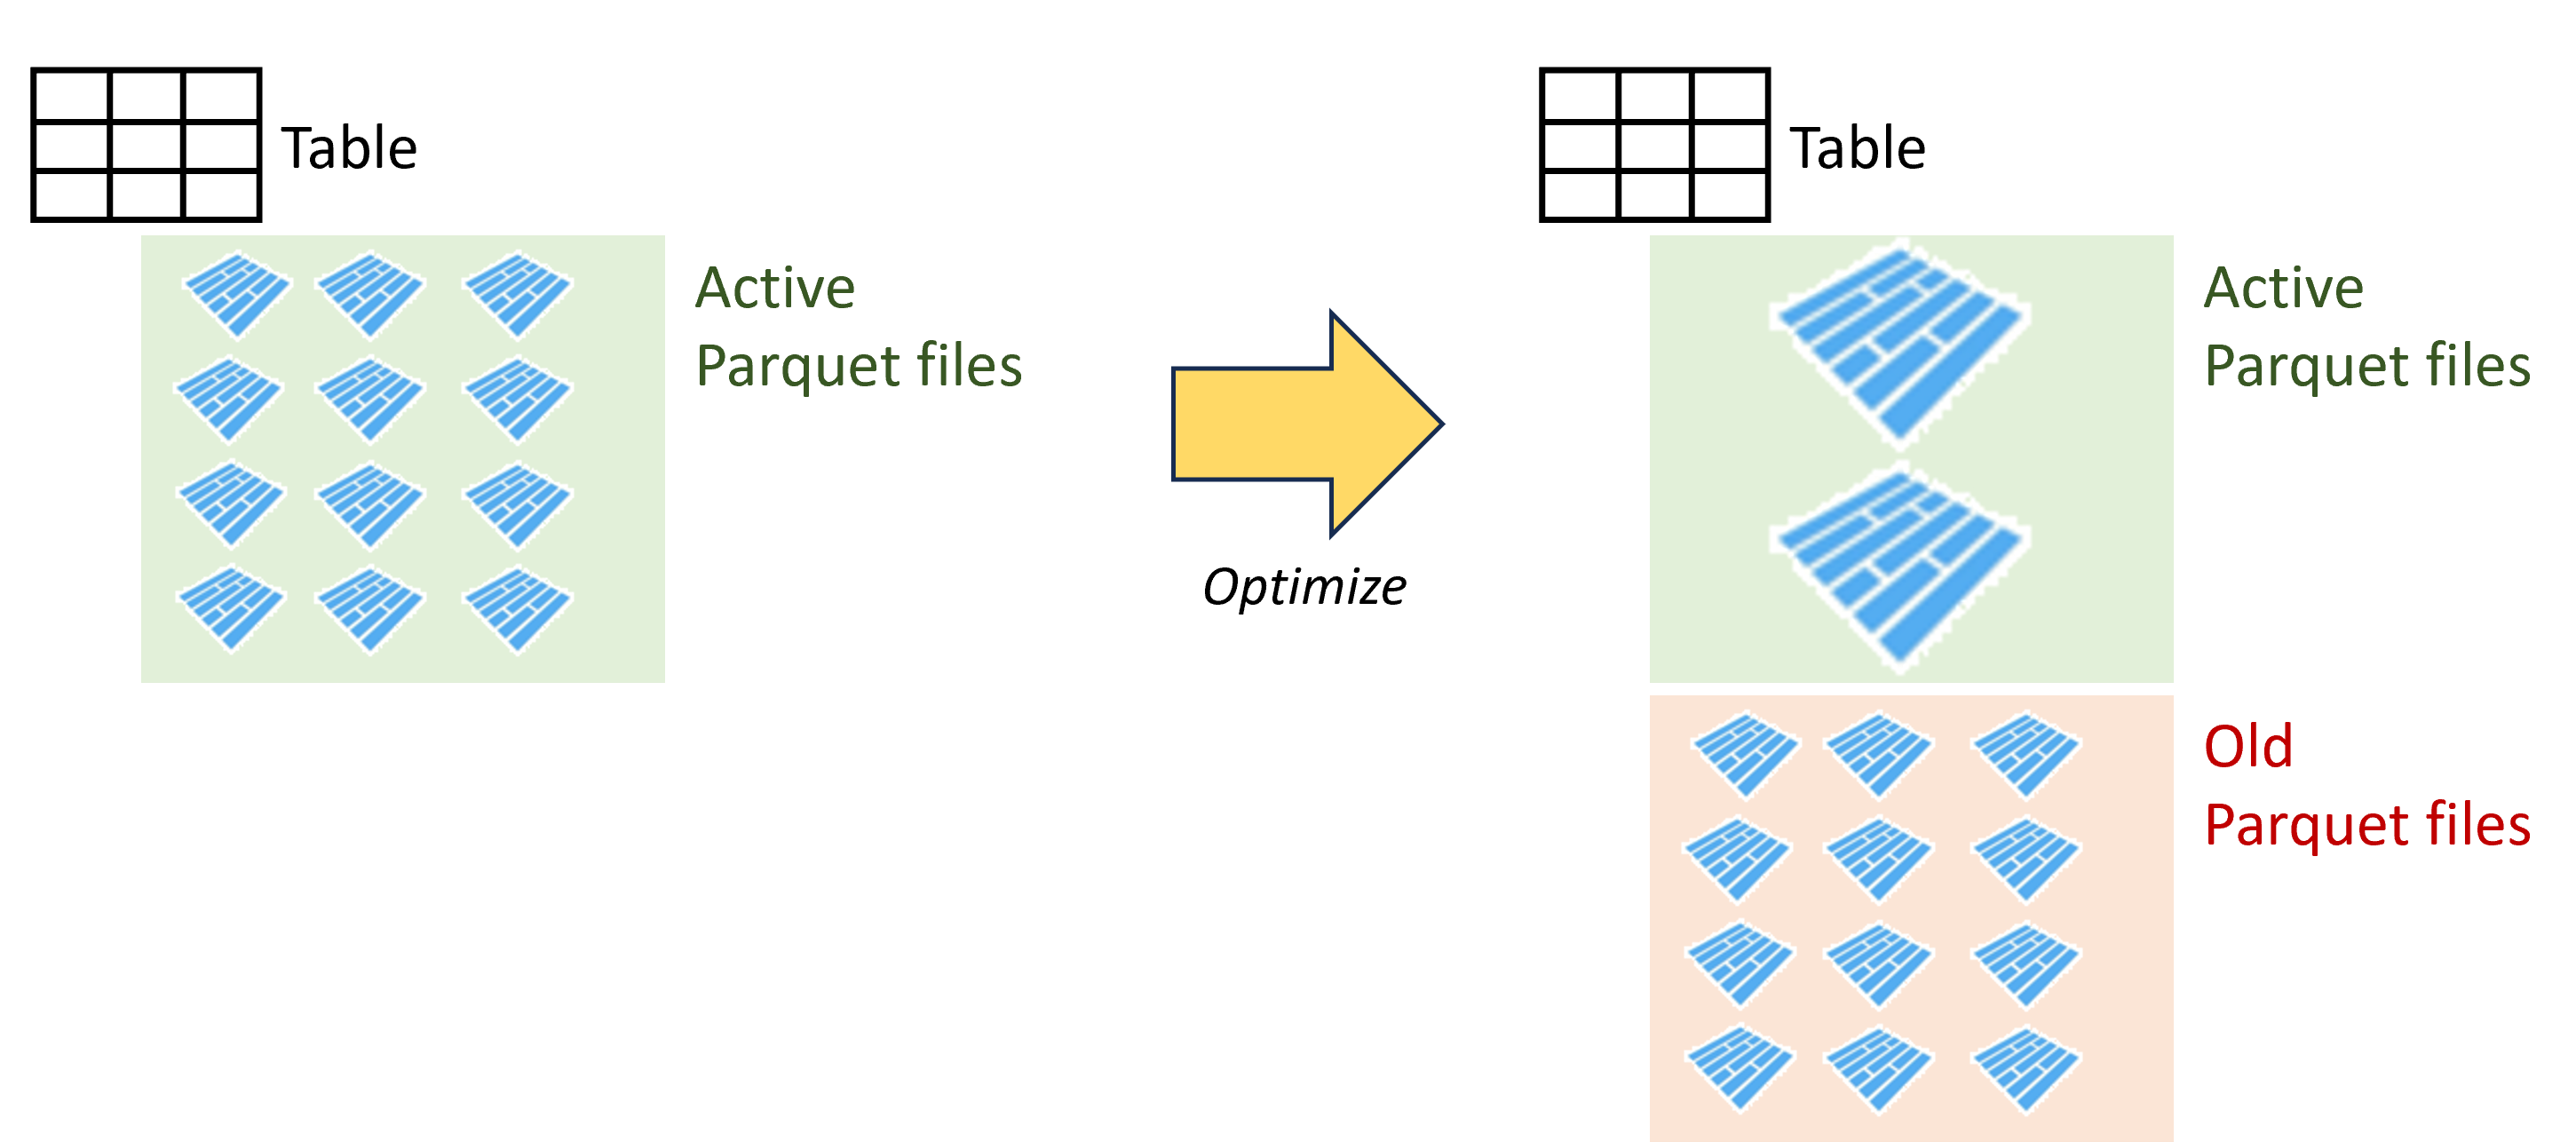
Diagramm: Eine Lakehouse-Tabelle aus vielen kleinen Parquet-Dateien wird zu zwei großen Dateien optimiert. Die Originale bleiben inaktiv

Daten transformieren und analysieren mit Microsoft Fabric

Optimize

  • Fasse viele kleine Parquet-Dateien zu einer großen zusammen
    • Ideale Dateigröße: 128 MB bis 1 GB
    • Bessere Kompression und Verteilung für schnellere Reads
    • Empfohlen nach dem Laden großer Tabellen

Diagramm: Eine Lakehouse-Tabelle aus vielen kleinen Parquet-Dateien wird zu zwei großen Dateien optimiert. Die Originale bleiben inaktiv

Daten transformieren und analysieren mit Microsoft Fabric

Optimize im Lakehouse-Explorer ausführen
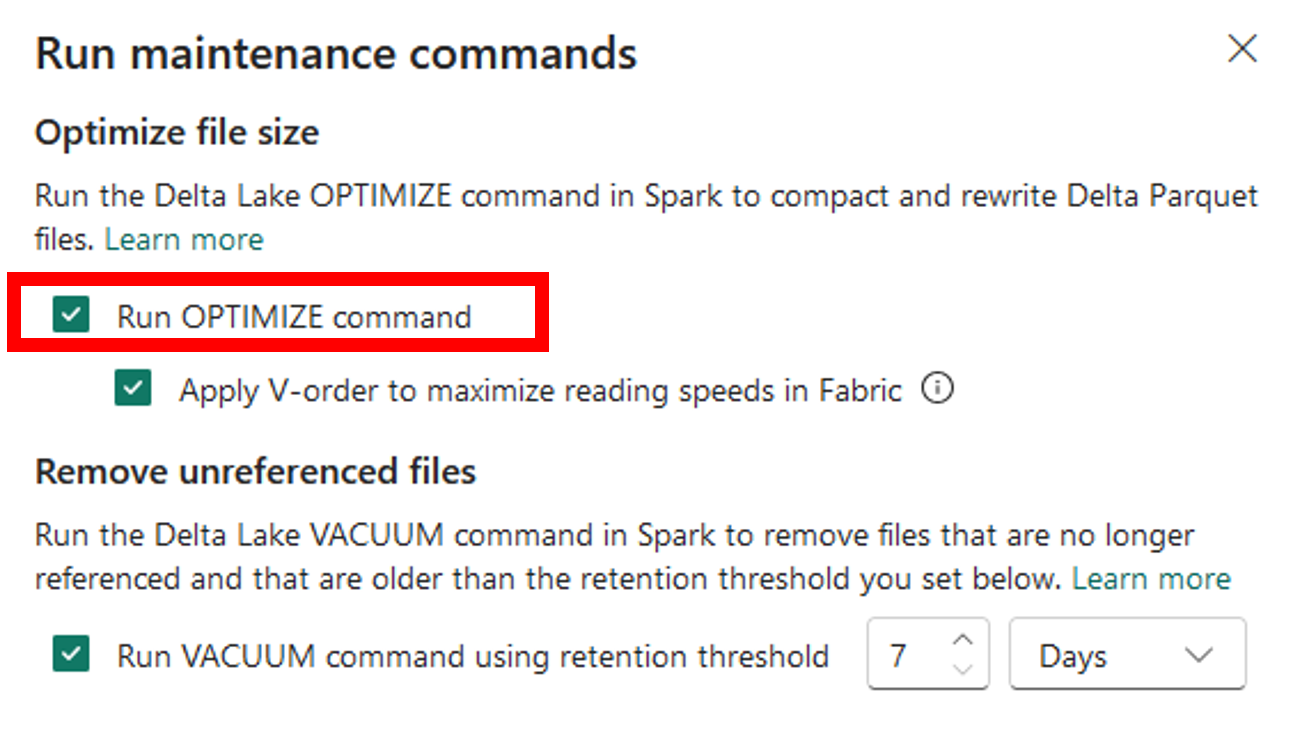
Screenshot des Wartungsbefehls im Lakehouse-Explorer, Option „Run OPTIMIZE command" markiert

Daten transformieren und analysieren mit Microsoft Fabric

Optimize in Spark SQL ausführen

%%sql
OPTIMIZE <lakehouse>.<table>;
Daten transformieren und analysieren mit Microsoft Fabric

Optimize in PySpark ausführen

from delta.tables import DeltaTable

dt = DeltaTable.forPath( spark, "Tables/<table>" )
dt.optimize().executeCompaction()
Daten transformieren und analysieren mit Microsoft Fabric

V-Order

  • Spezielle Optimierung beim Schreiben von Parquet-Dateien
  • Standardmäßig aktiviert
Daten transformieren und analysieren mit Microsoft Fabric

V-Order im Lakehouse-Explorer anwenden
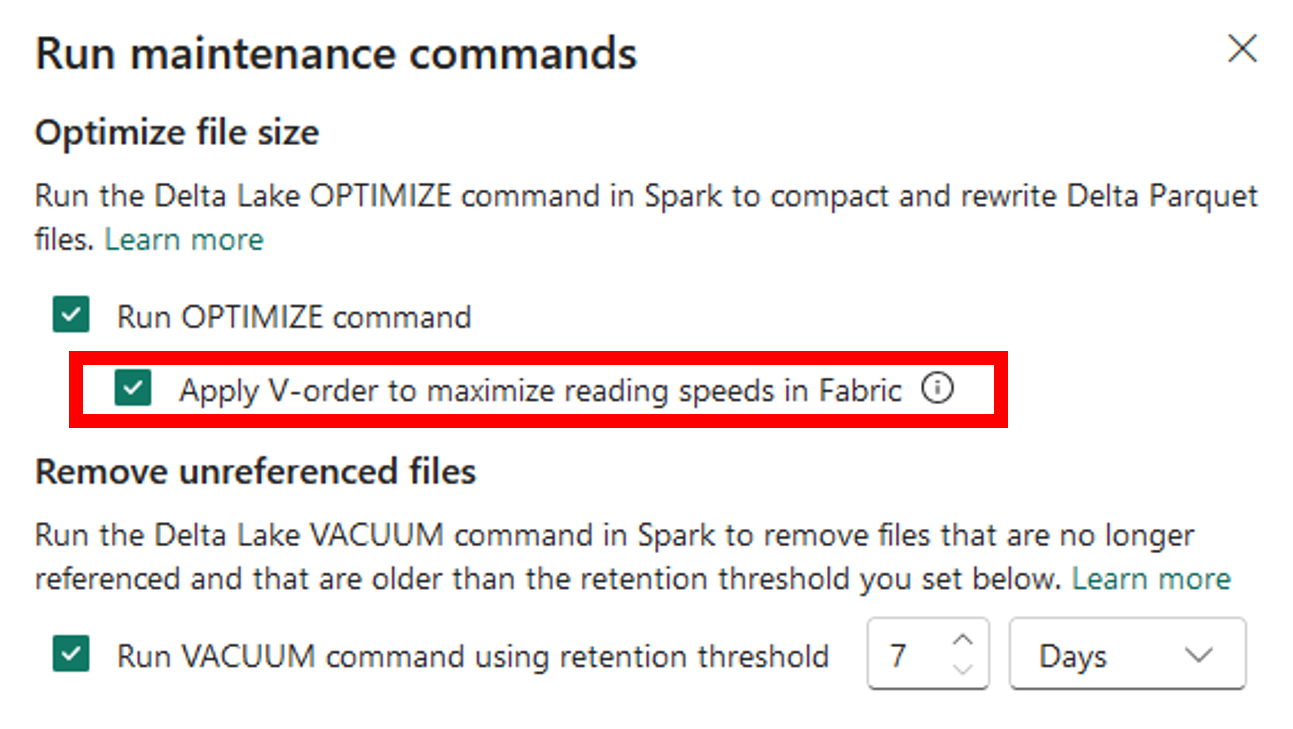
Screenshot des Wartungsbefehls im Lakehouse-Explorer, Option „Apply V-ORDER" markiert

Daten transformieren und analysieren mit Microsoft Fabric

V-Order-Schreiben in der Apache-Spark-Session steuern

  • V-Order für die Session aktivieren

    %%sql 
    SET spark.sql.parquet.vorder.enabled=TRUE


  • V-Order für die Session deaktivieren

    %%sql 
    SET spark.sql.parquet.vorder.enabled=FALSE
    
Daten transformieren und analysieren mit Microsoft Fabric

V-Order beim Optimieren einer Tabelle anwenden

%%sql 
OPTIMIZE <table|fileOrFolderPath> VORDER;
Daten transformieren und analysieren mit Microsoft Fabric

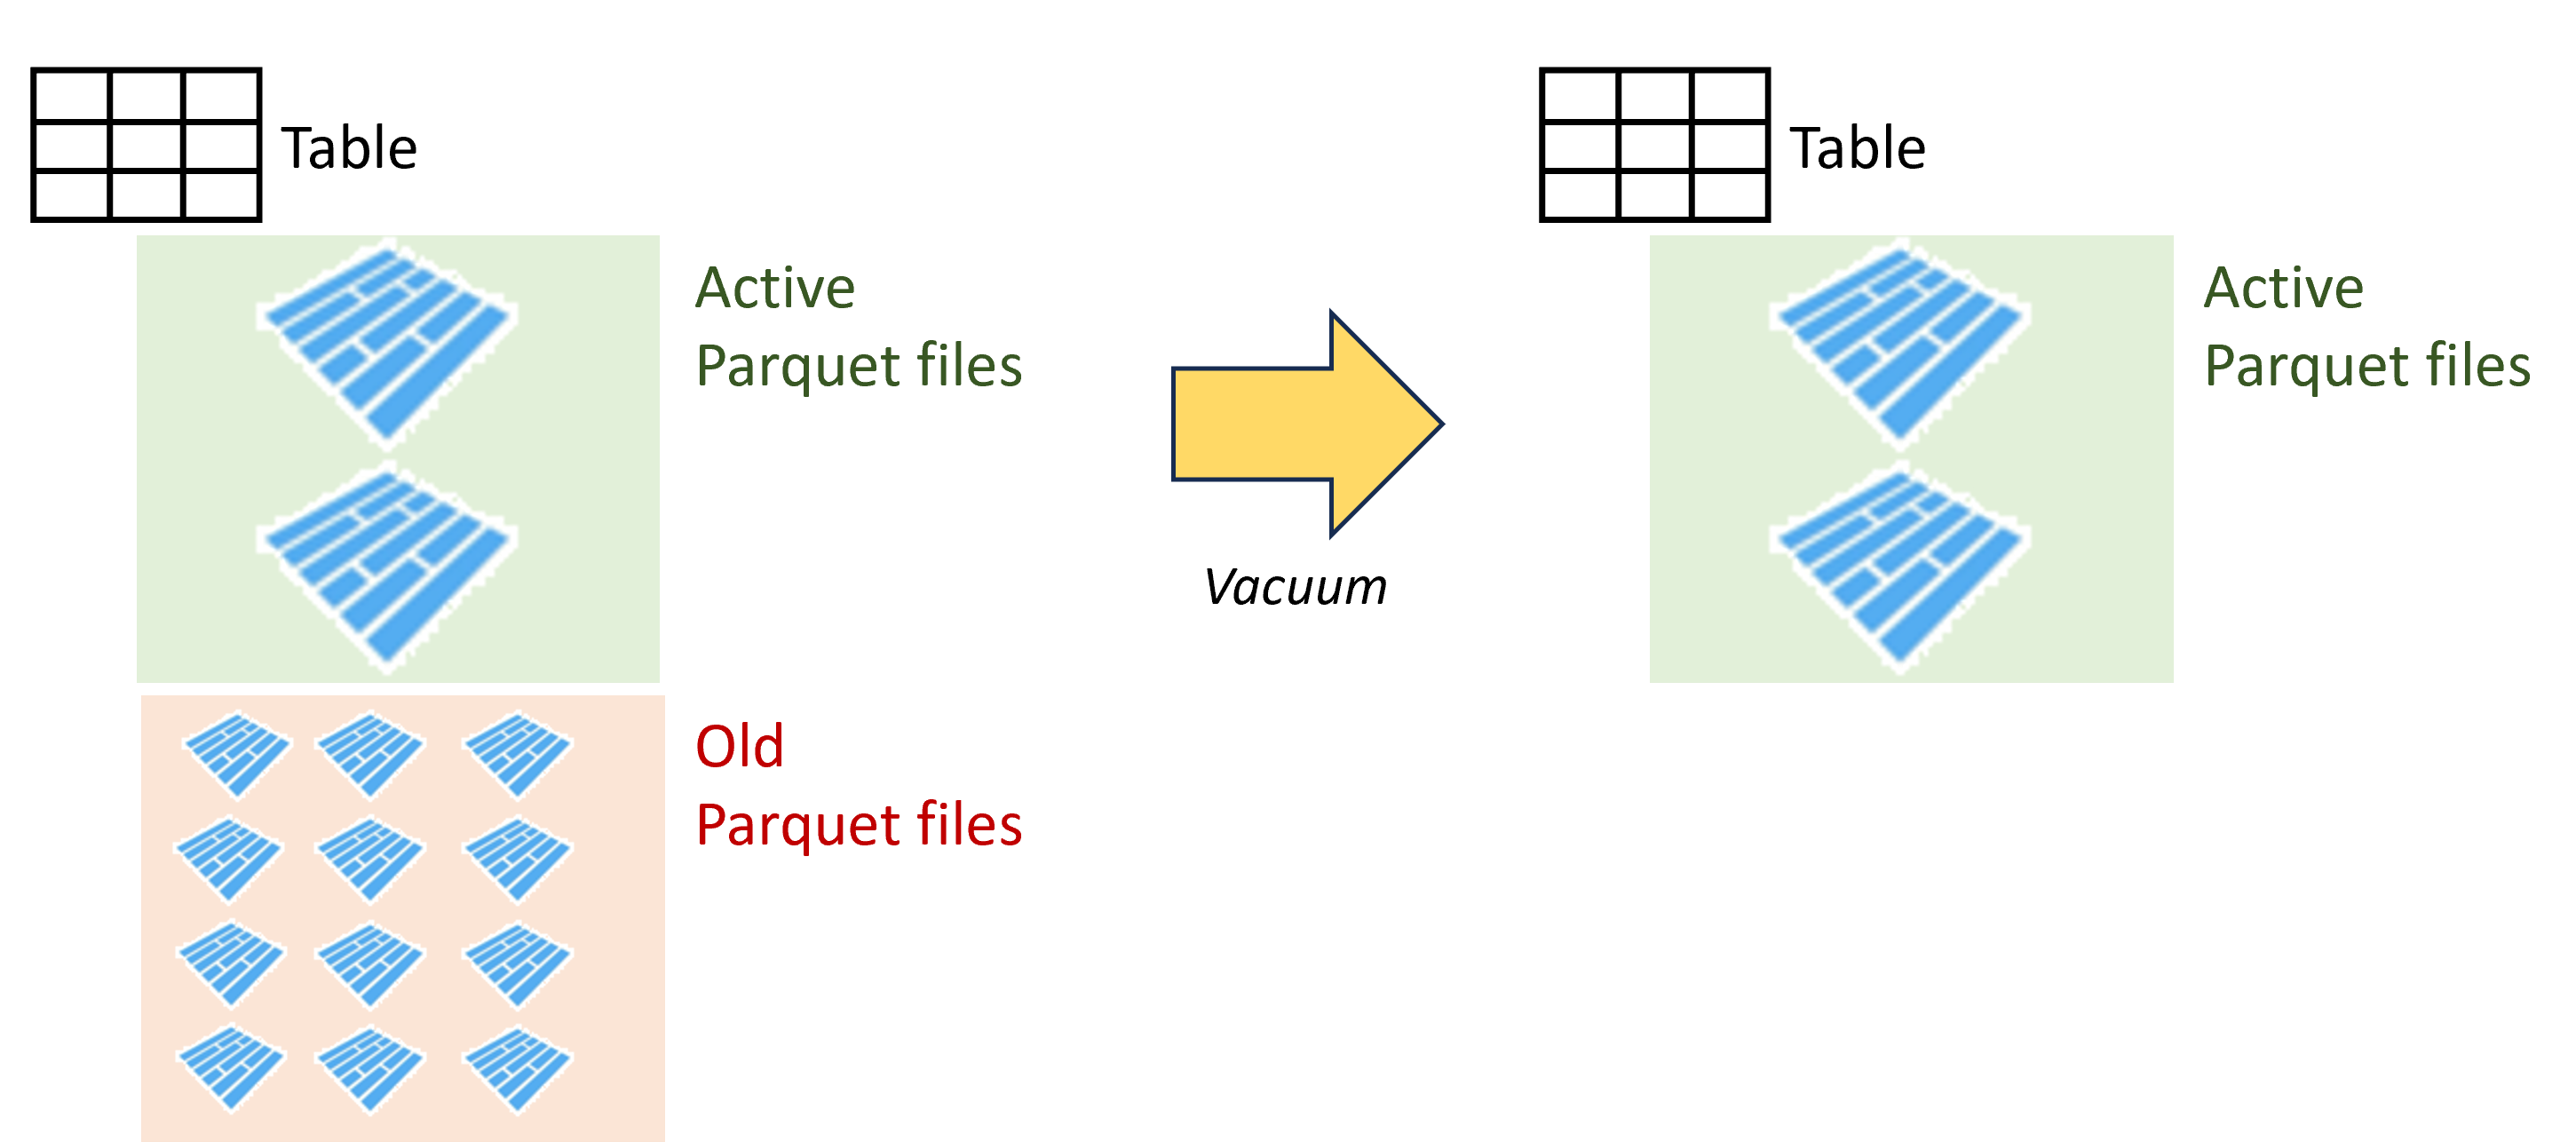
Vacuum

  • Entfernt alte, nicht mehr benötigte Dateien oberhalb der Aufbewahrungsgrenze
  • Senkt Cloud-Speicherkosten

Diagramm: Eine Lakehouse-Tabelle mit zwei aktiven großen Parquet-Dateien und vielen kleinen inaktiven Dateien. Nach Vacuum werden die alten Dateien entfernt

Daten transformieren und analysieren mit Microsoft Fabric

Vacuum im Lakehouse-Explorer ausführen
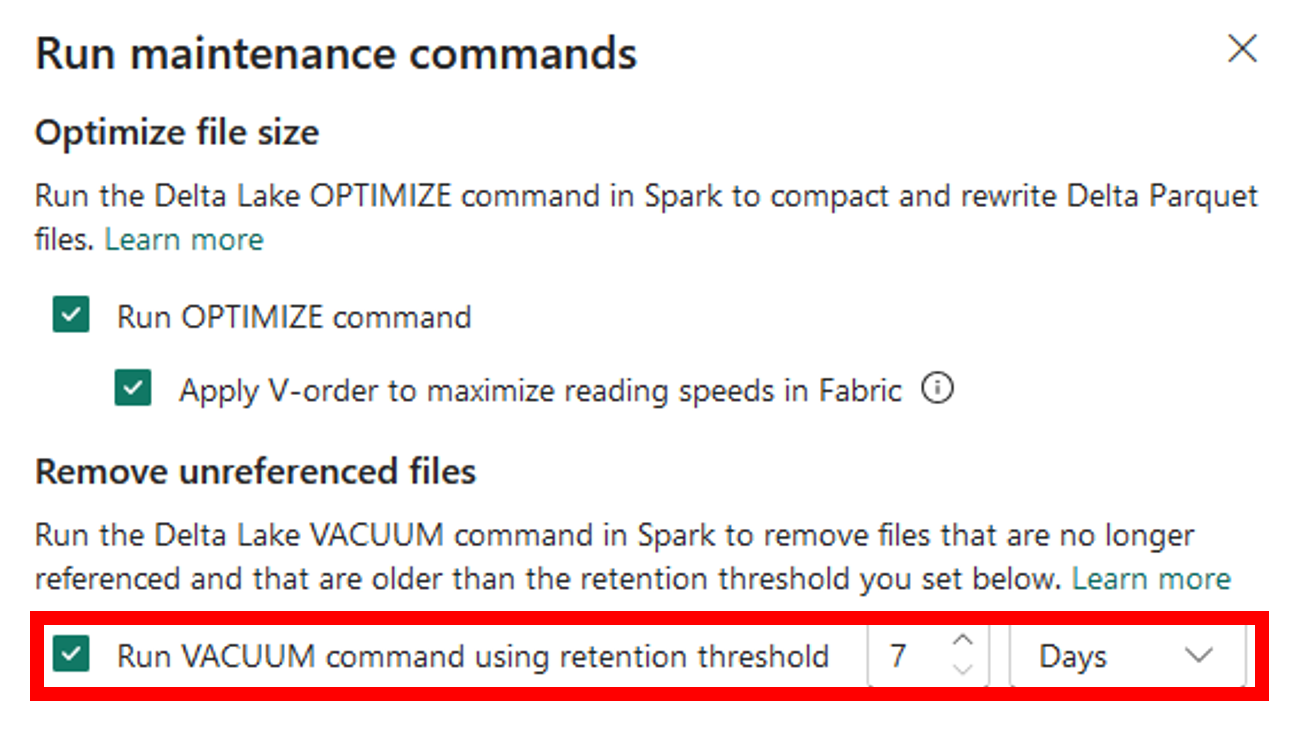
Screenshot des Wartungsbefehls im Lakehouse-Explorer, Option „Run VACUUM" markiert

Daten transformieren und analysieren mit Microsoft Fabric

Lass uns üben!

Daten transformieren und analysieren mit Microsoft Fabric

Preparing Video For Download...