Wie du deinen Baum wachsen lässt

Maschinelles Lernen mit baumbasierten Modellen in R

Sandro Raabe

Data Scientist

Diabetes-Datensatz

head(diabetes)
# A tibble: 6 x 9
  outcome pregnancies glucose blood_pressure skin_thickness insulin   bmi    age
  <fct>         <int>   <int>          <int>          <int>   <int> <dbl>  <int>
1 yes               6     148             72             35       0  33.6     50
2 no                1      85             66             29       0  26.6     31
3 yes               8     183             64              0       0  23.3     32
Maschinelles Lernen mit baumbasierten Modellen in R

Den ganzen Datensatz nutzen

  • Du hast alle Daten zum Trainieren genutzt – nichts bleibt zum Testen des Modells
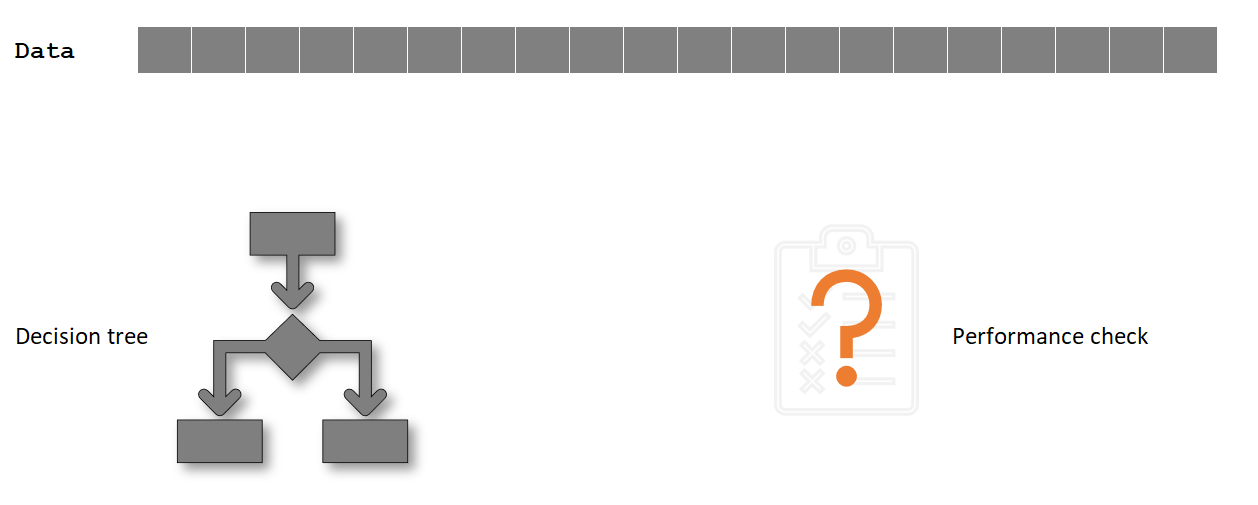
model_flow_1

Maschinelles Lernen mit baumbasierten Modellen in R

Daten splitten

datasplit

model and evaluation

Maschinelles Lernen mit baumbasierten Modellen in R

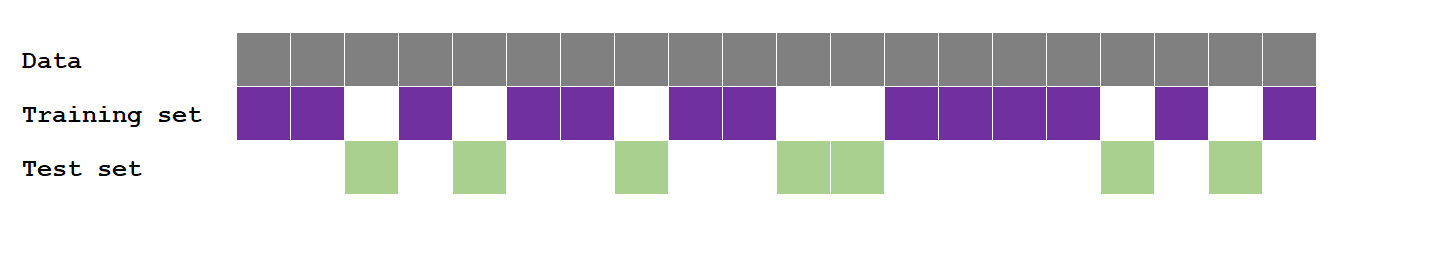
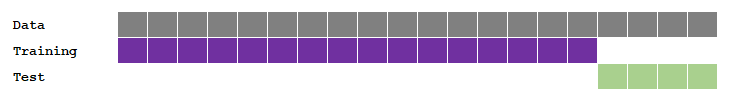
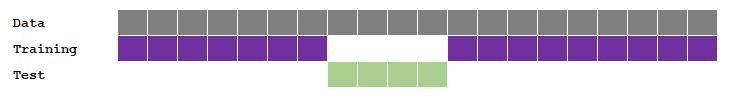
Split-Methoden

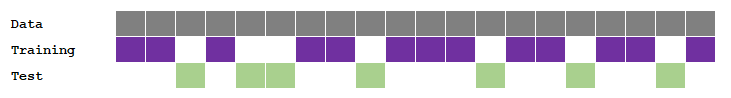
splitting methods

splitting_methods2

splitting_methods3

Maschinelles Lernen mit baumbasierten Modellen in R

Die Funktion initial_split()

  • Teilt Daten zufällig in genau ein Trainings- und ein Testset
# Daten anteilig splitten (Standard: 0.75)
diabetes_split <- initial_split(diabetes, prop = 0.9)
diabetes_split
<Analysis/Assess/Total>
<692/76/768>
1 aus dem Paket rsample
Maschinelles Lernen mit baumbasierten Modellen in R

Funktionen training() und testing()

  • Trainings- und Testset aus einem Split extrahieren
diabetes_train <- training(diabetes_split)

diabetes_test <- testing(diabetes_split)
  • Prüfung:
    nrow(diabetes_train)/nrow(diabetes)
    
[1] 0.9007812
1 aus rsample
Maschinelles Lernen mit baumbasierten Modellen in R

Klassenungleichgewichte vermeiden

# Anzahl der 'yes'‑ und 'no'‑Outcomes im Training
counts_train <- table(diabetes_train$outcome)
counts_train
 no yes 
490 86
# Anteil der 'yes'‑Outcomes im Training
prop_yes_train <- counts_train["yes"]/
                  sum(counts_train)
prop_yes_train
0.15
# Anzahl der 'yes'‑ und 'no'‑Outcomes im Test
counts_test <- table(diabetes_test$outcome)
counts_test
 no yes 
 28  48
# Anteil der 'yes'‑Outcomes im Test
prop_yes_test <- counts_test["yes"]/
                  sum(counts_test)
prop_yes_test
0.63
Maschinelles Lernen mit baumbasierten Modellen in R

Lösung – ähnliche Verteilungen erzwingen

initial_split(diabetes, 
              prop = 0.9, 
              strata = outcome)
  • Sorgt für einen zufälligen Split mit ähnlicher Verteilung der Variable outcome
Maschinelles Lernen mit baumbasierten Modellen in R

Lass uns splitten!

Maschinelles Lernen mit baumbasierten Modellen in R

Preparing Video For Download...