Desgranando el Transformer

Modelos Transformer con PyTorch

James Chapman

Curriculum Manager, DataCamp

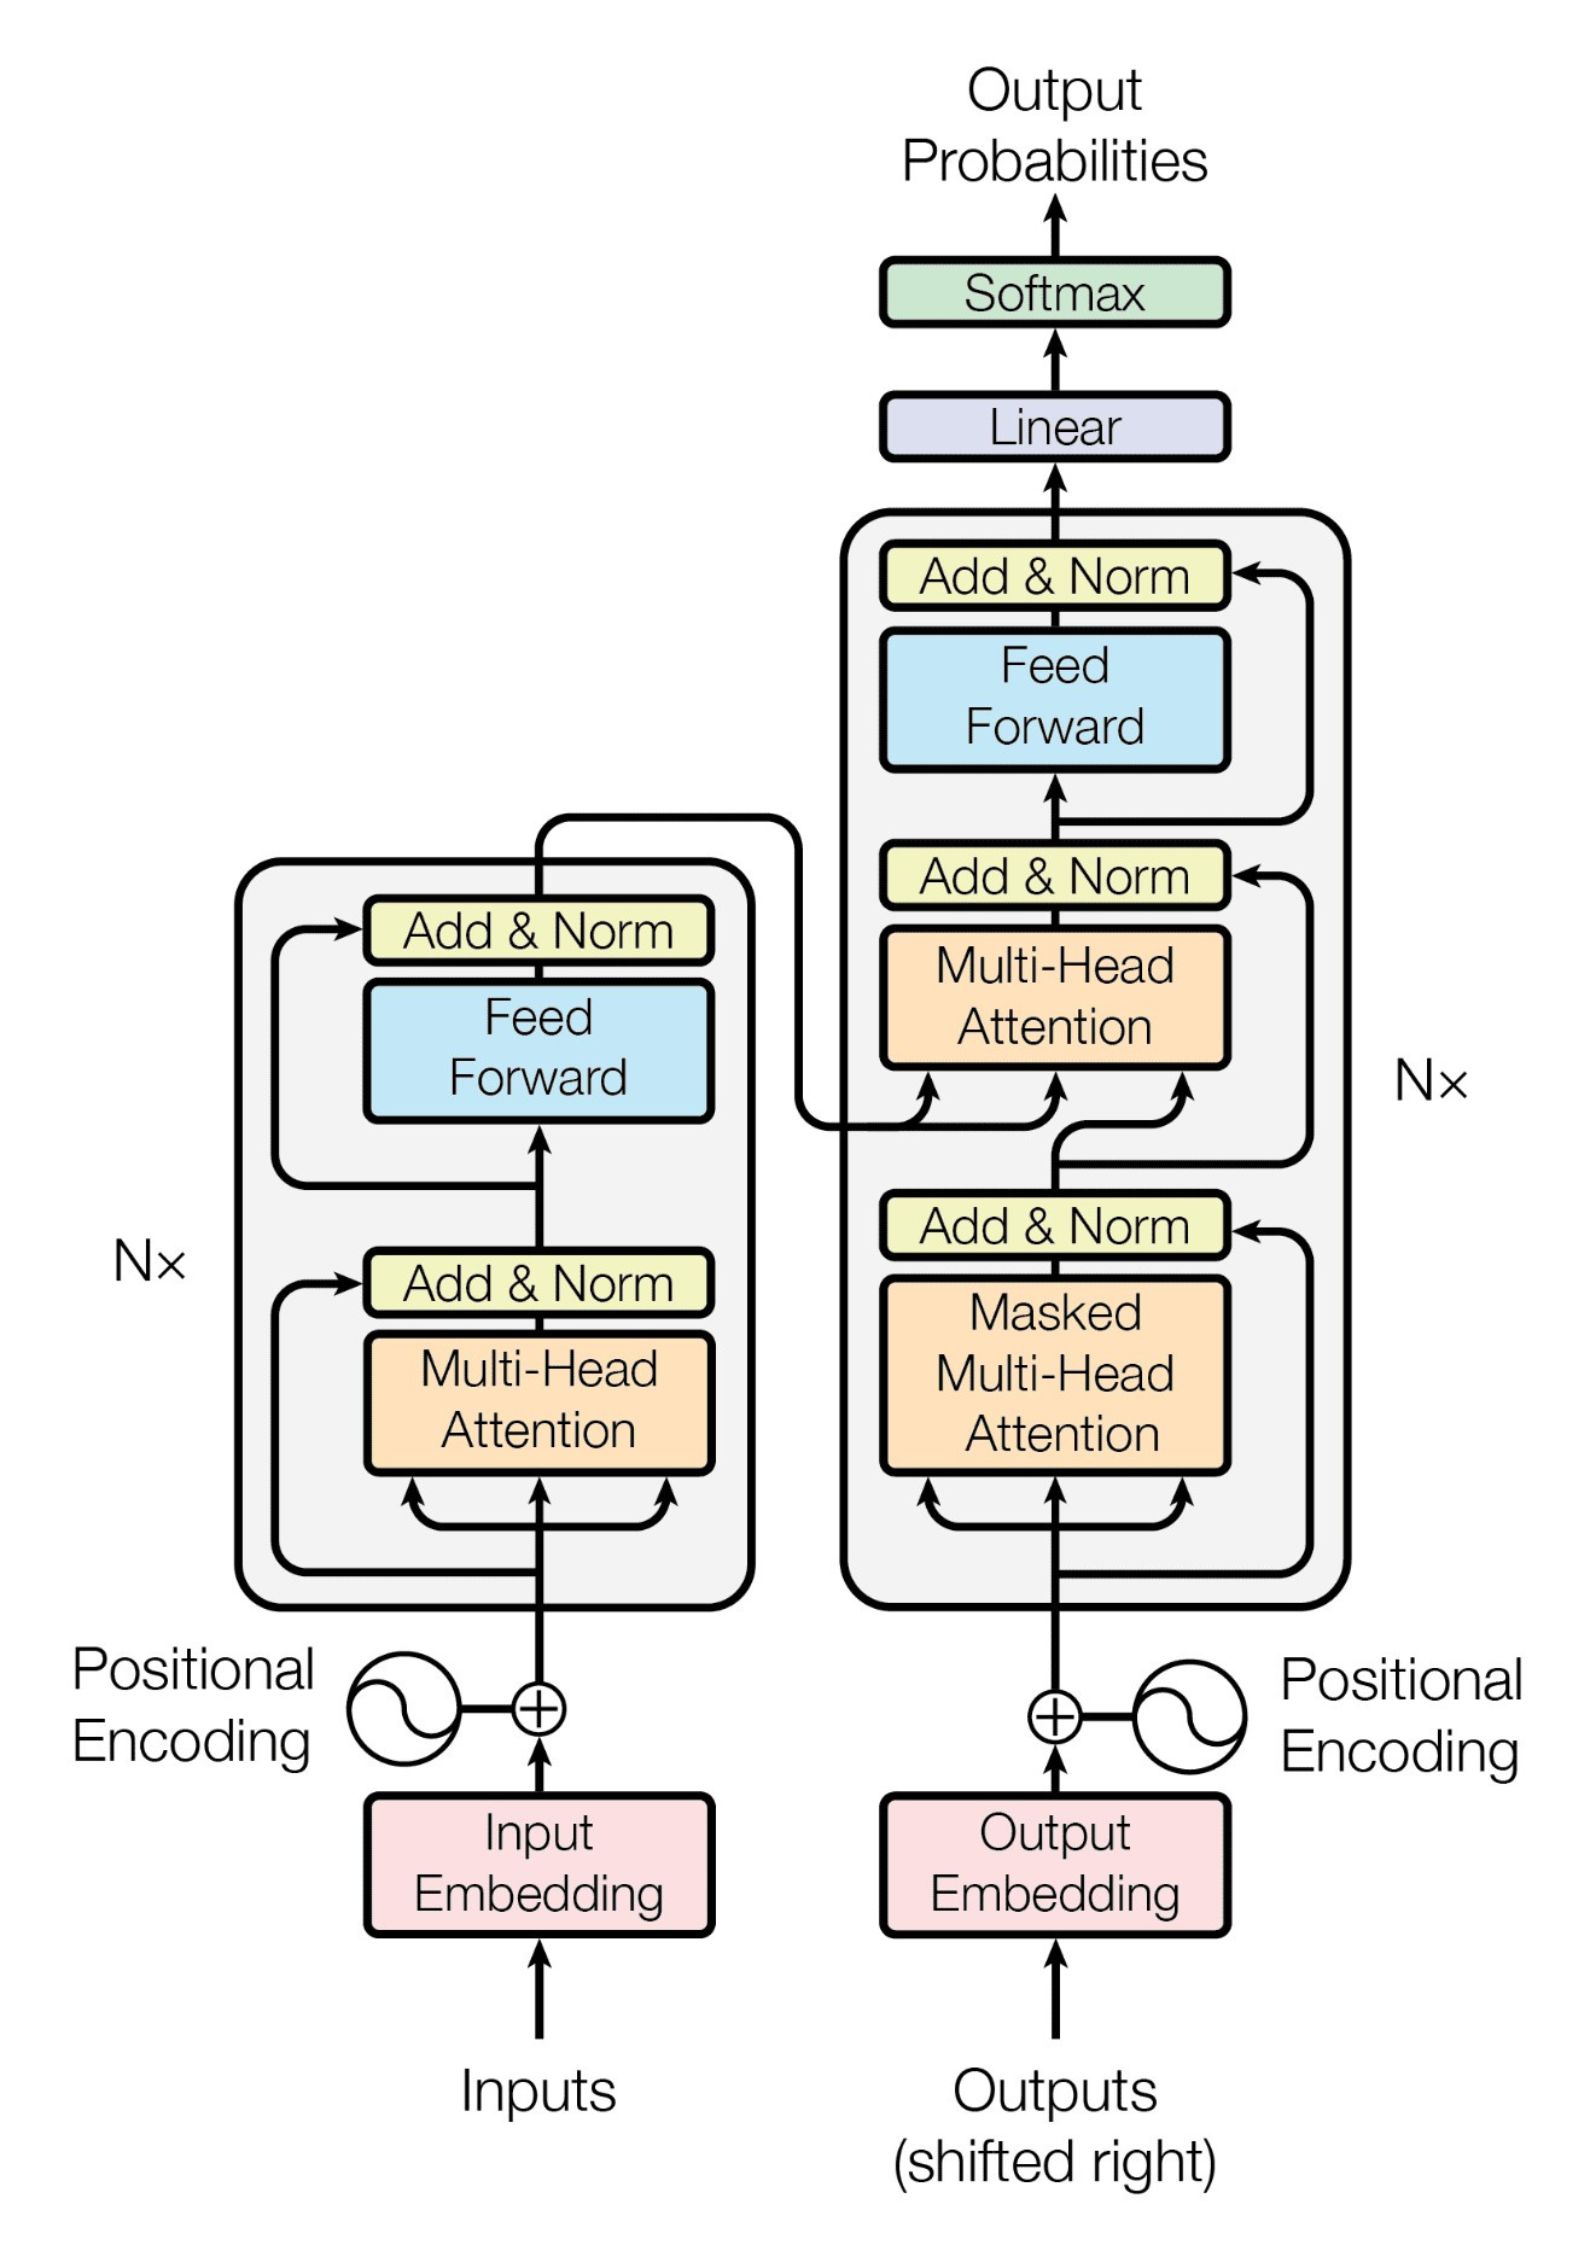
El artículo que lo cambió todo...


  • Attention Is All You Need, de Ashish Vaswani et al. (arXiv:1706.03762)
    • Mecanismos de atención
    • Optimizado para modelado de texto
    • Usado en Large Language Models (LLMs)

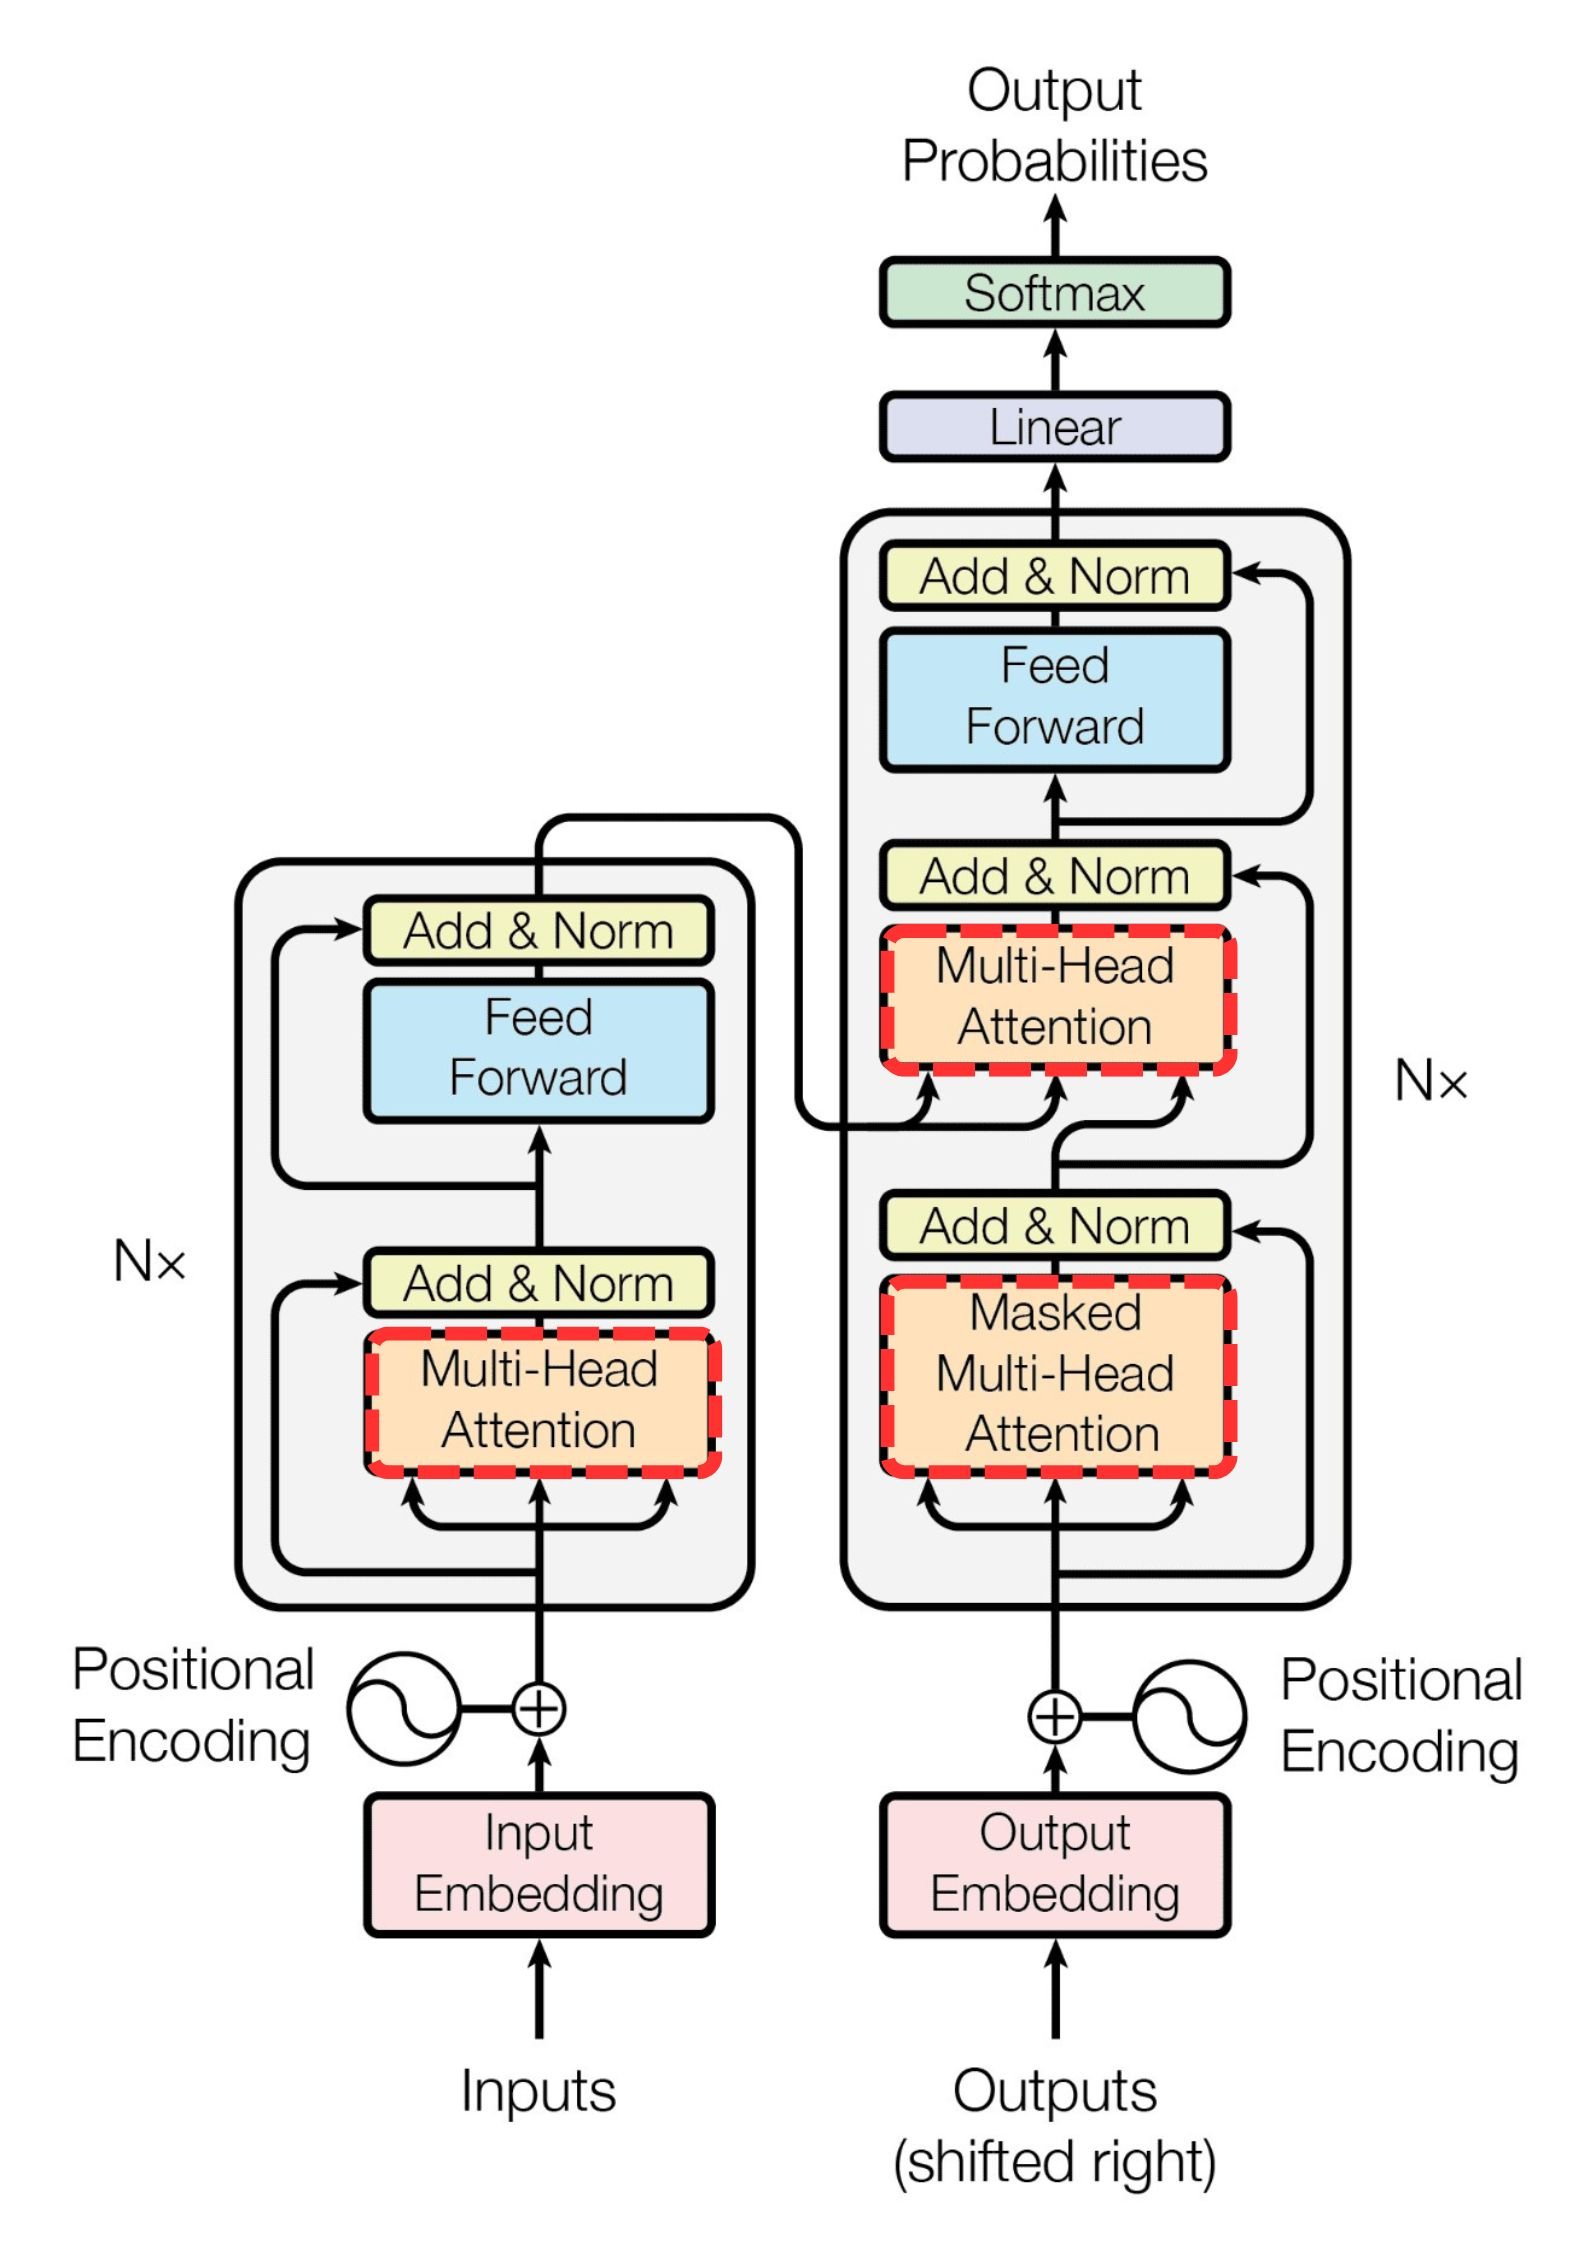
La arquitectura Transformer tal como aparece en el artículo académico Attention Is All You Need.

Modelos Transformer con PyTorch

El artículo que lo cambió todo...


  • Attention Is All You Need, de Ashish Vaswani et al.
    • Mecanismos de atención
    • Optimizado para modelado de texto
    • Usado en Large Language Models (LLMs)

La arquitectura Transformer tal como aparece en el artículo académico Attention Is All You Need.

Modelos Transformer con PyTorch

El artículo que lo cambió todo...


  • Attention Is All You Need, de Ashish Vaswani et al.
    • Mecanismos de atención
    • Optimizado para modelado de texto
    • Usado en Large Language Models (LLMs)

La arquitectura Transformer tal como aparece en el artículo académico Attention Is All You Need.

Modelos Transformer con PyTorch

Desgranando el Transformer...


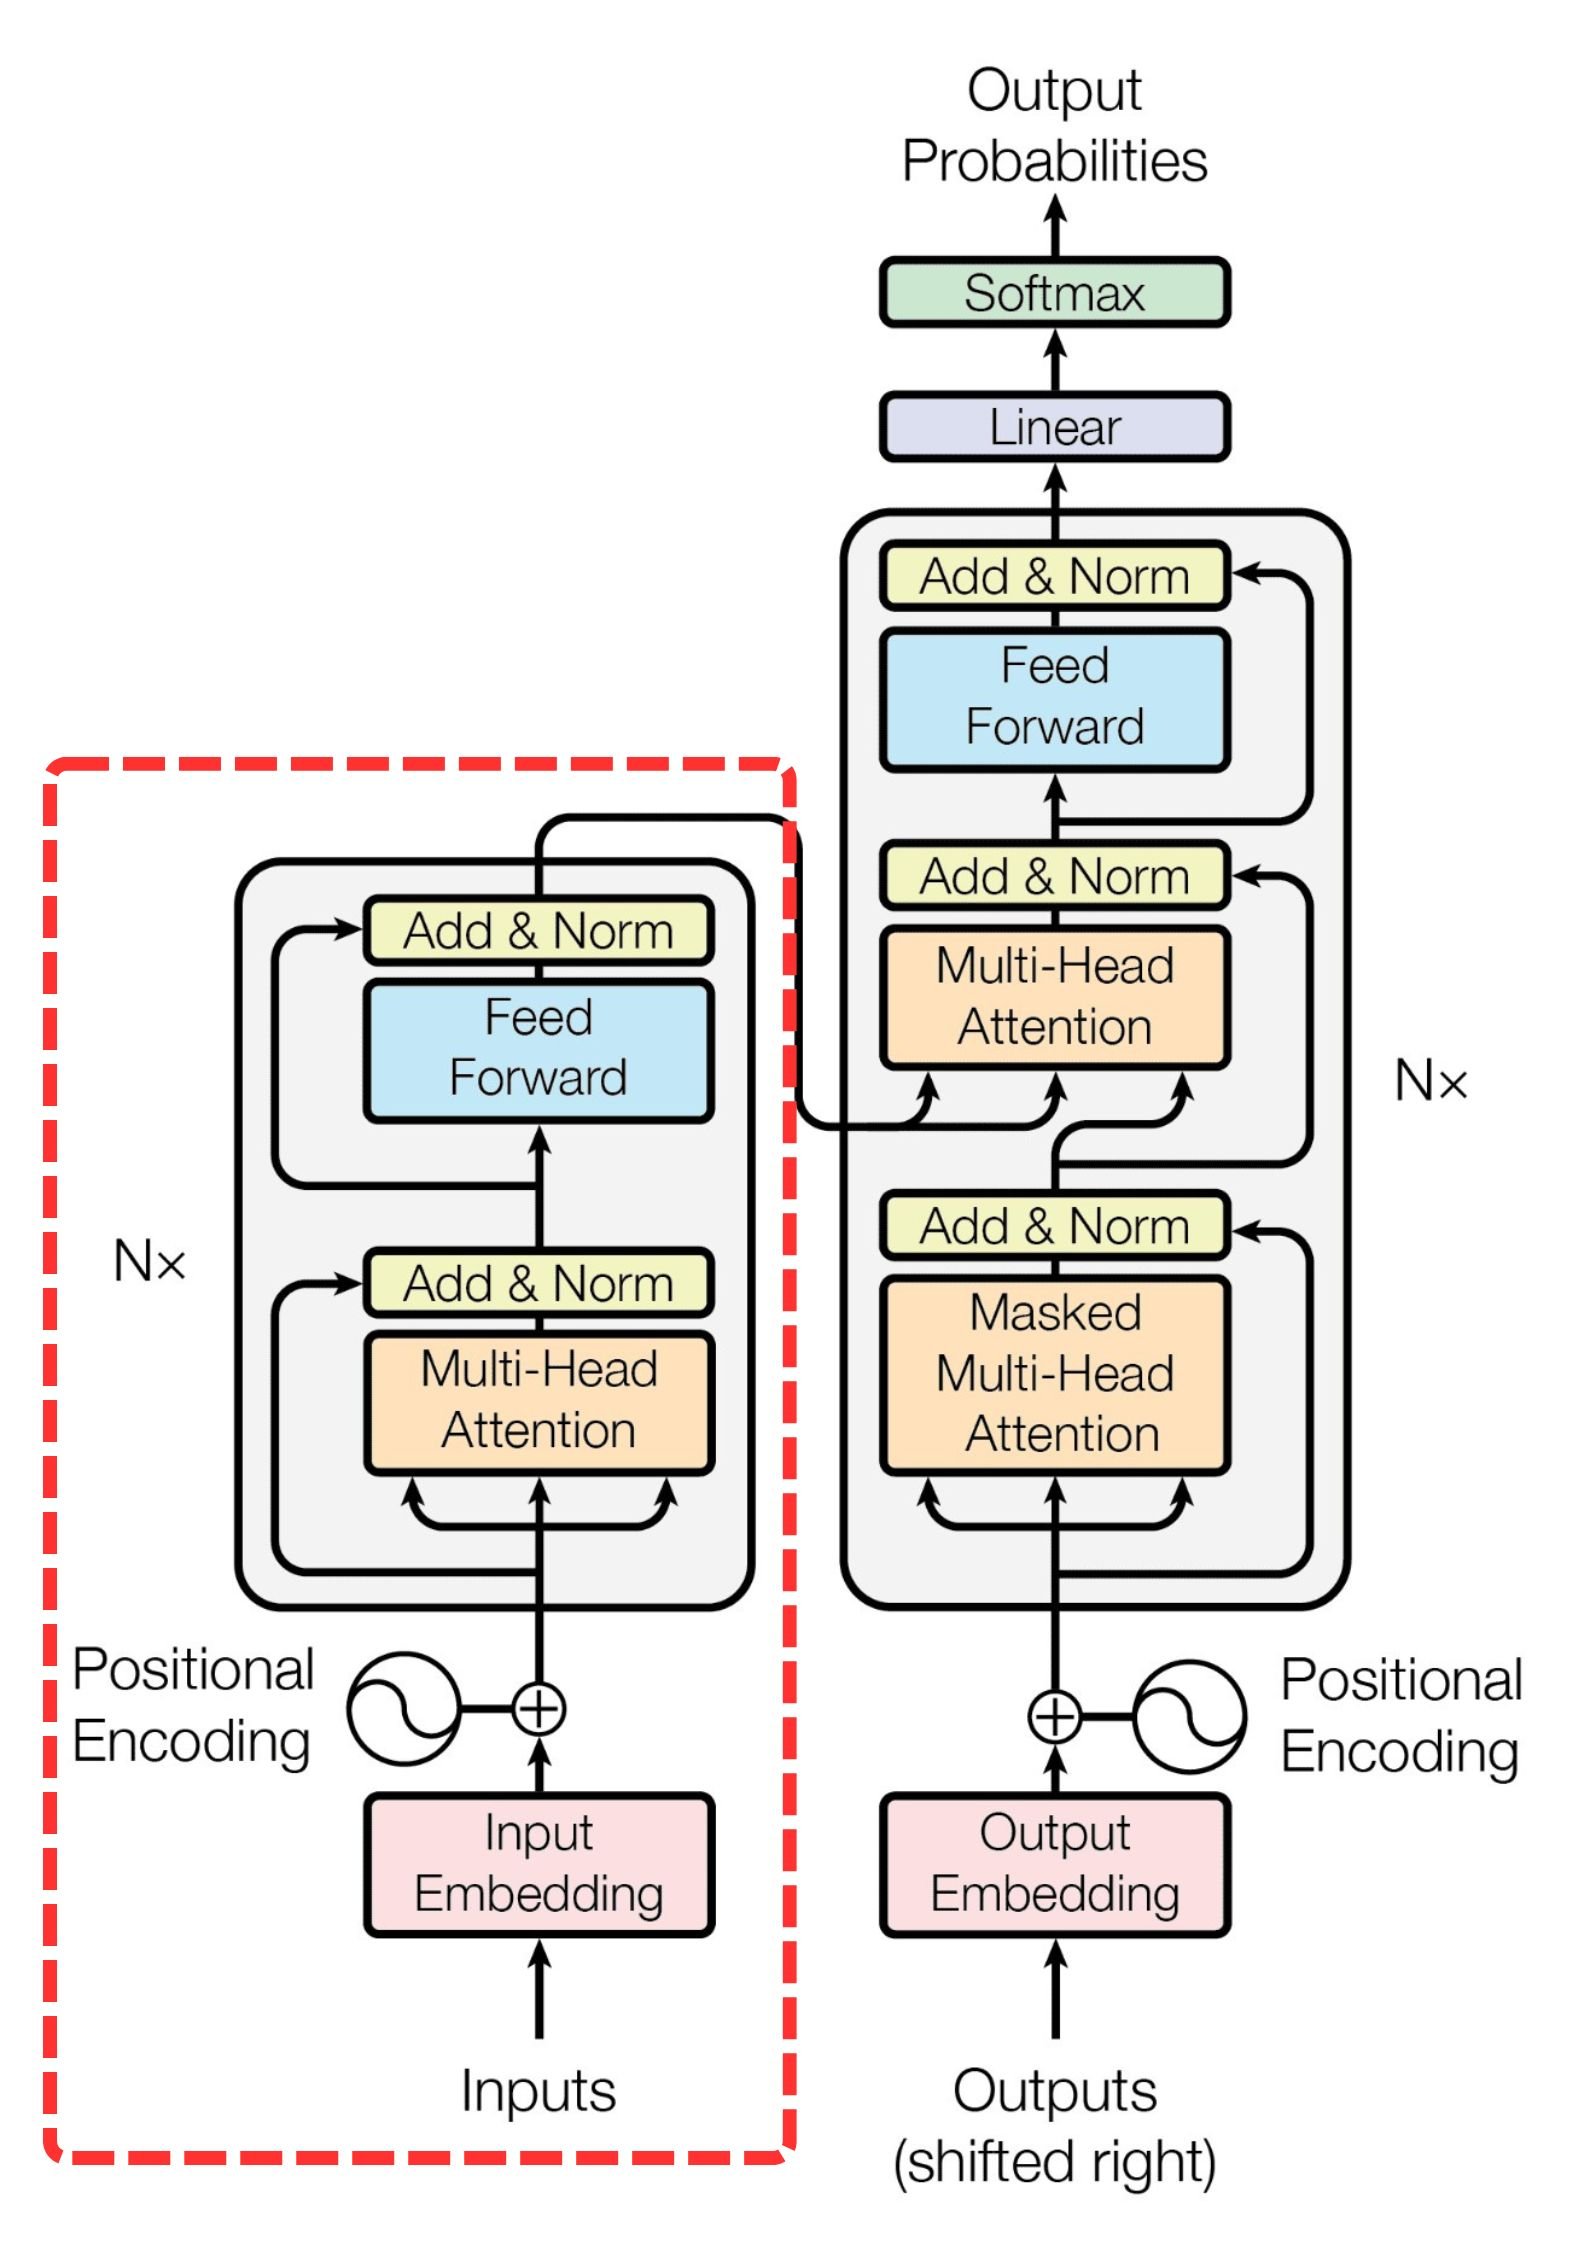
Bloque codificador (Encoder)
  • Varias capas idénticas
  • Lee y procesa la secuencia de entrada
  • Genera representaciones numéricas con rico contexto
  • Usa self-attention y redes feed-forward

La arquitectura Transformer tal como aparece en el artículo académico Attention Is All You Need.

Modelos Transformer con PyTorch

Desgranando el Transformer...


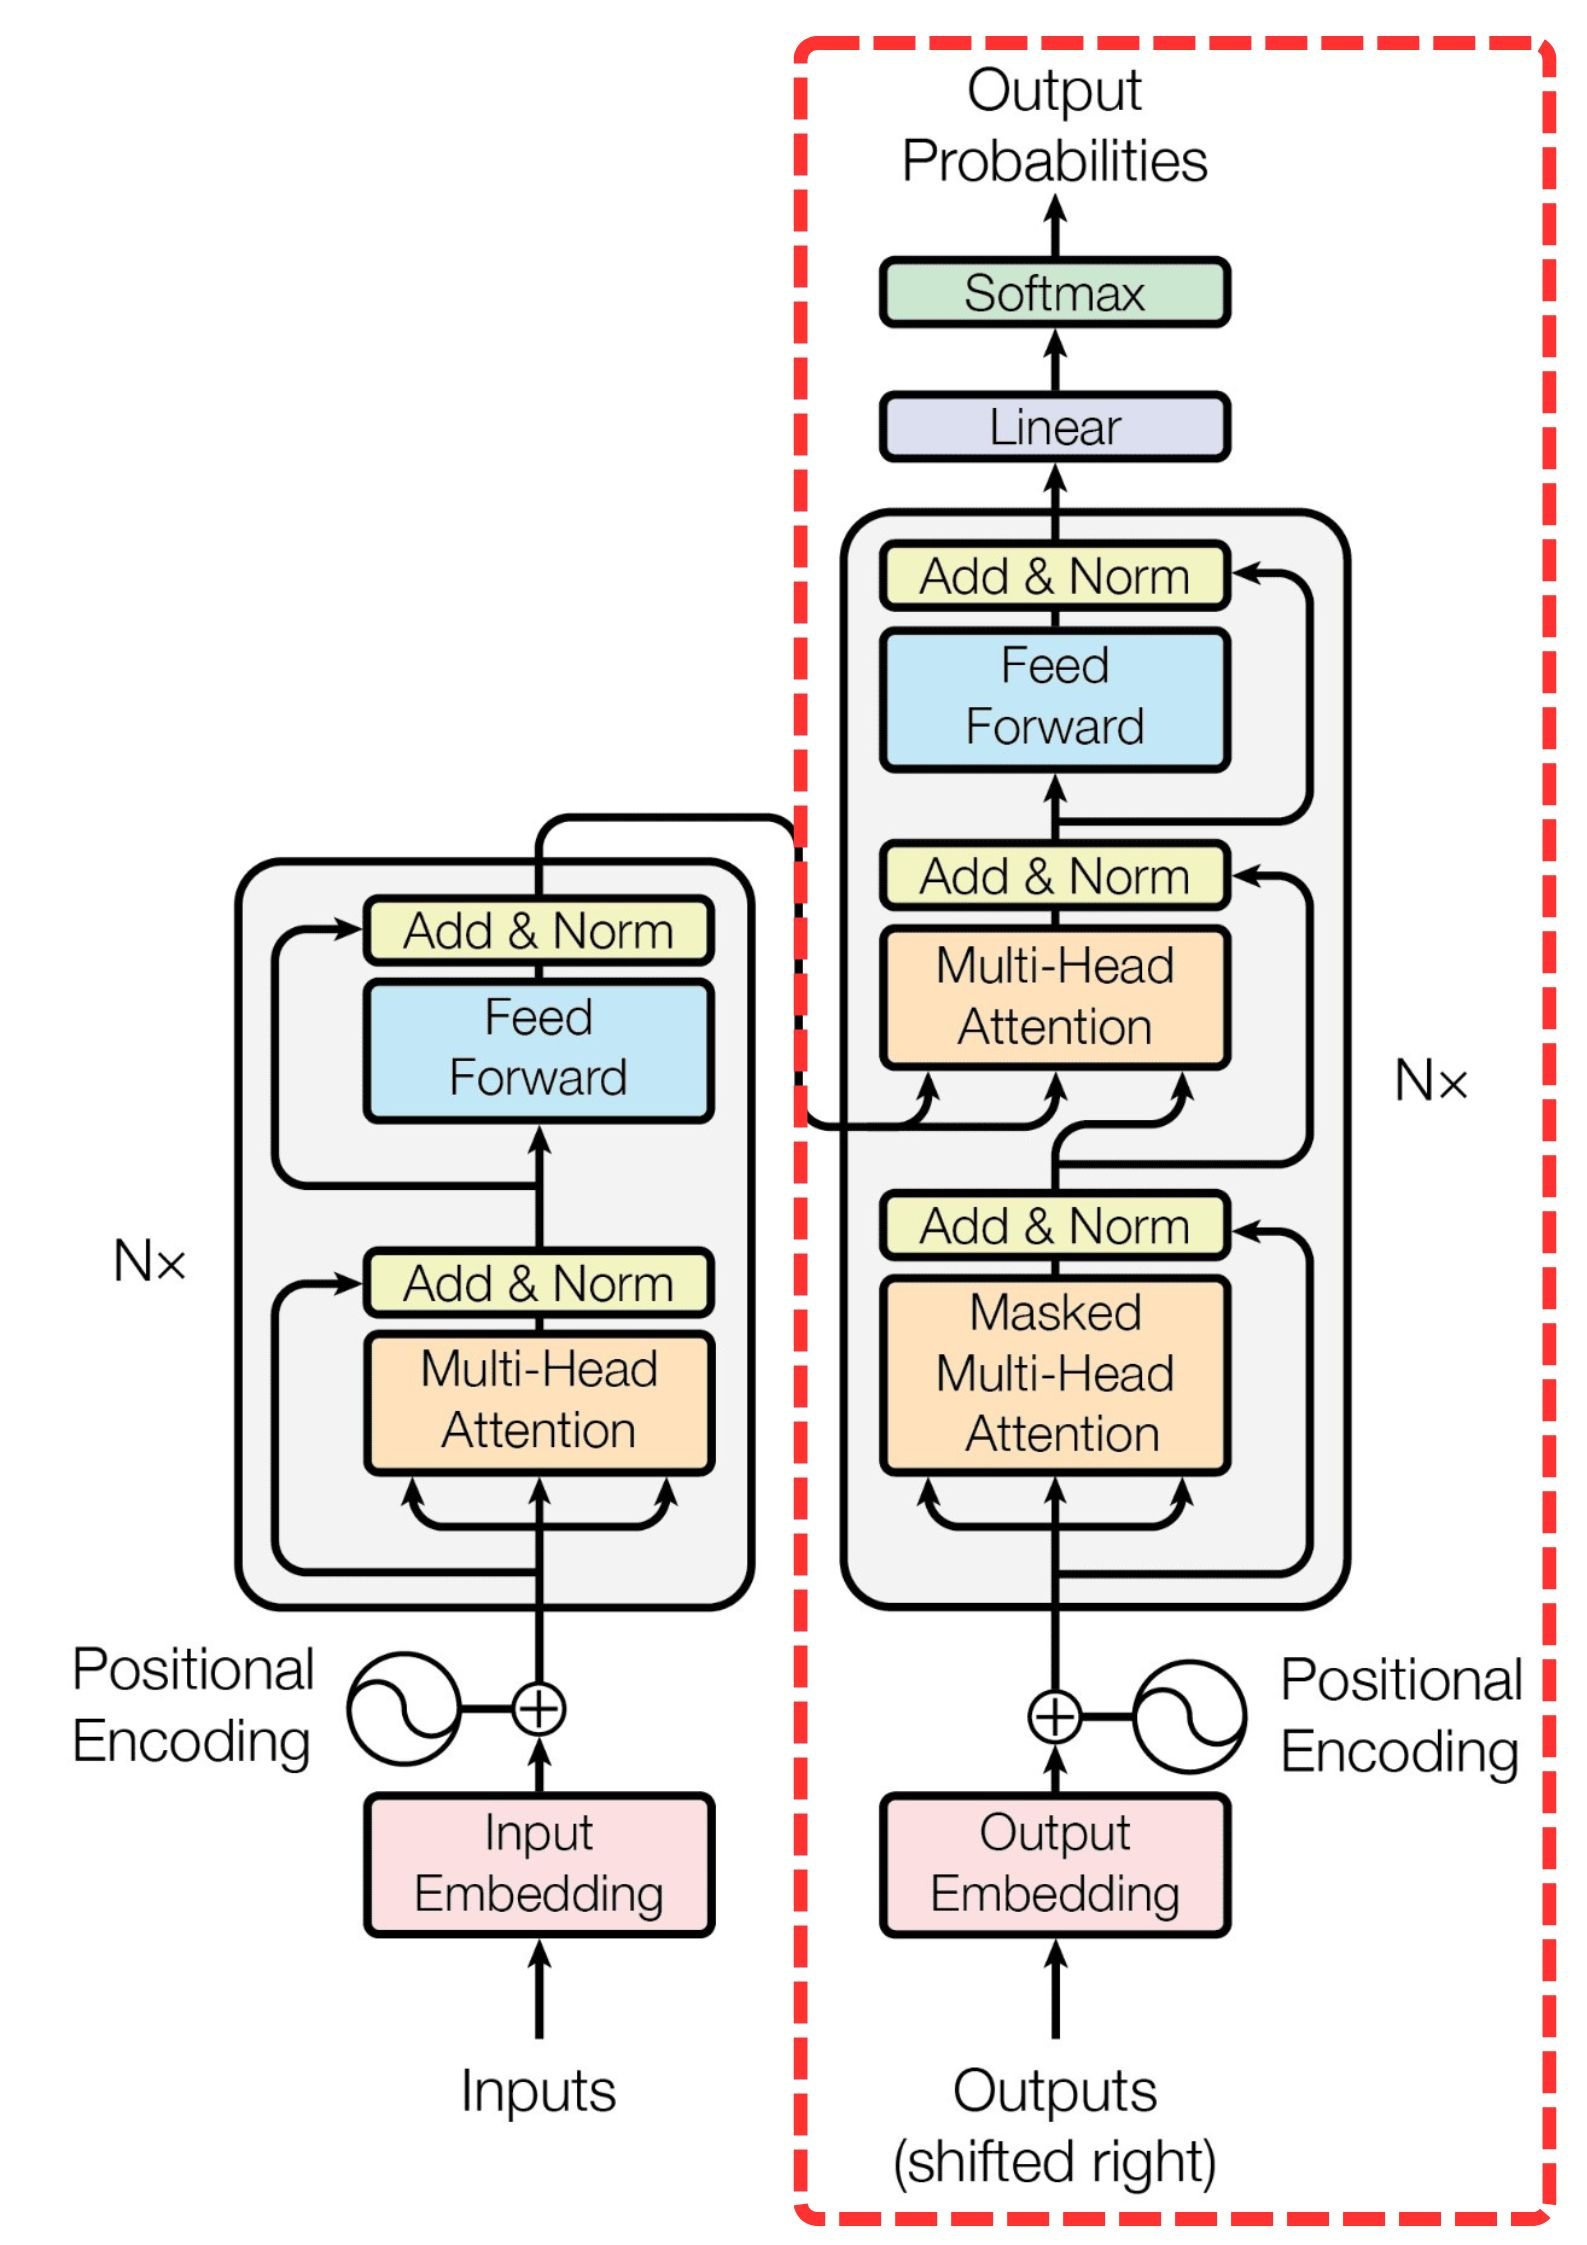
Bloque decodificador (Decoder)
  • Secuencia codificada → secuencia de salida

La arquitectura Transformer tal como aparece en el artículo académico Attention Is All You Need.

Modelos Transformer con PyTorch

Desgranando el Transformer...


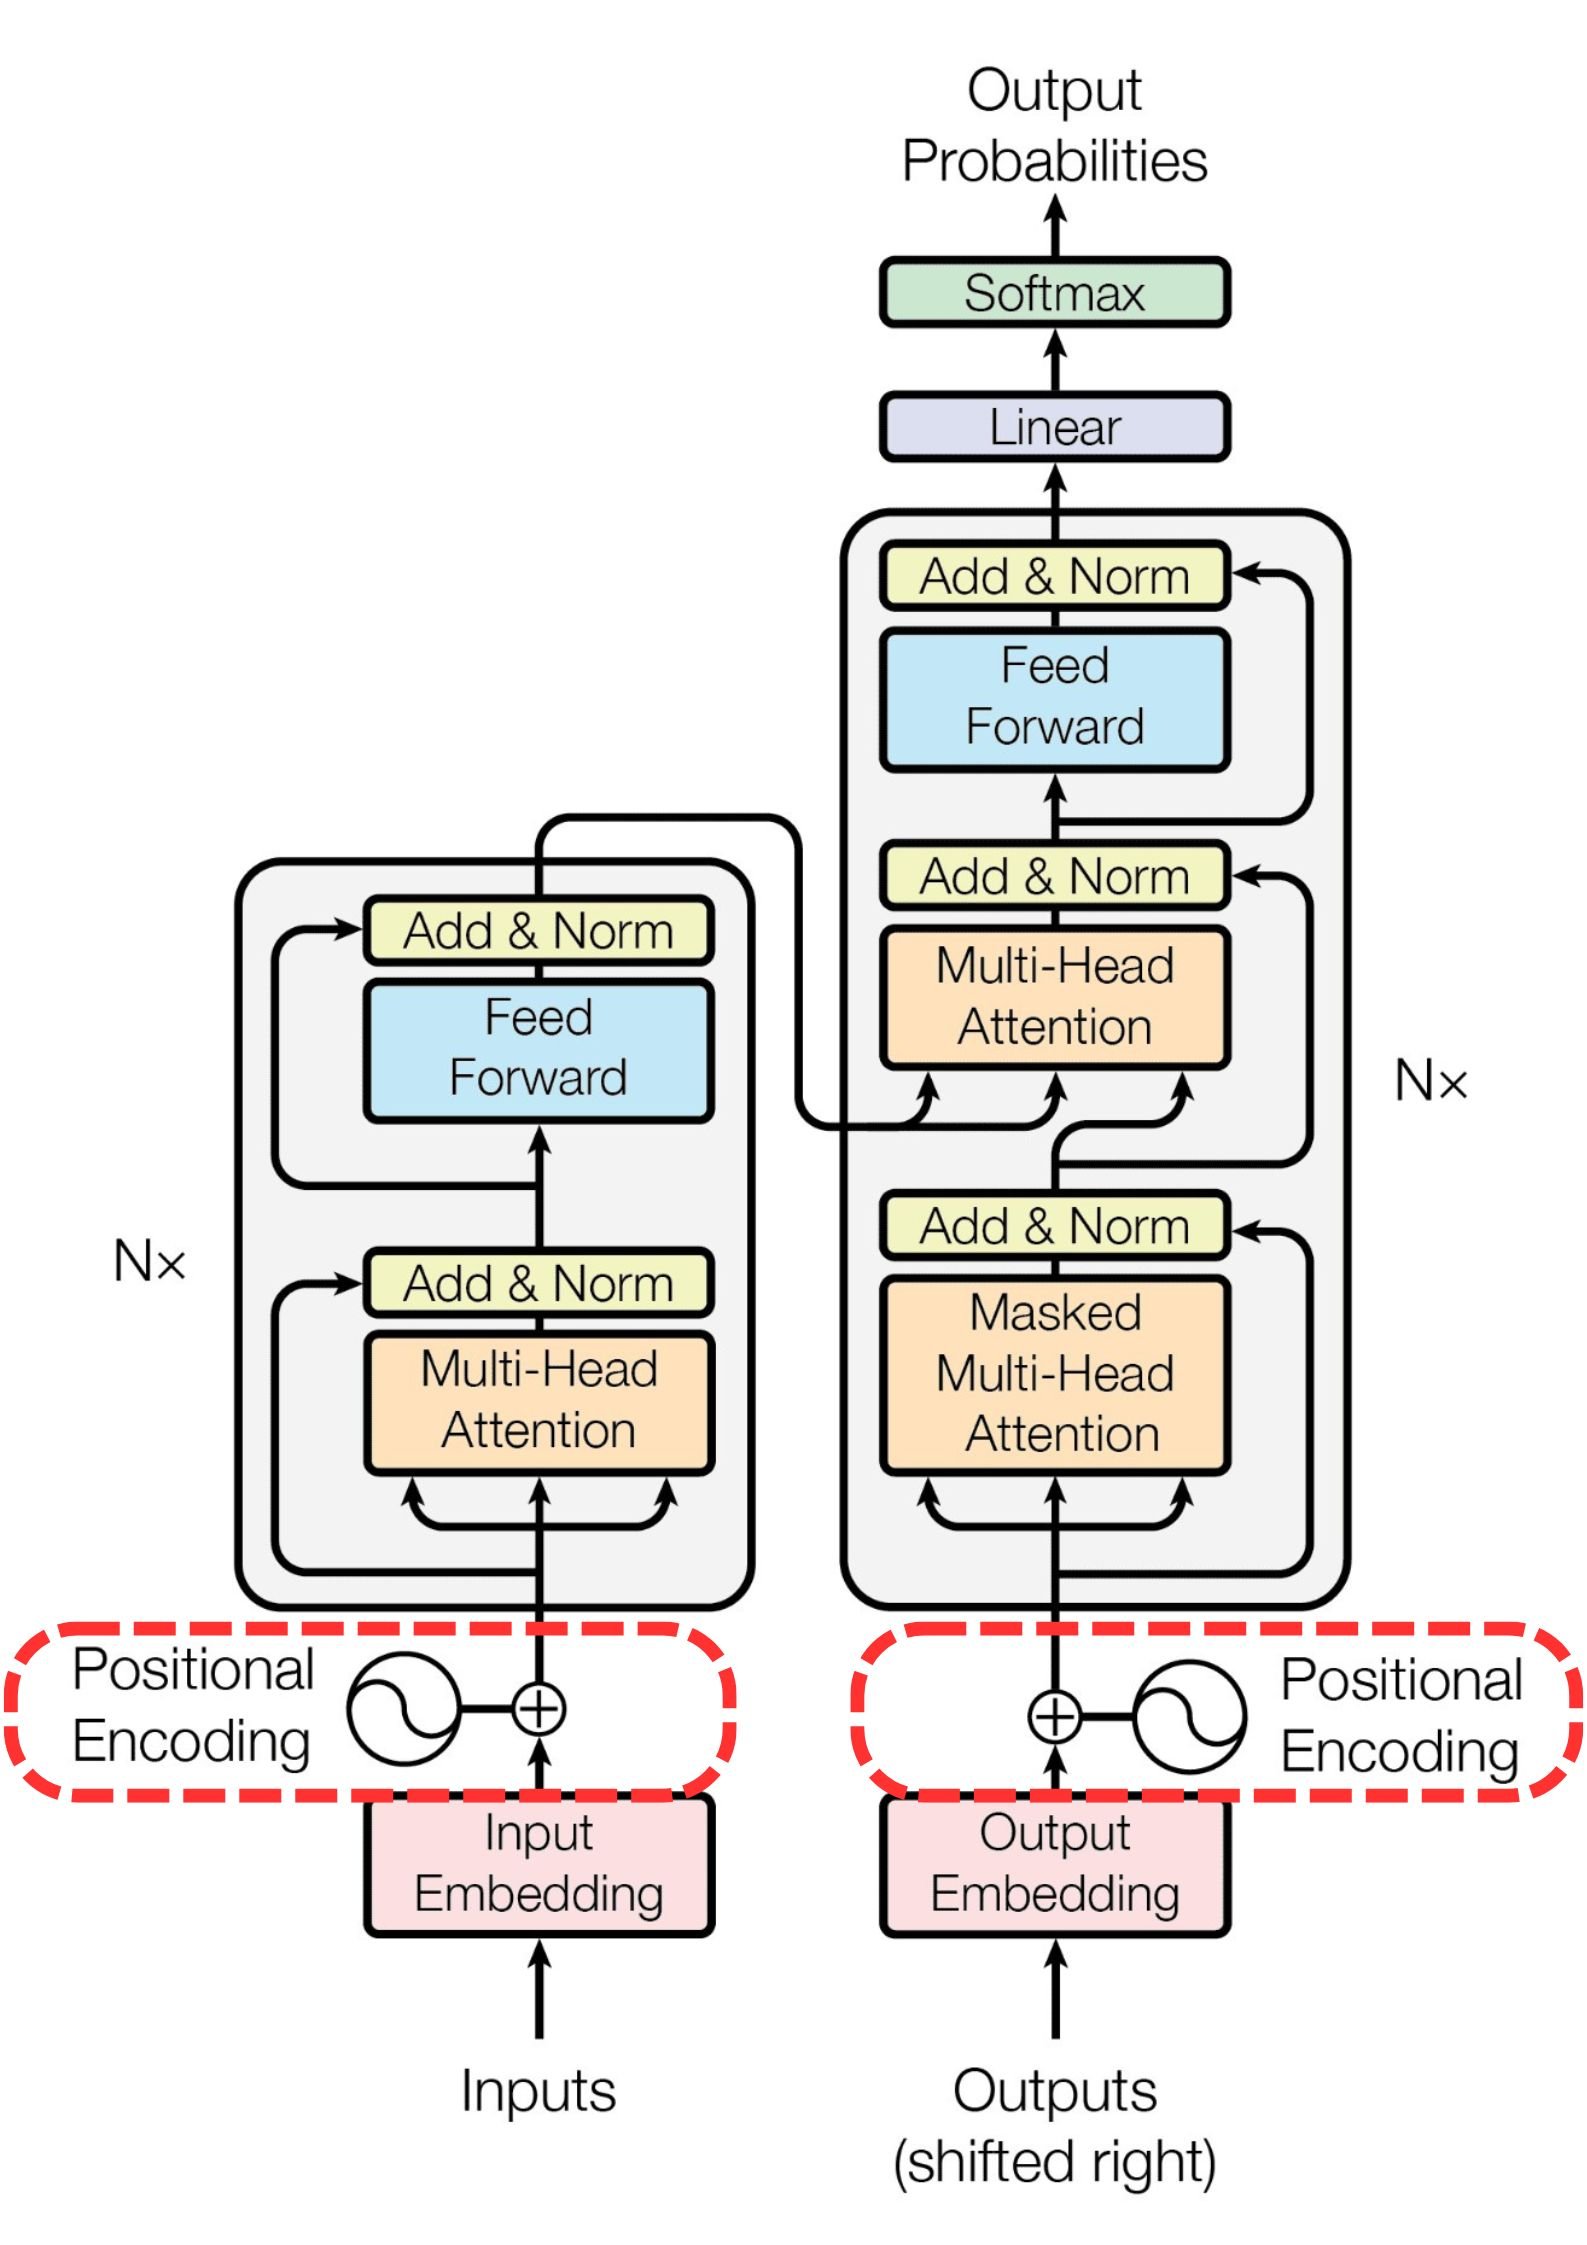
Codificación posicional
  • Codifica la posición de cada token en la secuencia
  • El orden es clave para modelar secuencias

La arquitectura Transformer tal como aparece en el artículo académico Attention Is All You Need.

Modelos Transformer con PyTorch

Desgranando el Transformer...

Mecanismos de atención
  • Se centran en tokens importantes y sus relaciones
  • Mejoran la generación de texto

La arquitectura Transformer tal como aparece en el artículo académico Attention Is All You Need.

Modelos Transformer con PyTorch

Desgranando el Transformer...

Mecanismos de atención
  • Se centran en tokens importantes y sus relaciones
  • Mejoran la generación de texto
Self-attention
  • Pondera la importancia de los tokens
  • Captura dependencias de largo alcance

La arquitectura Transformer tal como aparece en el artículo académico Attention Is All You Need.

Modelos Transformer con PyTorch

Desgranando el Transformer...

Mecanismos de atención
  • Se centran en tokens importantes y sus relaciones
  • Mejoran la generación de texto
Self-attention
  • Pondera la importancia de los tokens
  • Captura dependencias de largo alcance
Multi-head attention
  • Divide la entrada en varias cabezas
  • Cada cabeza capta patrones distintos, generando representaciones más ricas

La arquitectura Transformer tal como aparece en el artículo académico Attention Is All You Need.

Modelos Transformer con PyTorch

Desgranando el Transformer...


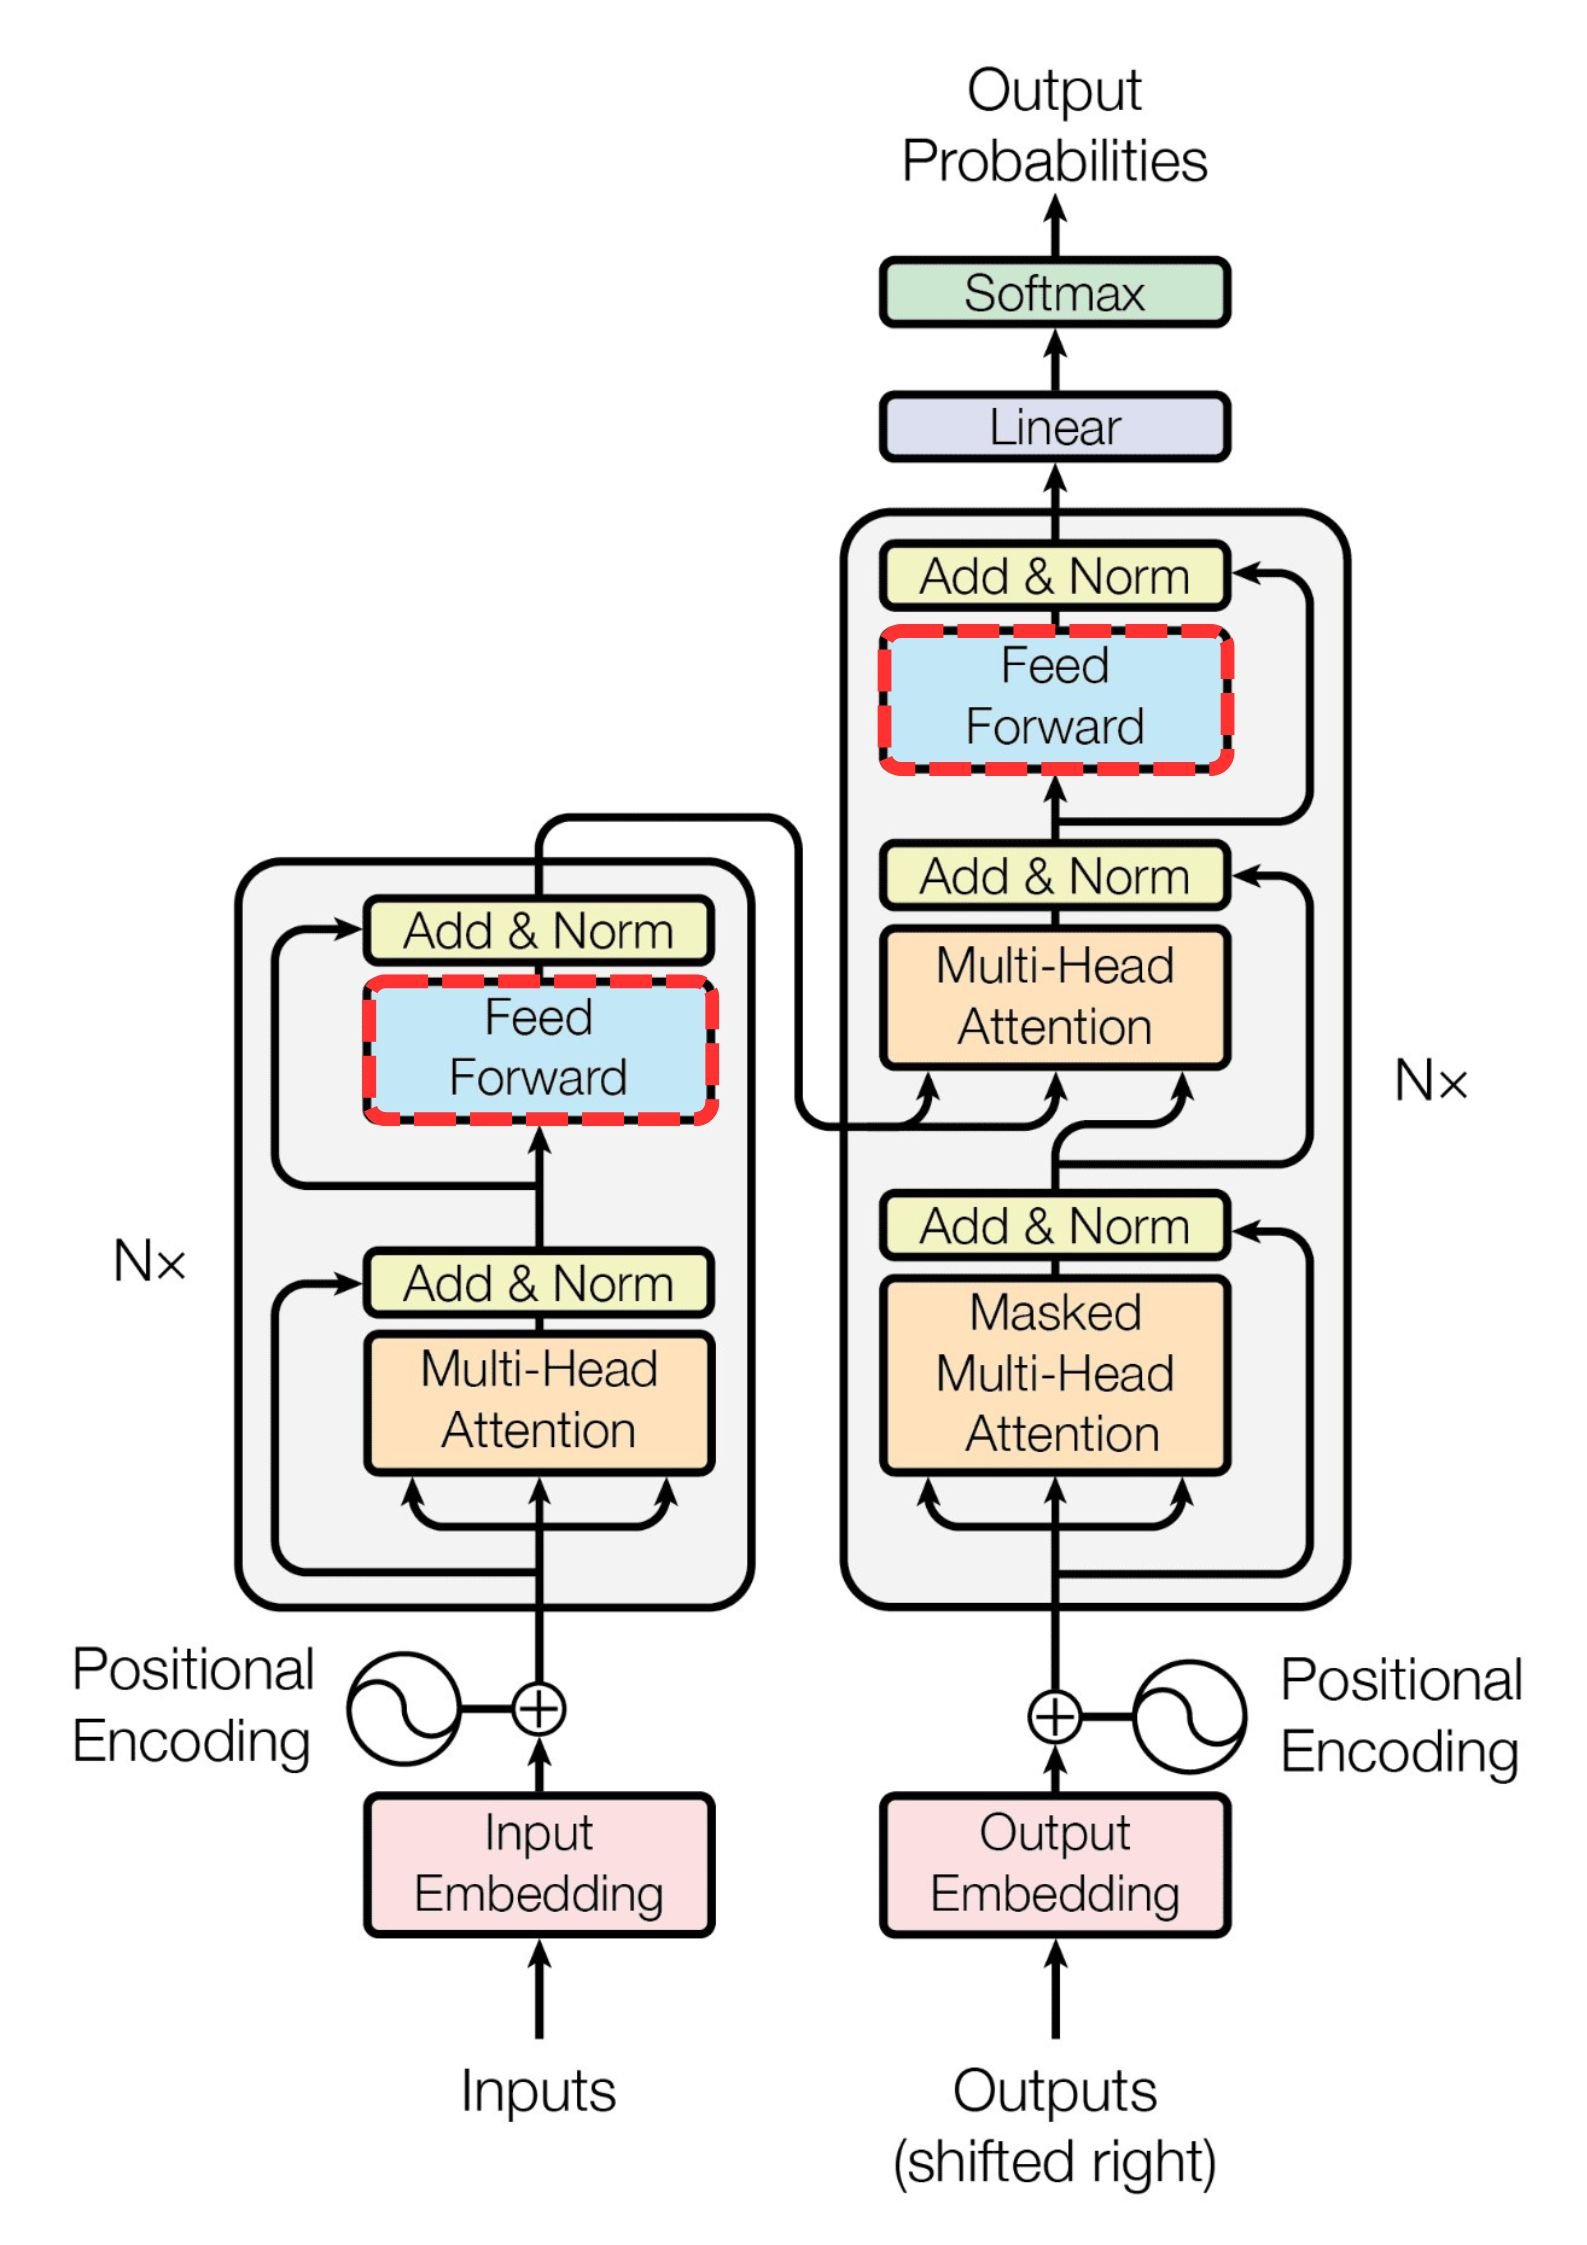
Redes feed-forward por posición
  • NNs sencillas que aplican transformaciones
  • Cada token se transforma de forma independiente
  • Independientes de la posición/"position-wise"

La arquitectura Transformer tal como aparece en el artículo académico Attention Is All You Need.

Modelos Transformer con PyTorch

Transformers en PyTorch


  • d_model: Dimensionalidad de las entradas del modelo
  • nheads: Número de cabezas de atención
  • num_encoder_layers: Número de capas del codificador
  • num_decoder_layers: Número de capas del decodificador
import torch.nn as nn


model = nn.Transformer(
d_model=512,
nhead=8,
num_encoder_layers=6,
num_decoder_layers=6
)
print(model)
Modelos Transformer con PyTorch
Transformer(
  (encoder): TransformerEncoder(
    (layers): ModuleList(
      (0-5): 6 x TransformerEncoderLayer(
        (self_attn): MultiheadAttention(
          (out_proj): NonDynamicallyQuantizableLinear(in_features=512, out_features=512, bias=True)
        )
        (linear1): Linear(in_features=512, out_features=2048, bias=True)
        (dropout): Dropout(p=0.1, inplace=False)
        (linear2): Linear(in_features=2048, out_features=512, bias=True)
        (norm1): LayerNorm((512,), eps=1e-05, elementwise_affine=True)
        (norm2): LayerNorm((512,), eps=1e-05, elementwise_affine=True)
        (dropout1): Dropout(p=0.1, inplace=False)
        (dropout2): Dropout(p=0.1, inplace=False)
      )
    )
    (norm): LayerNorm((512,), eps=1e-05, elementwise_affine=True)
  )
  ...
Modelos Transformer con PyTorch
  (decoder): TransformerDecoder(
    (layers): ModuleList(
      (0-5): 6 x TransformerDecoderLayer(
        (self_attn): MultiheadAttention(
          (out_proj): NonDynamicallyQuantizableLinear(in_features=512, out_features=512, bias=True)
        )
        (multihead_attn): MultiheadAttention(
          (out_proj): NonDynamicallyQuantizableLinear(in_features=512, out_features=512, bias=True)
        )
        (linear1): Linear(in_features=512, out_features=2048, bias=True)
        (dropout): Dropout(p=0.1, inplace=False)
        (linear2): Linear(in_features=2048, out_features=512, bias=True)
        (norm1): LayerNorm((512,), eps=1e-05, elementwise_affine=True)
        (norm2): LayerNorm((512,), eps=1e-05, elementwise_affine=True)
        (norm3): LayerNorm((512,), eps=1e-05, elementwise_affine=True)
        (dropout1): Dropout(p=0.1, inplace=False)
        (dropout2): Dropout(p=0.1, inplace=False)
        (dropout3): Dropout(p=0.1, inplace=False)
      )
    )
    (norm): LayerNorm((512,), eps=1e-05, elementwise_affine=True)
  )
)
Modelos Transformer con PyTorch

¡Vamos a practicar!

Modelos Transformer con PyTorch

Preparing Video For Download...