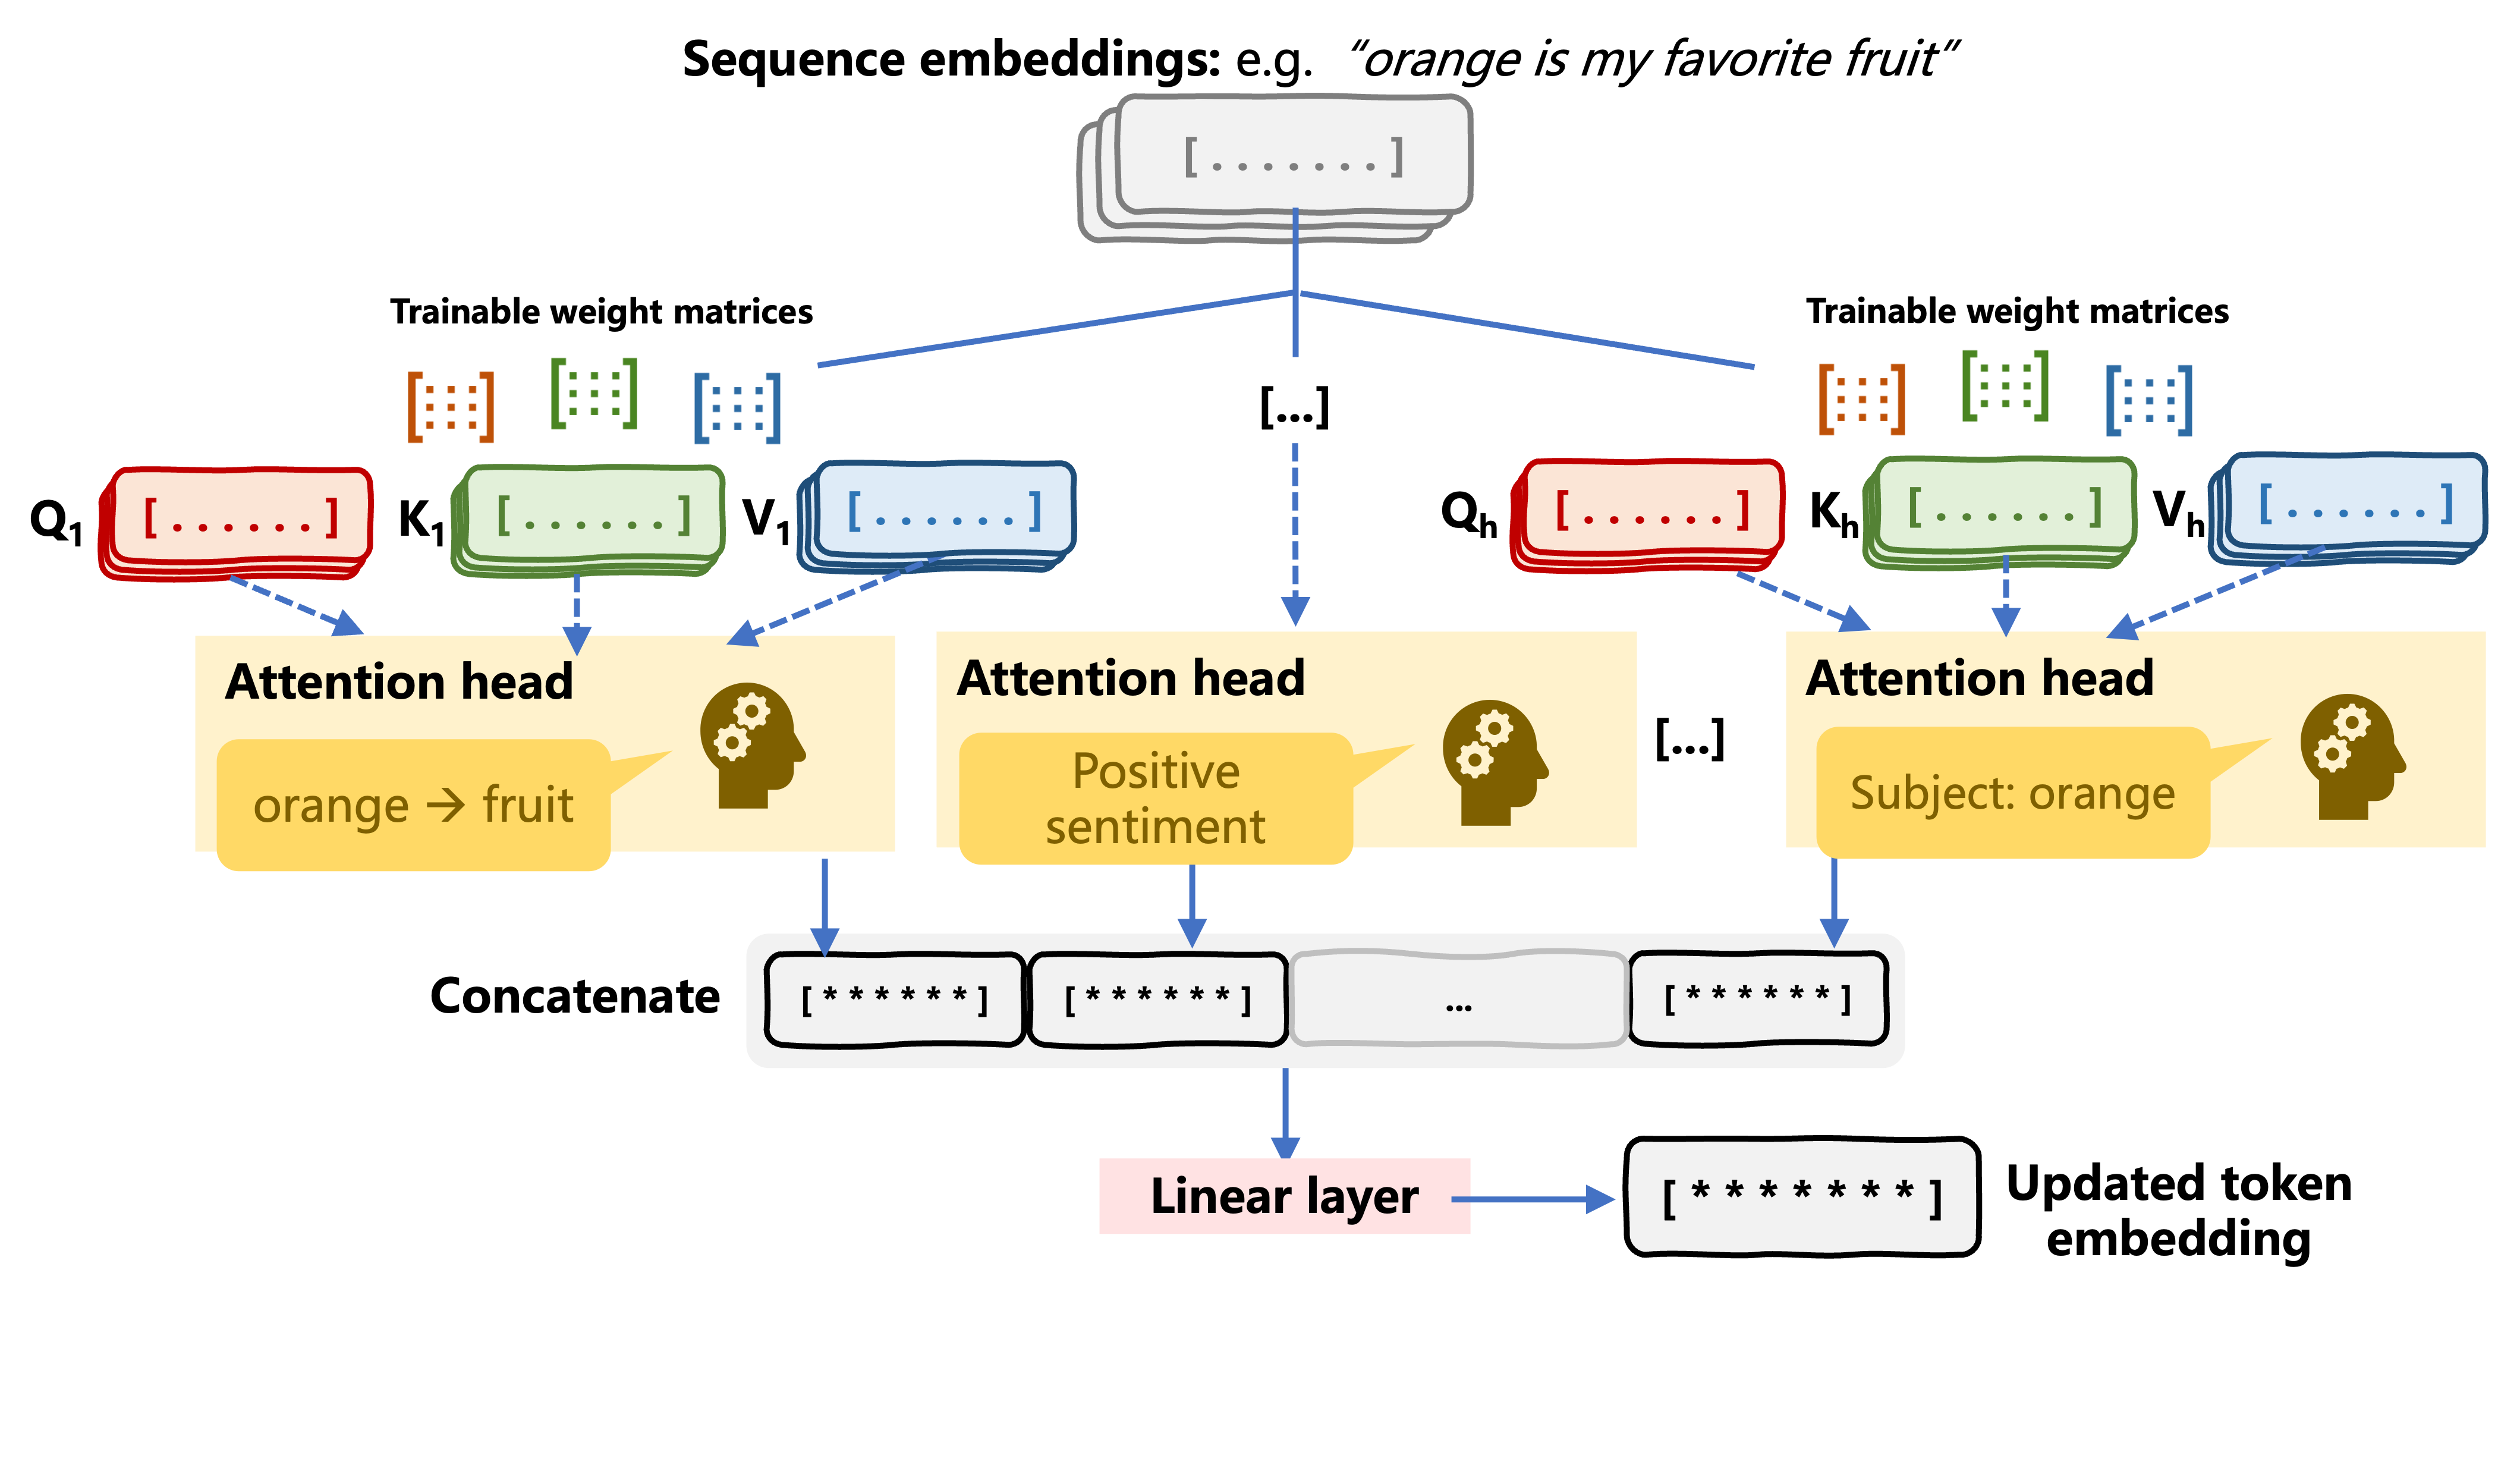
Autoatención multi-cabeza

Modelos Transformer con PyTorch

James Chapman

Curriculum Manager, DataCamp

Atención multi-cabeza en transformers
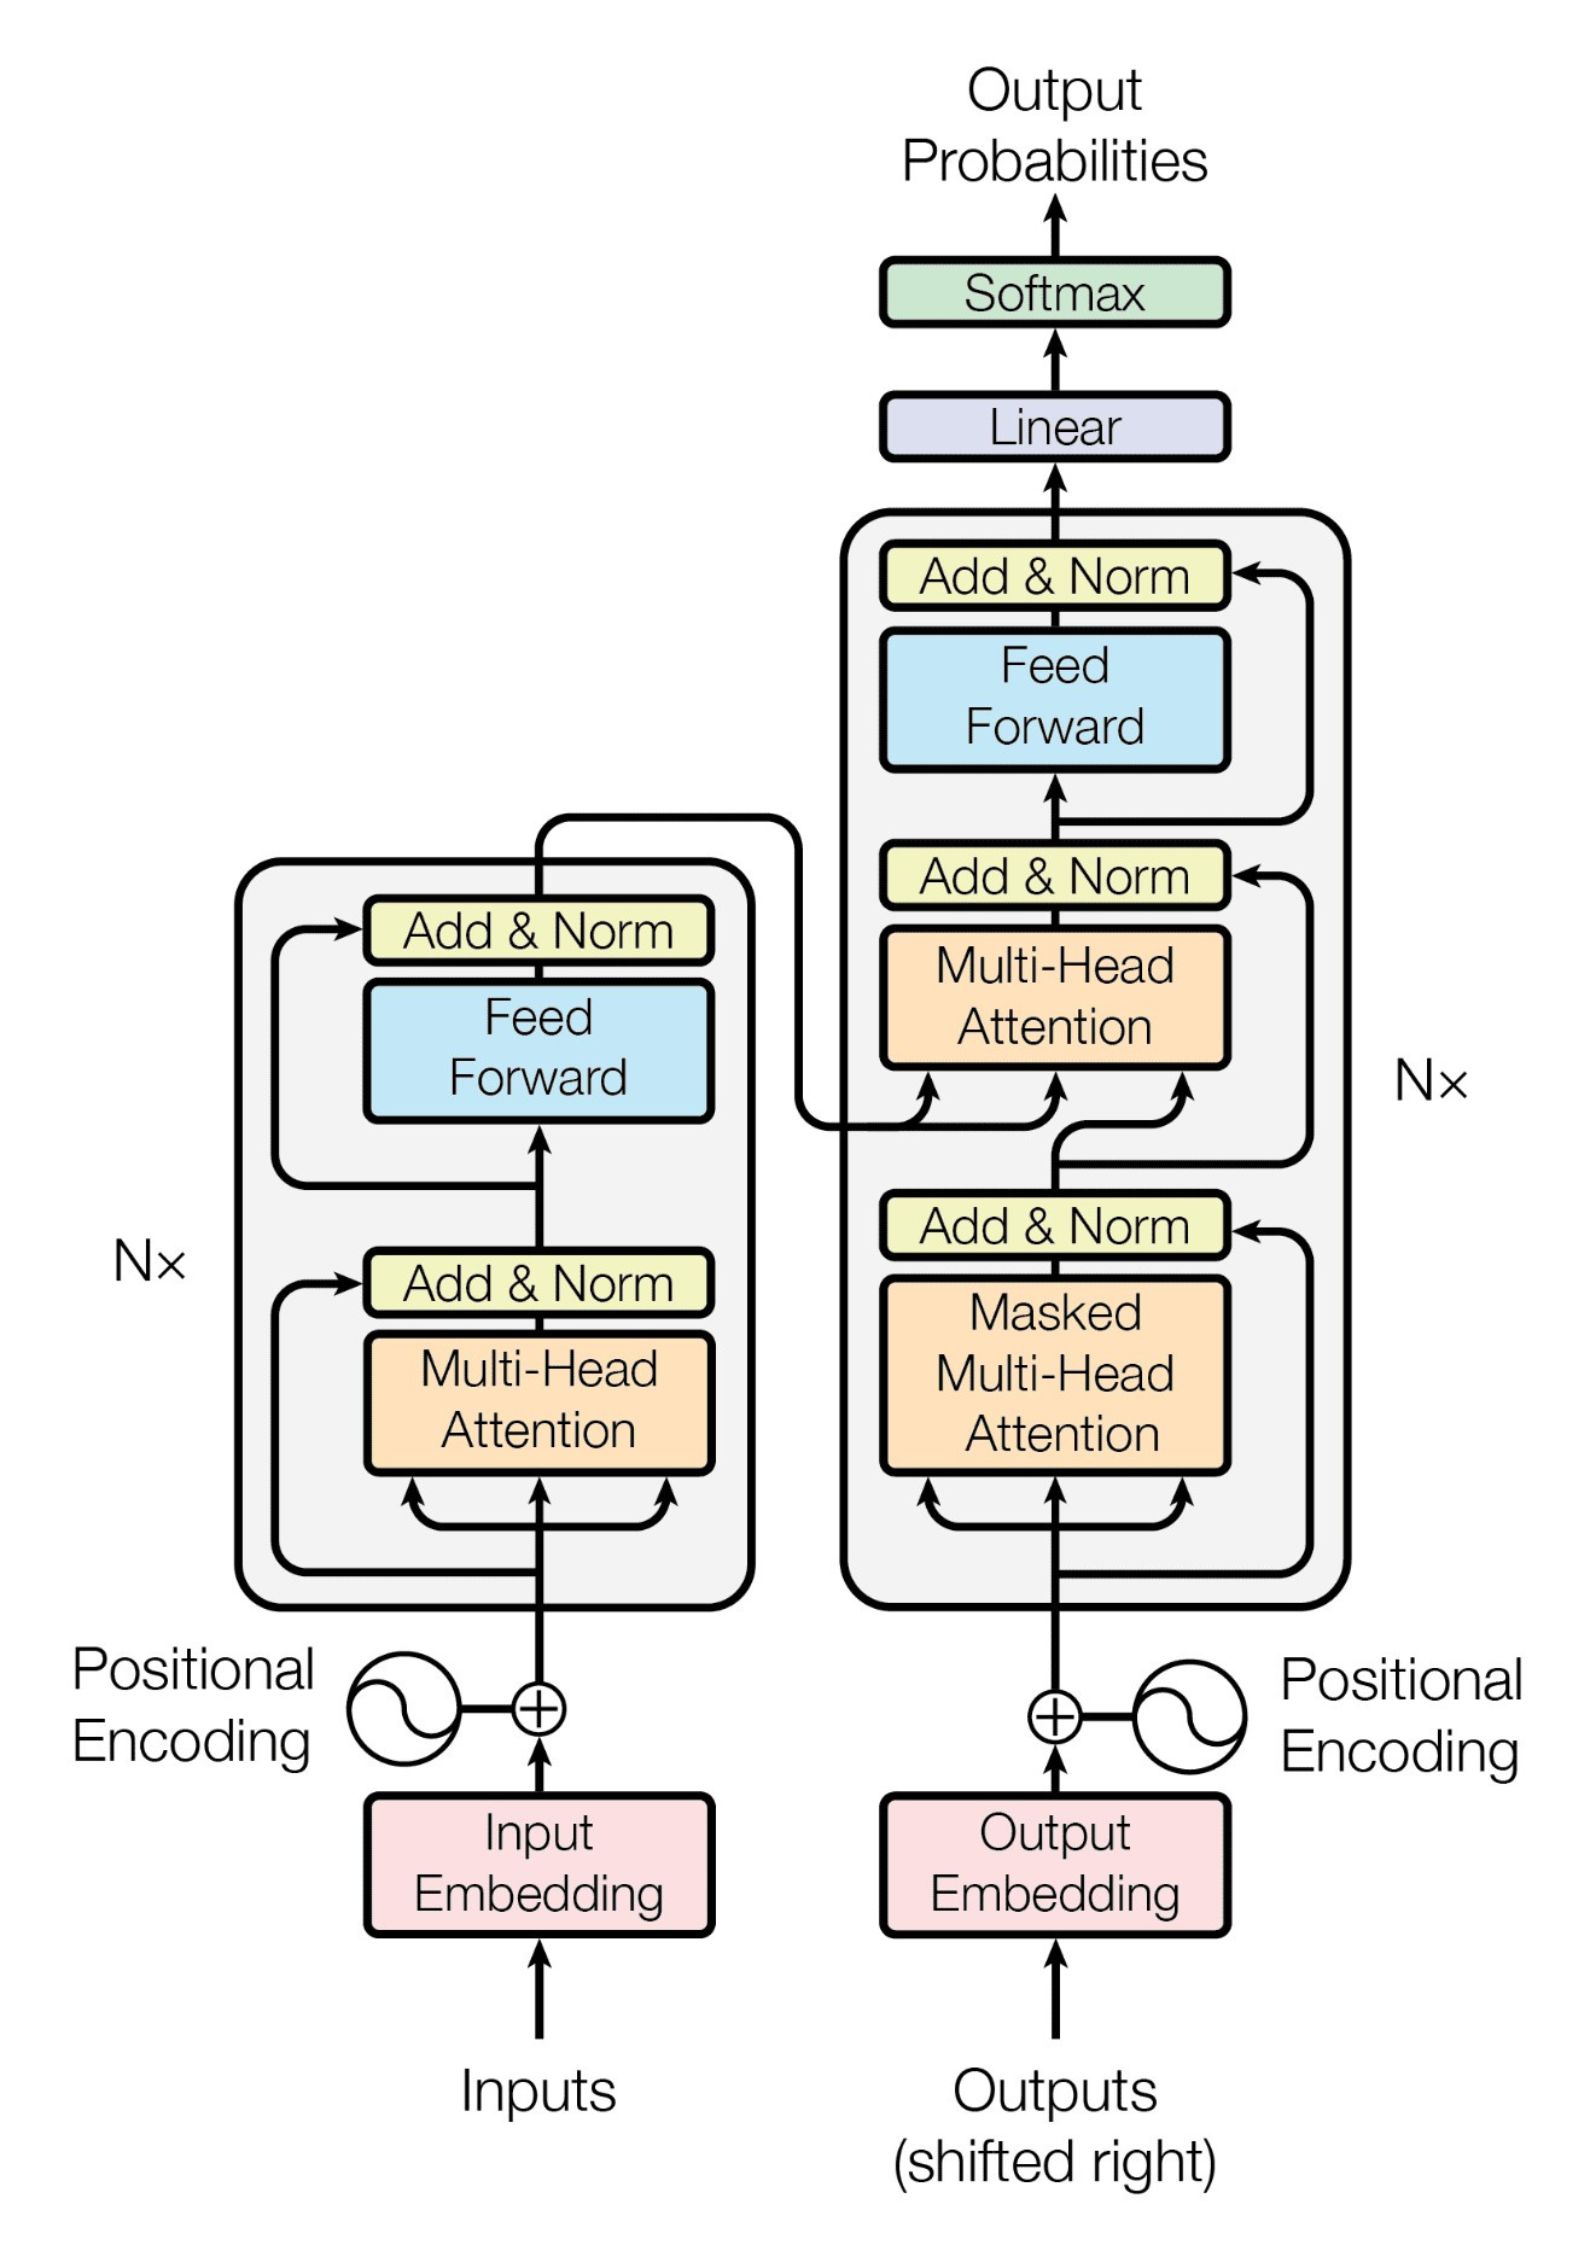
La arquitectura de transformers como aparece en el artículo académico «Attention Is All You Need».

Modelos Transformer con PyTorch

Mecanismo de autoatención

Anatomía del mecanismo de autoatención

Modelos Transformer con PyTorch

Mecanismo de autoatención

Anatomía del mecanismo de autoatención

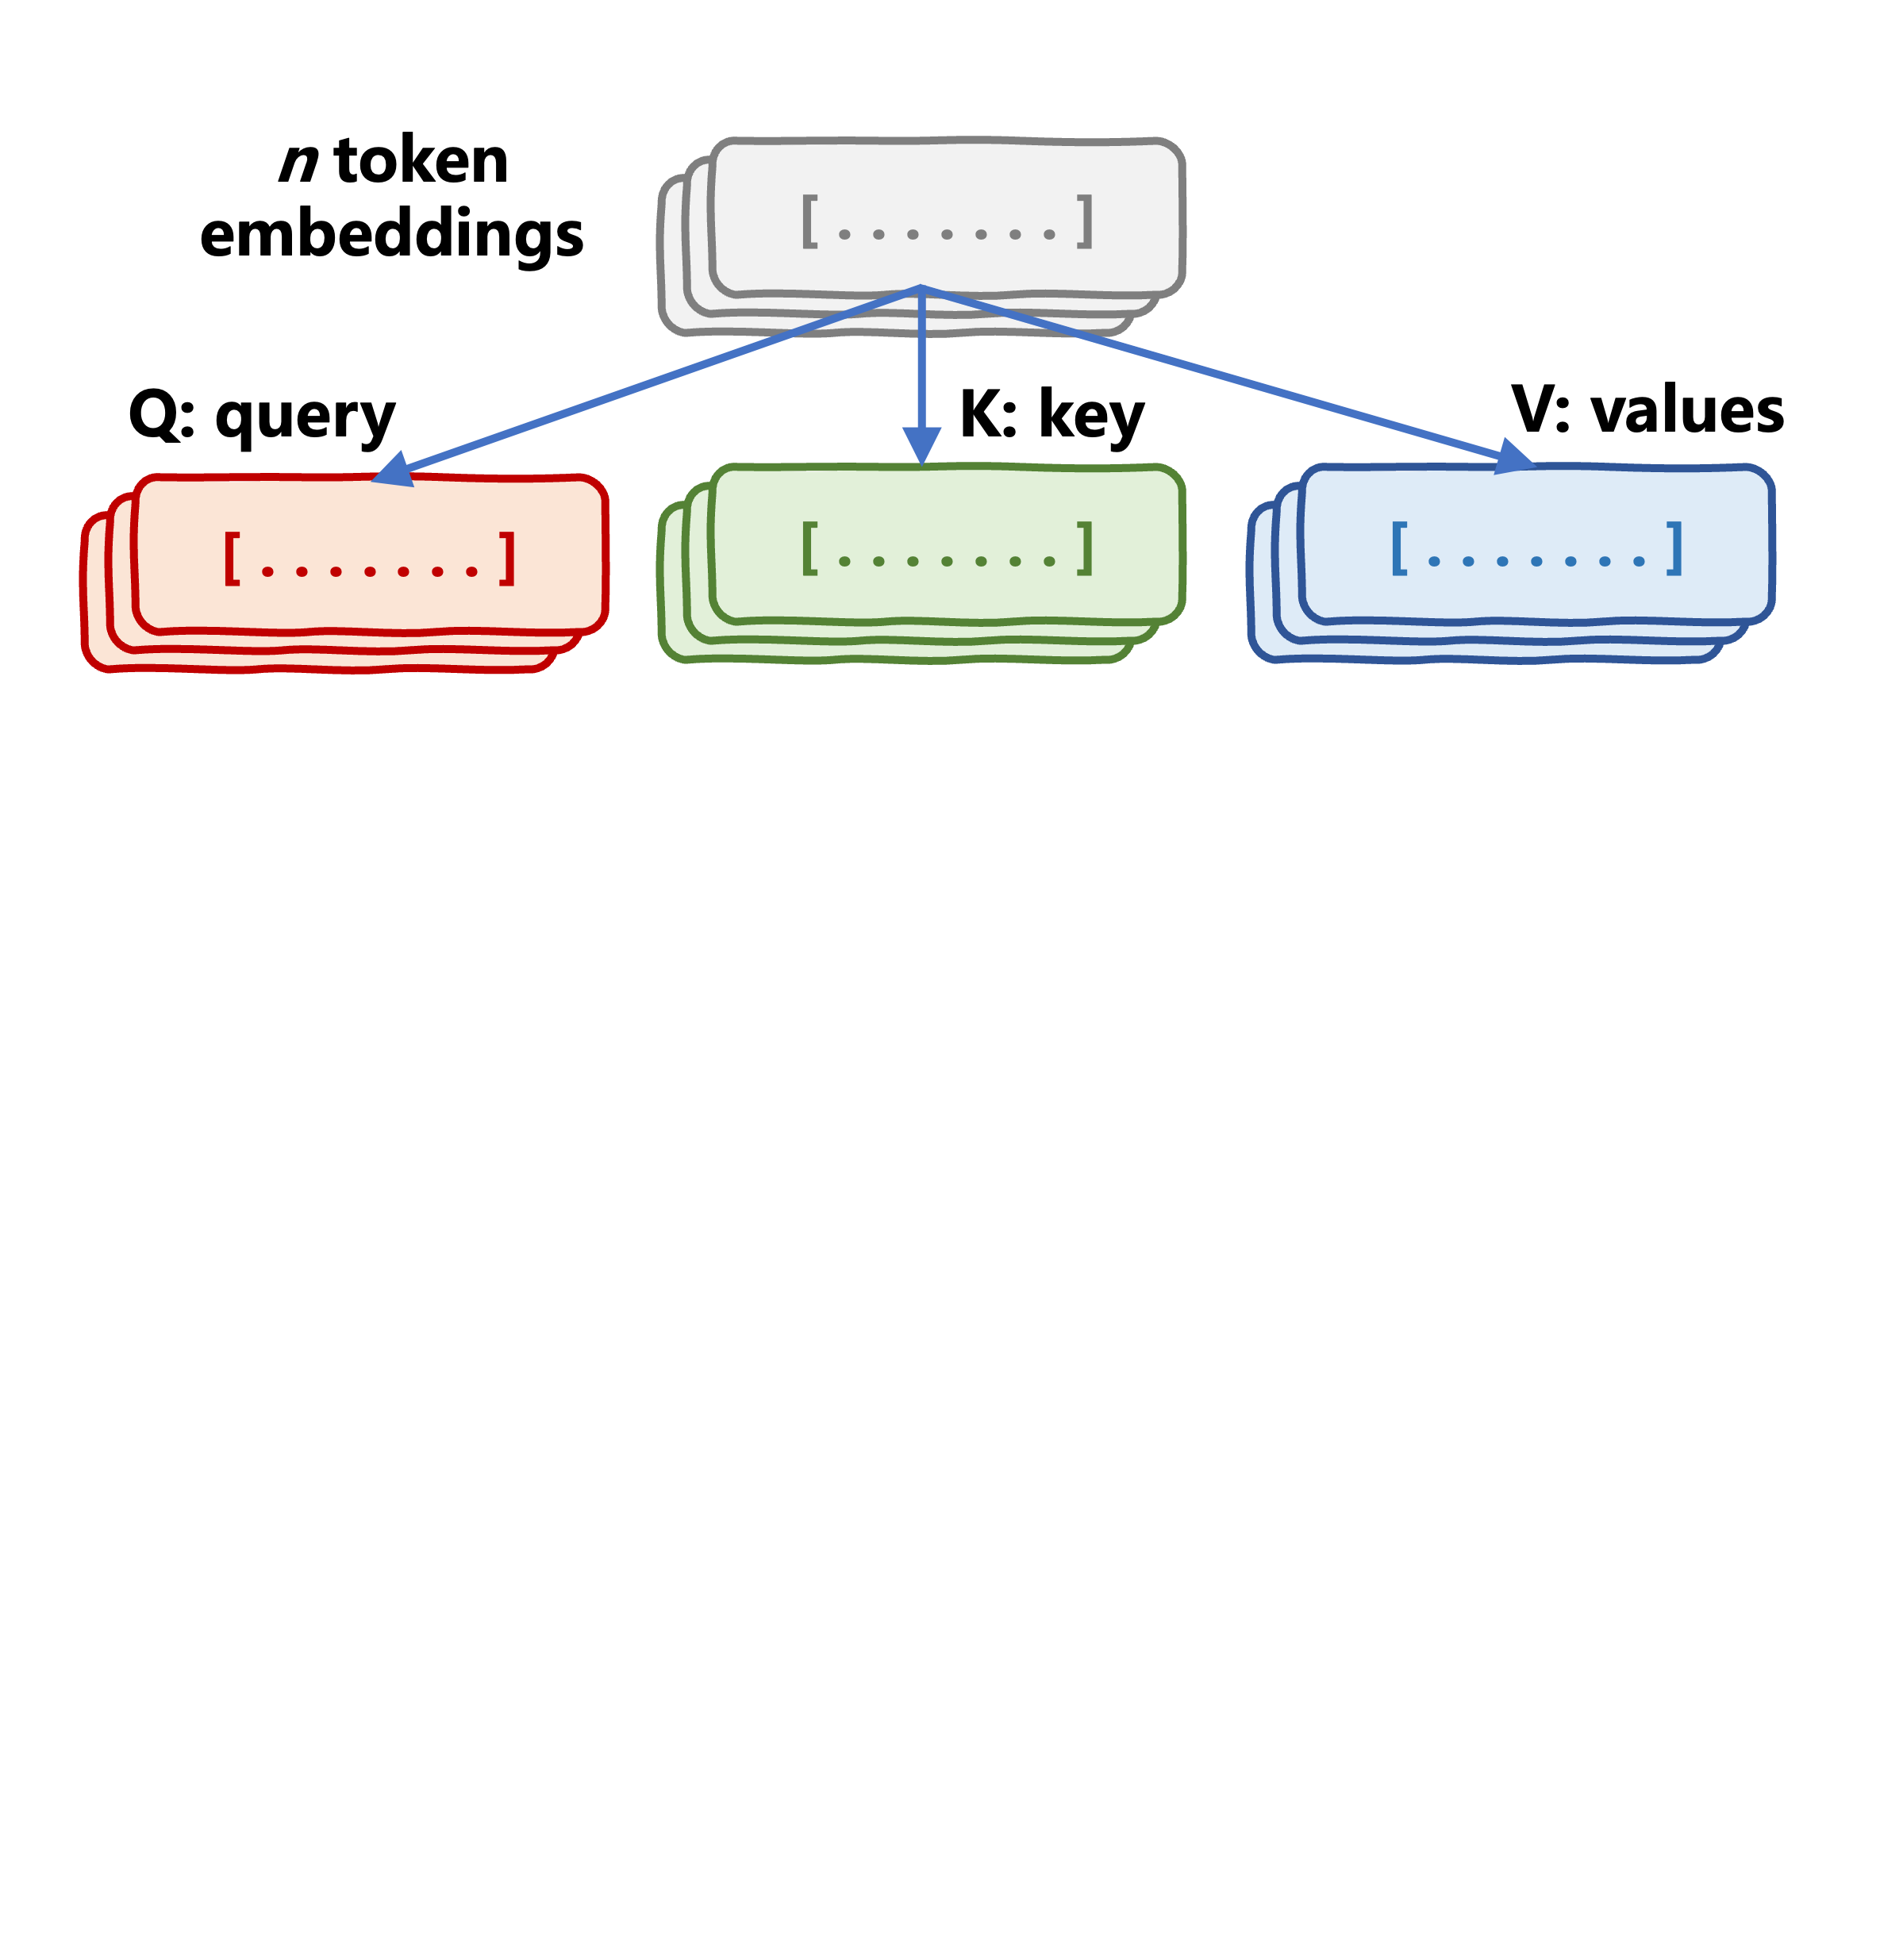
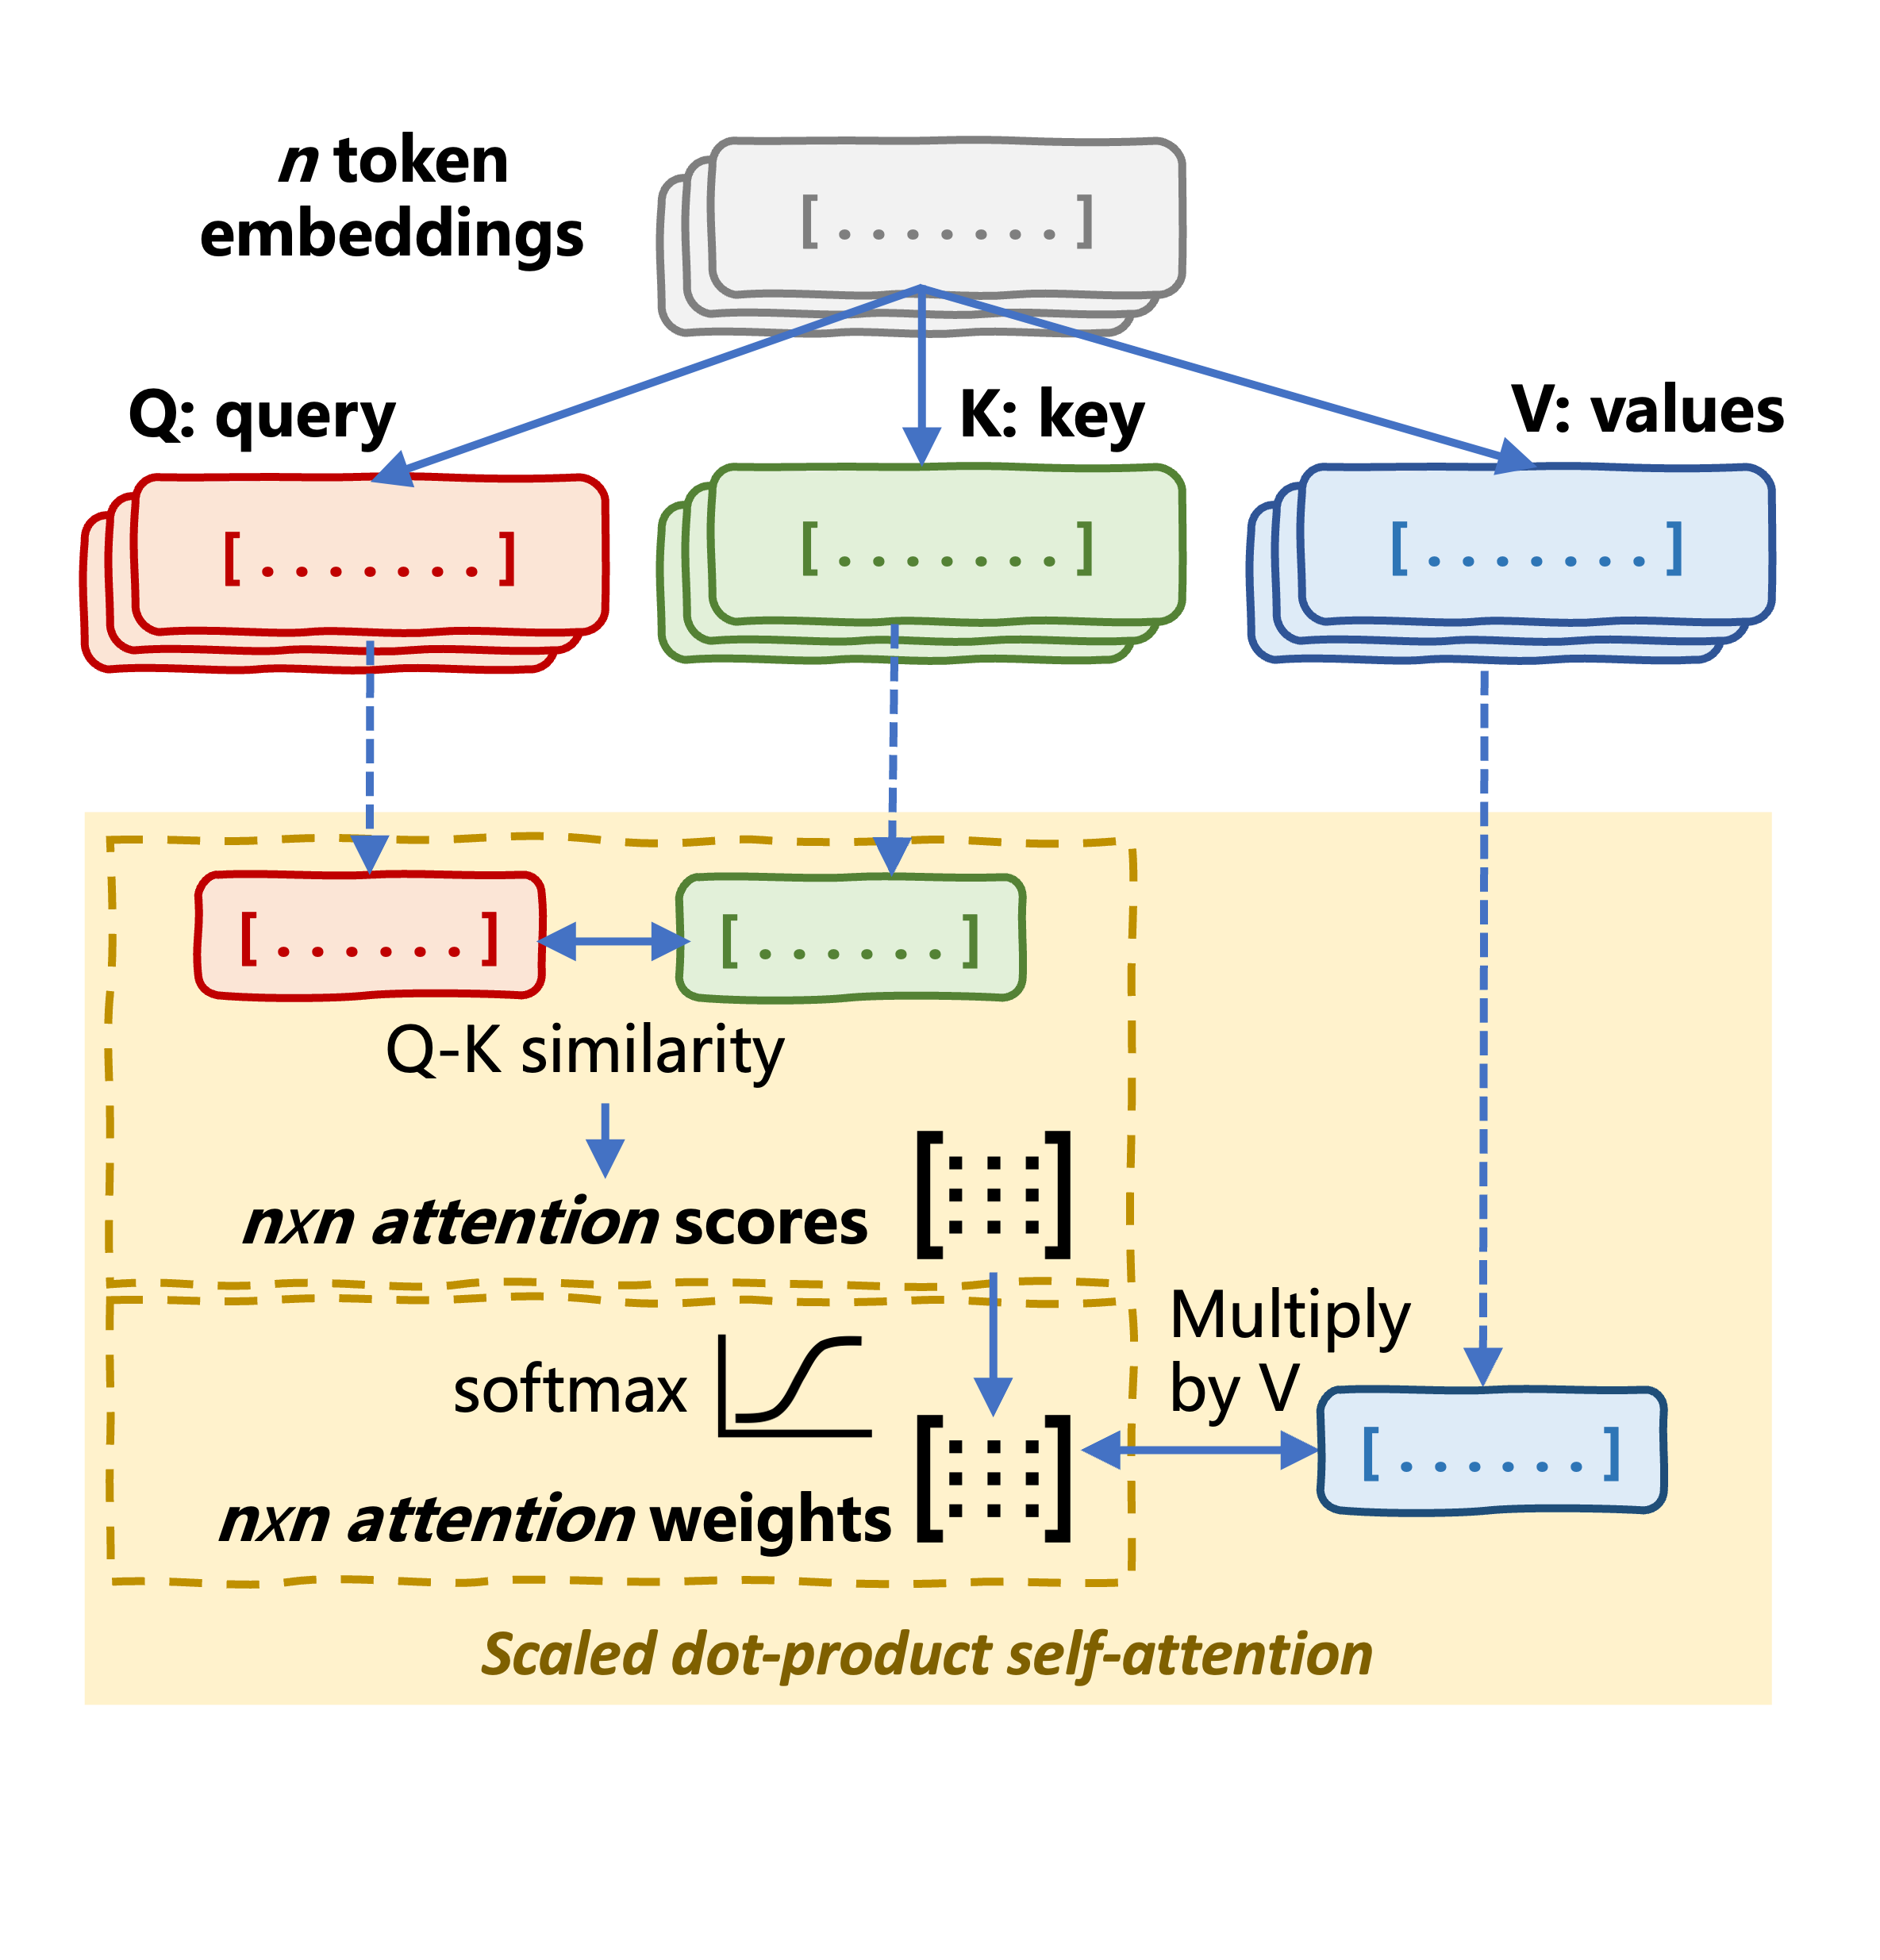
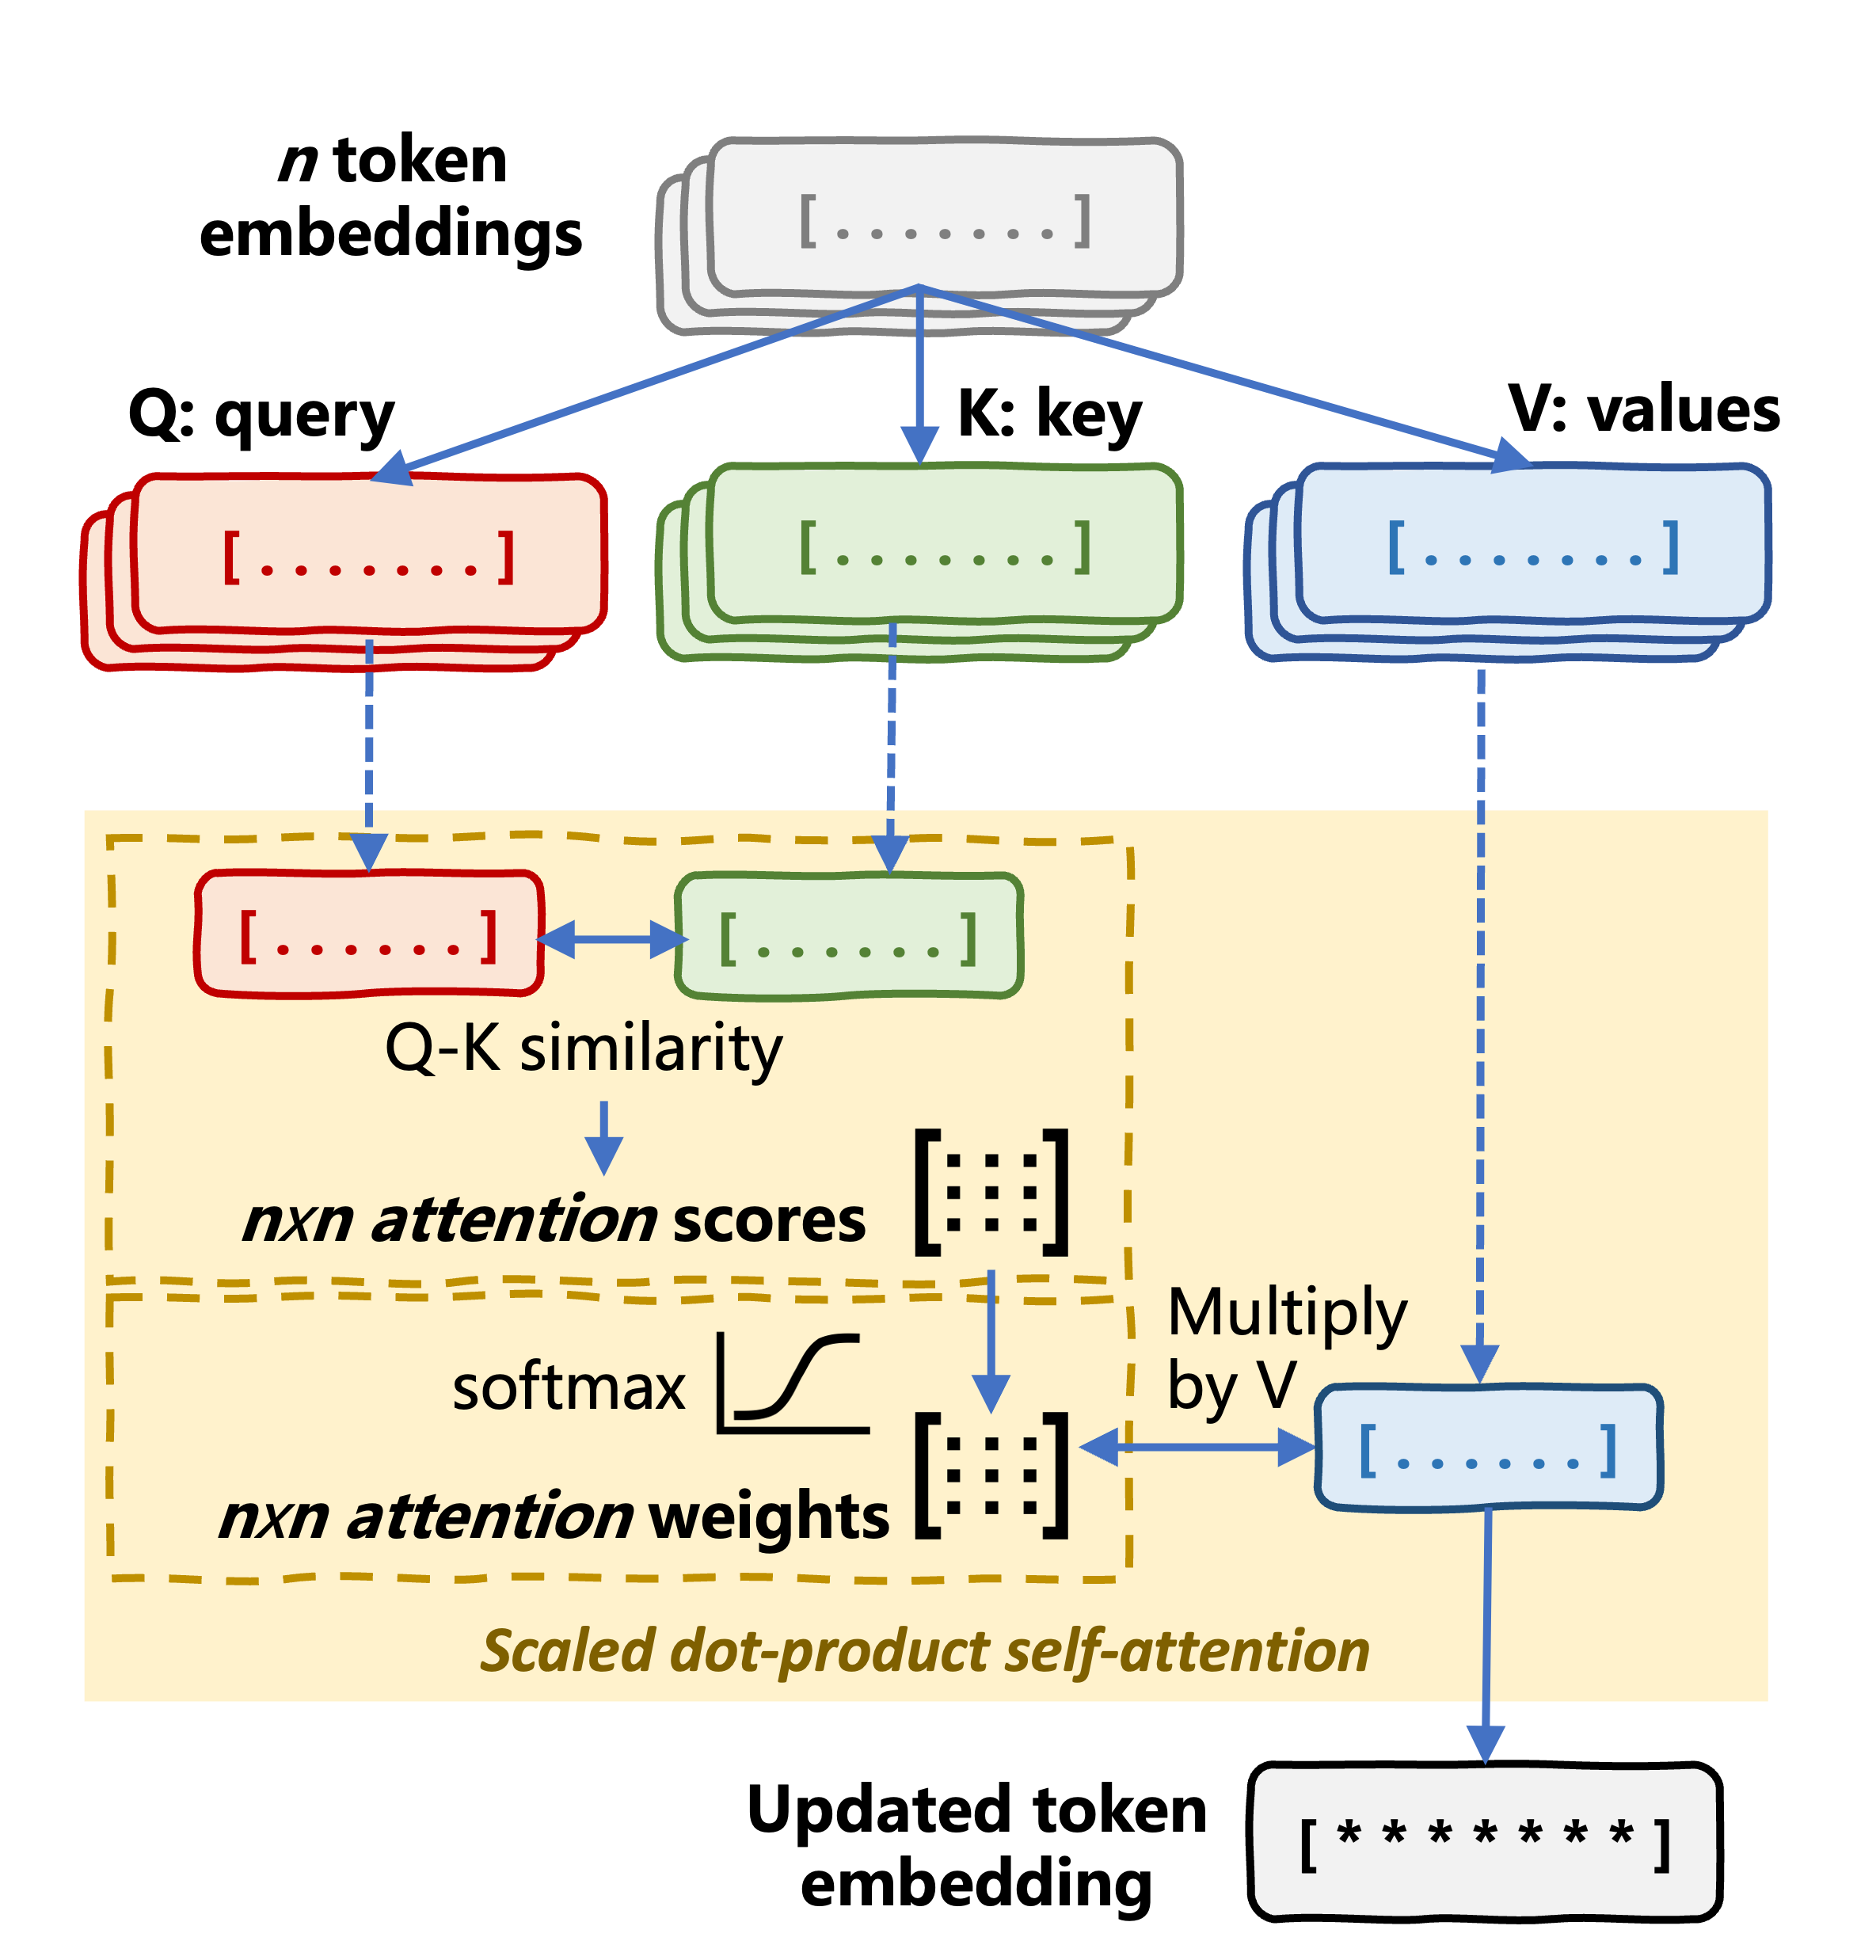
  • Q: Indica qué busca cada token en los demás
  • K: Representa el contenido de cada token
  • V: Contenido a agregar o ponderar
Modelos Transformer con PyTorch

Mecanismo de autoatención

Anatomía del mecanismo de autoatención

  • Q: Indica qué busca cada token en los demás
  • K: Representa el contenido de cada token
  • V: Contenido a agregar o ponderar


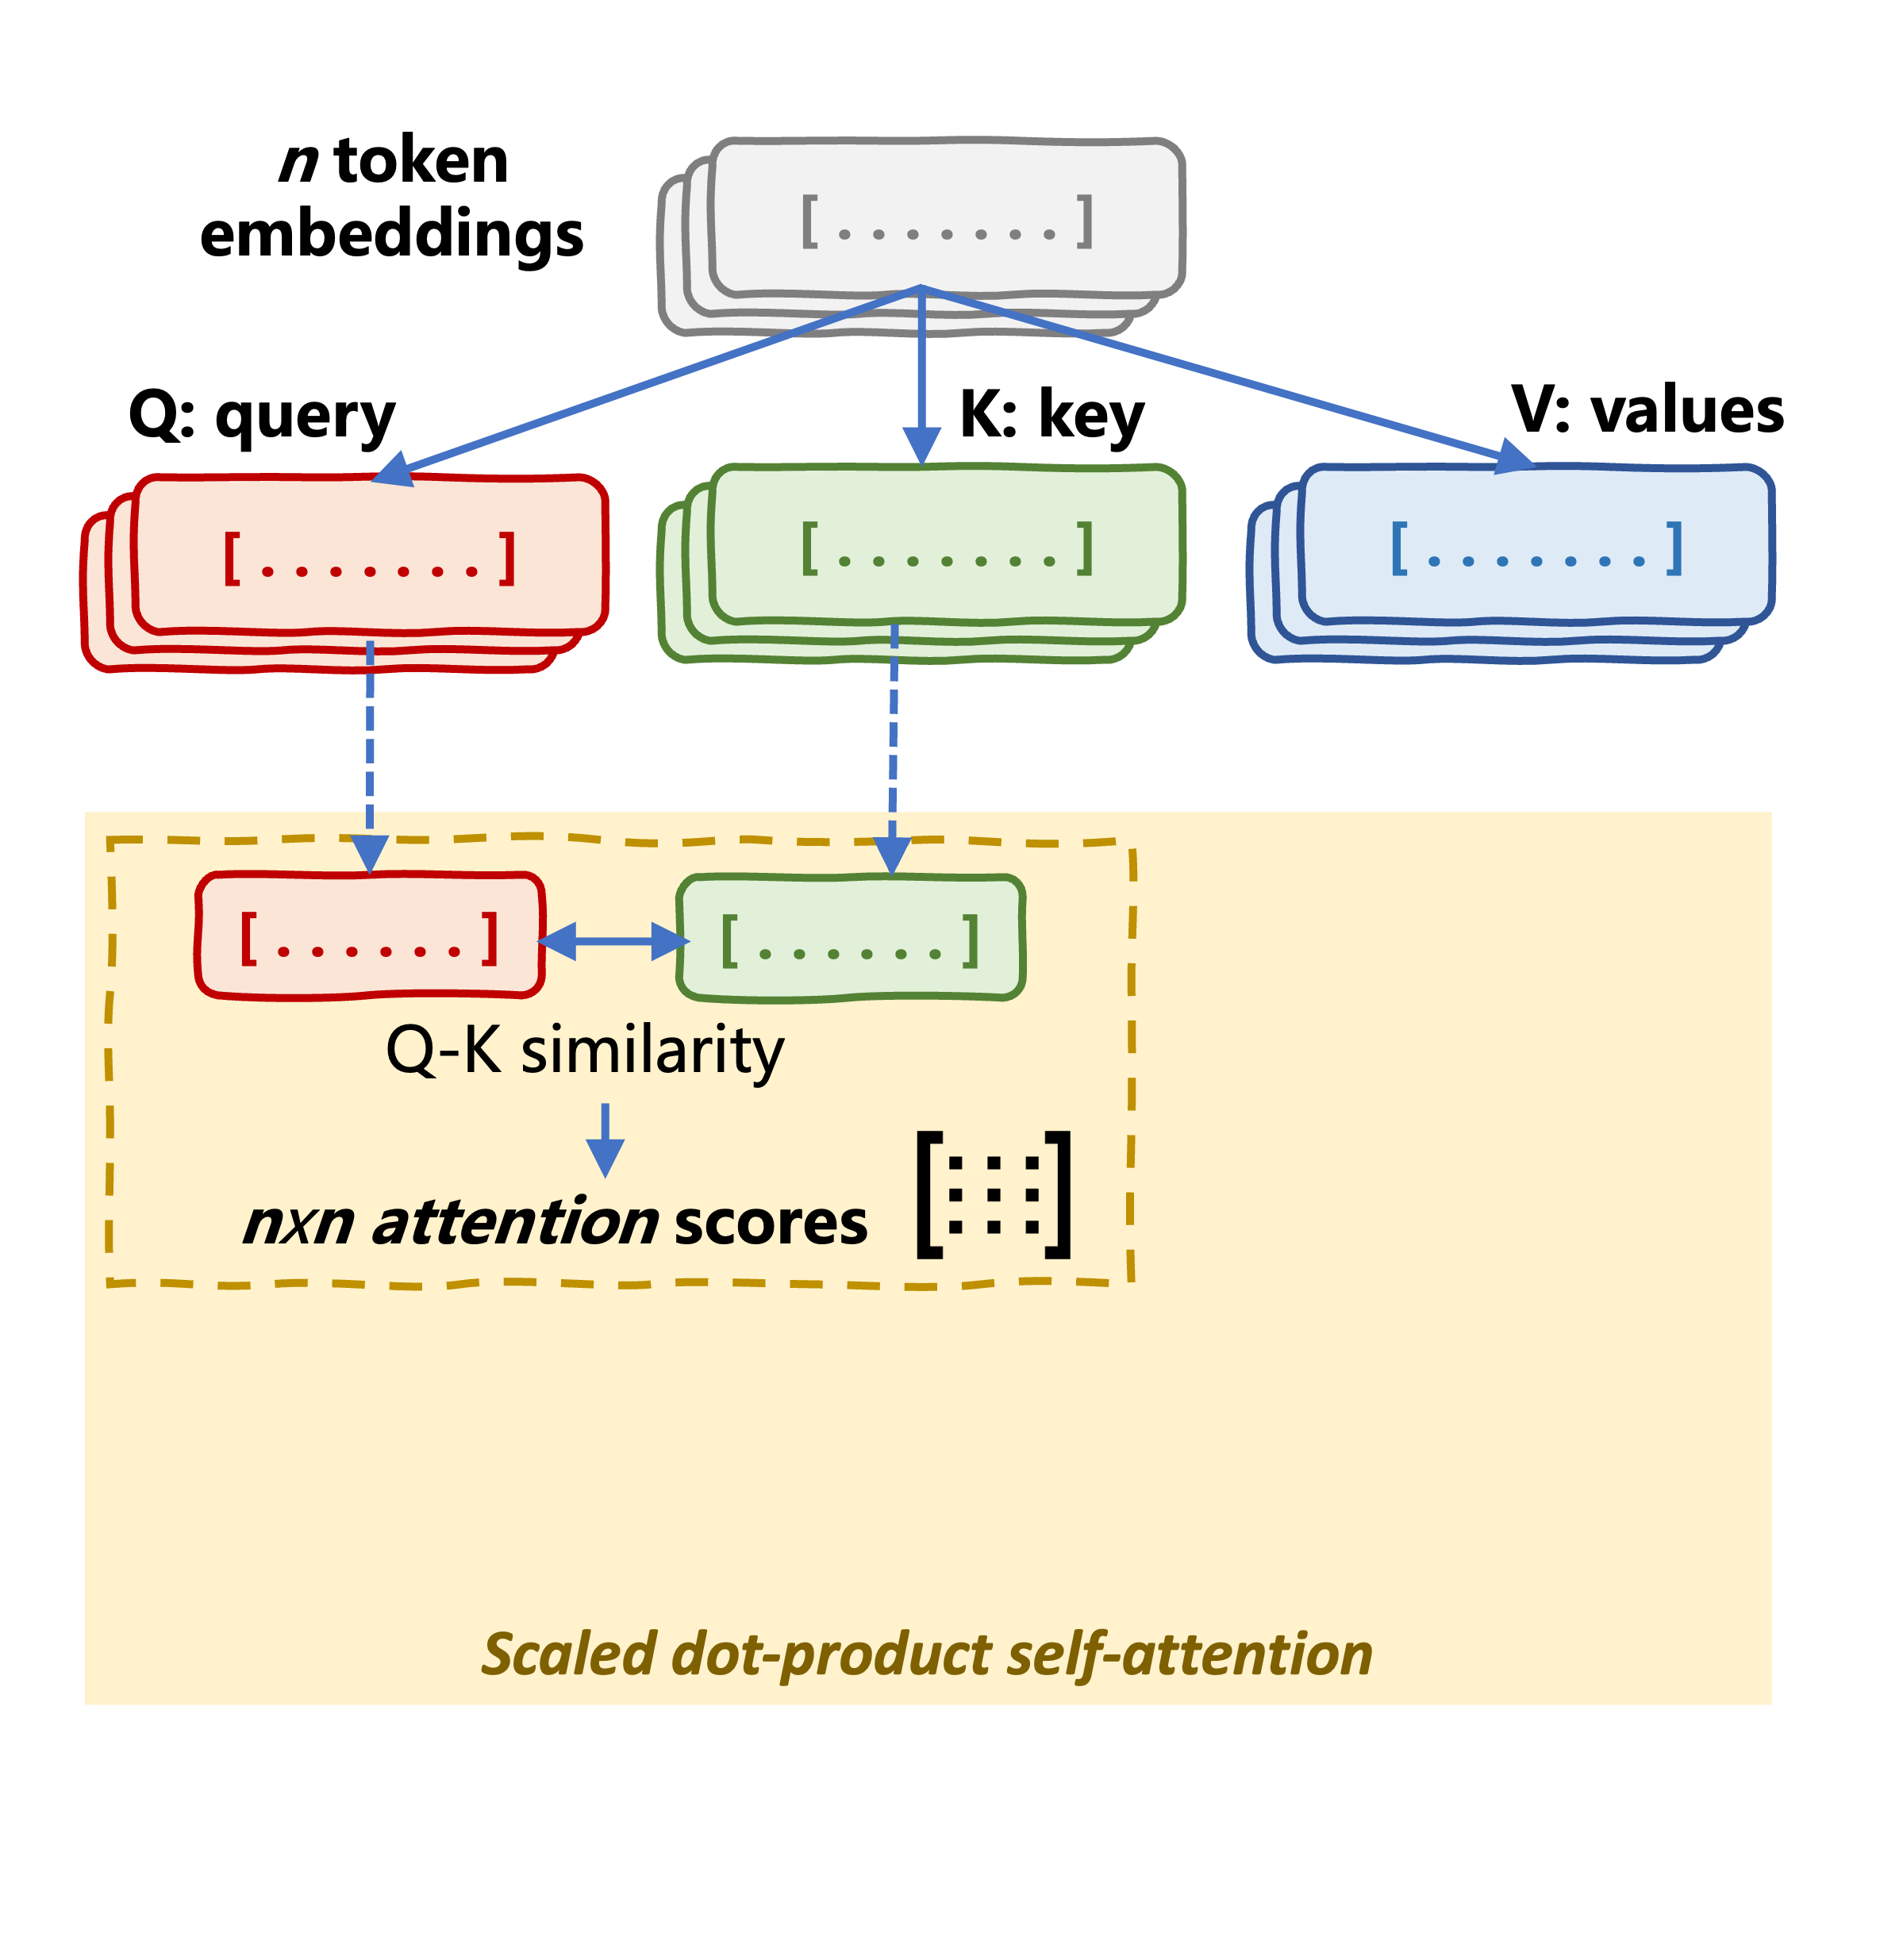
  • Puntuaciones de atención: similitud Q-K → producto punto
Modelos Transformer con PyTorch

Mecanismo de autoatención

Anatomía del mecanismo de autoatención

  • Q: Indica qué busca cada token en los demás
  • K: Representa el contenido de cada token
  • V: Contenido a agregar o ponderar


  • Puntuaciones de atención: similitud Q-K → producto punto
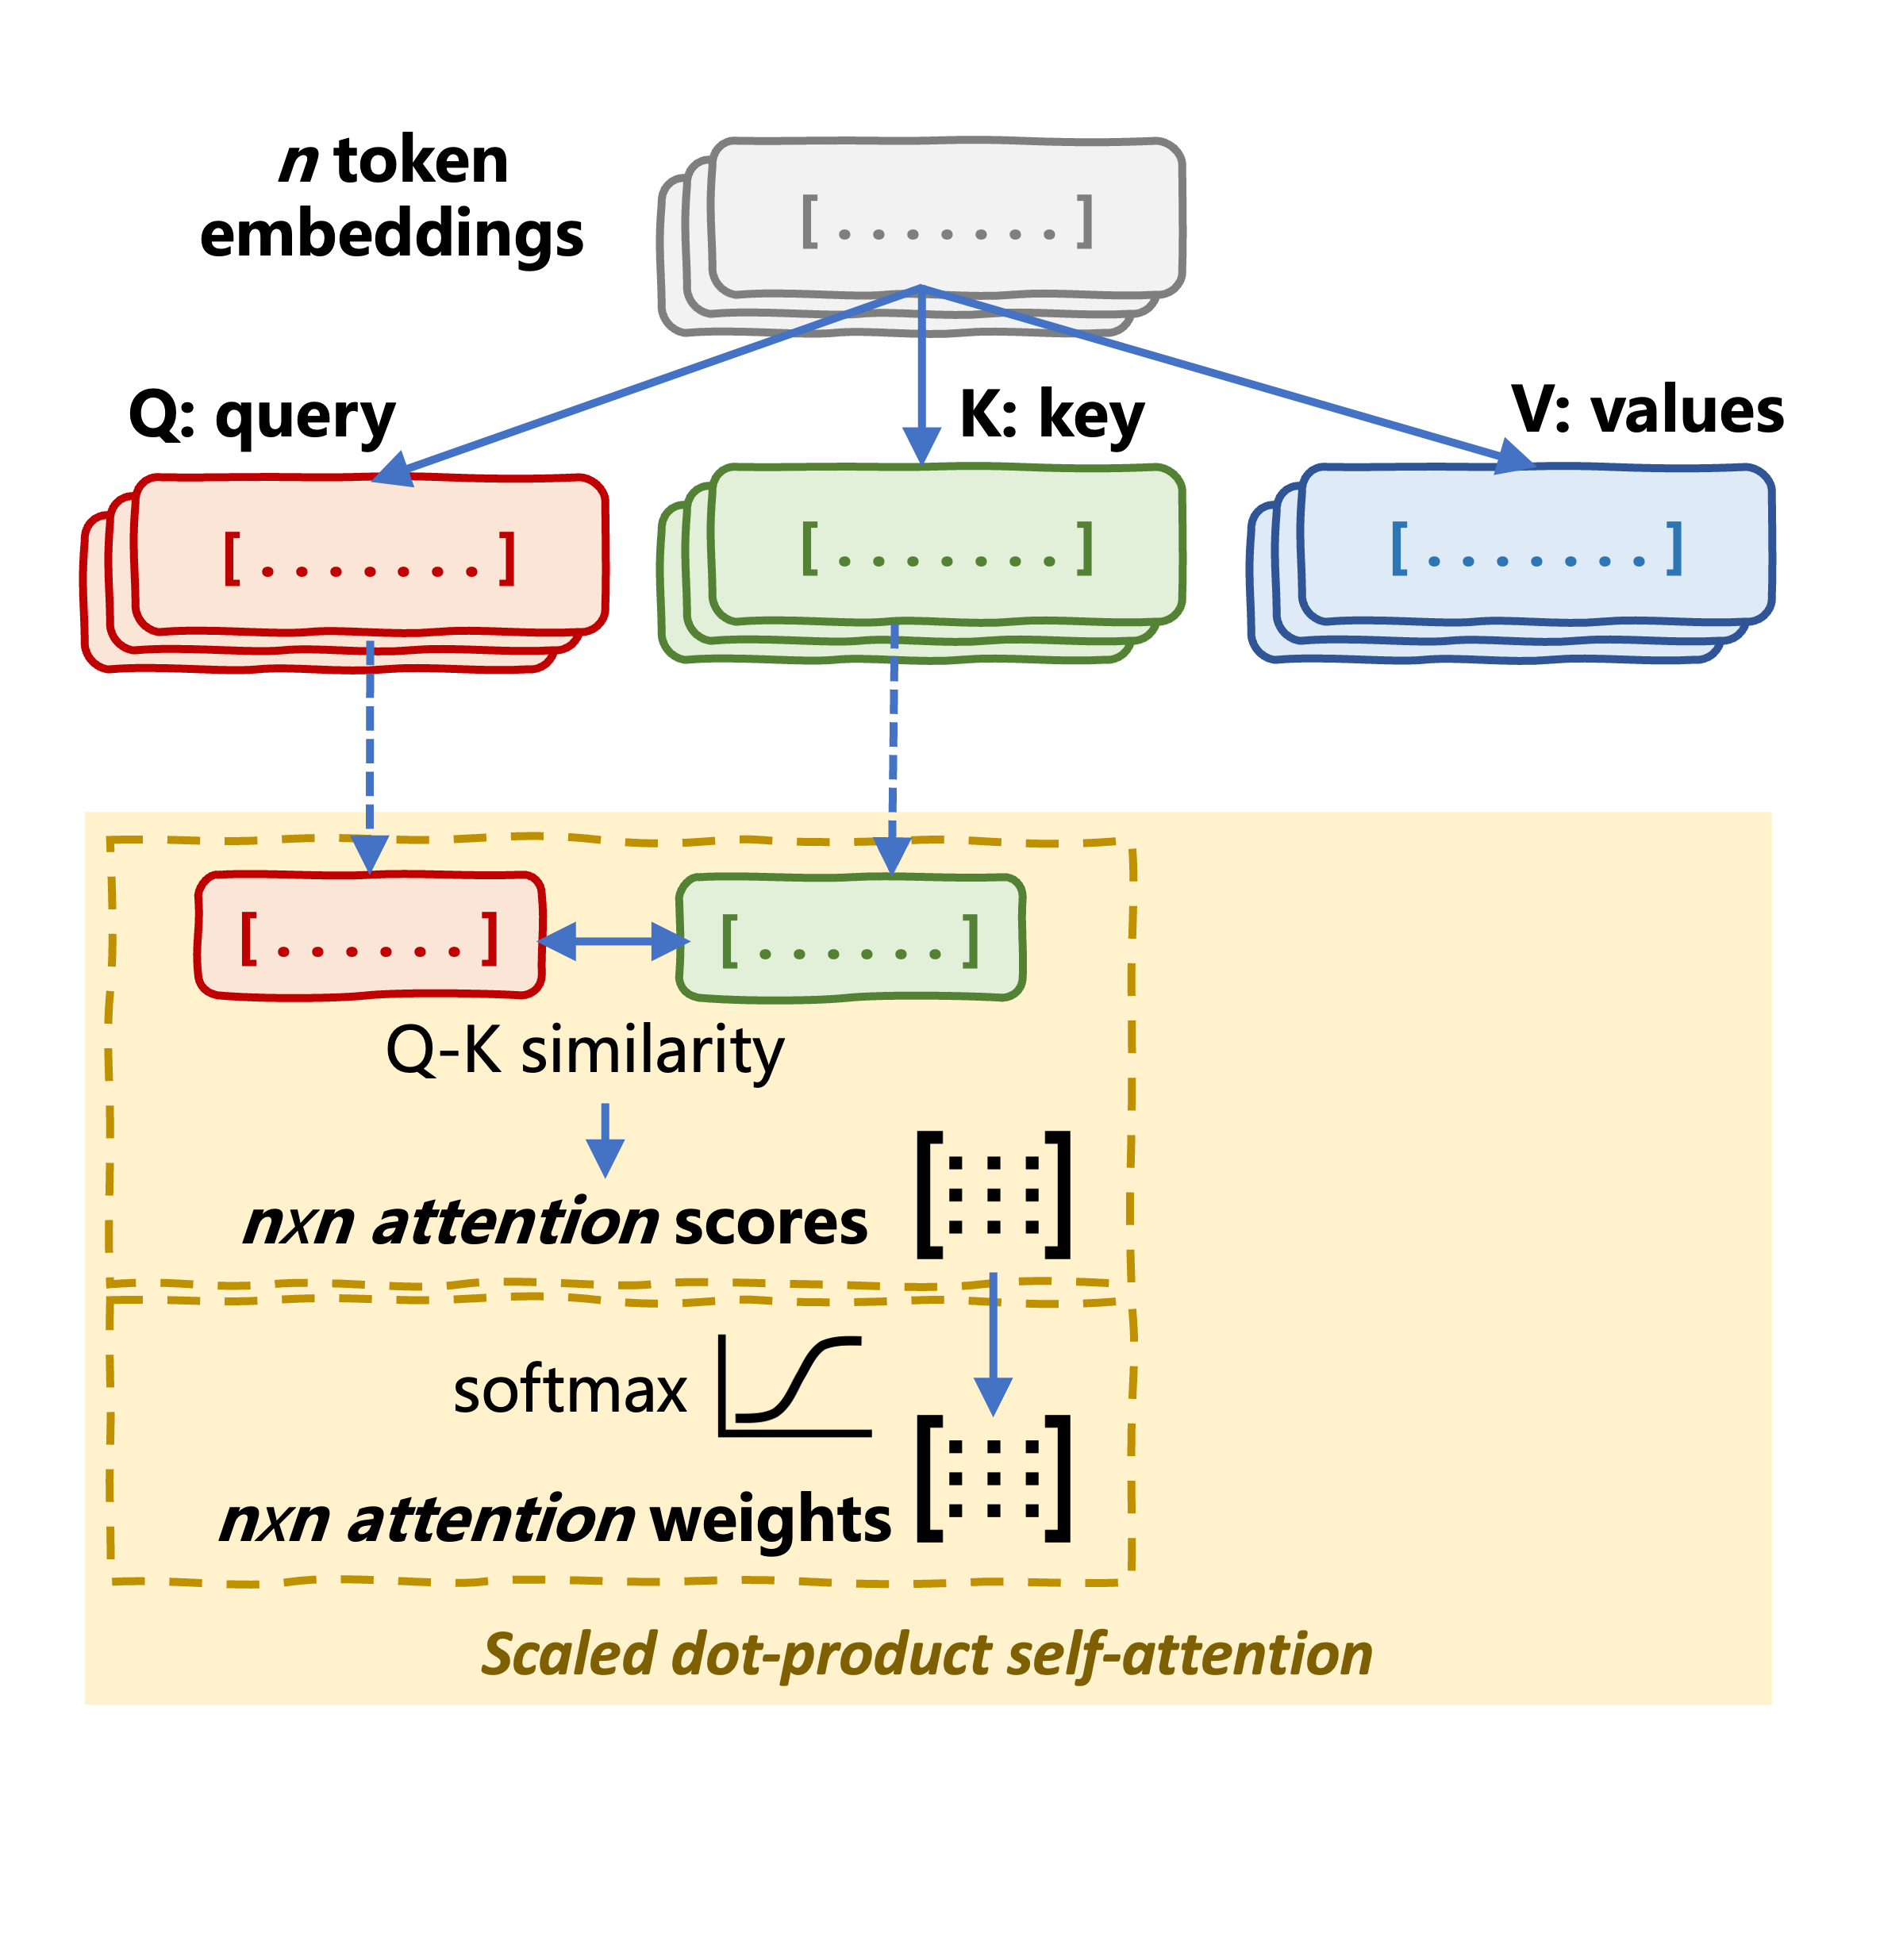
  • Pesos de atención: escalado con softmax
Modelos Transformer con PyTorch

Mecanismo de autoatención

Anatomía del mecanismo de autoatención

  • Puntuaciones de atención: similitud Q-K → producto punto
  • Pesos de atención: escalado con softmax


Orange is my favorite fruit
Query: Orange
Attention weights: .21 .03 .05 .31 .40
Modelos Transformer con PyTorch

Mecanismo de autoatención

Anatomía del mecanismo de autoatención

  • Puntuaciones de atención: similitud Q-K → producto punto
  • Pesos de atención: escalado con softmax


Orange is my favorite fruit
Query: Orange
Attention weights: .21 .03 .05 .31 .40
Modelos Transformer con PyTorch

Mecanismo de autoatención

Anatomía del mecanismo de autoatención

  • Puntuaciones de atención: similitud Q-K → producto punto
  • Pesos de atención: escalado con softmax


Orange is my favorite fruit
Query: Orange
Attention weights: .21 .03 .05 .31 .40
Modelos Transformer con PyTorch

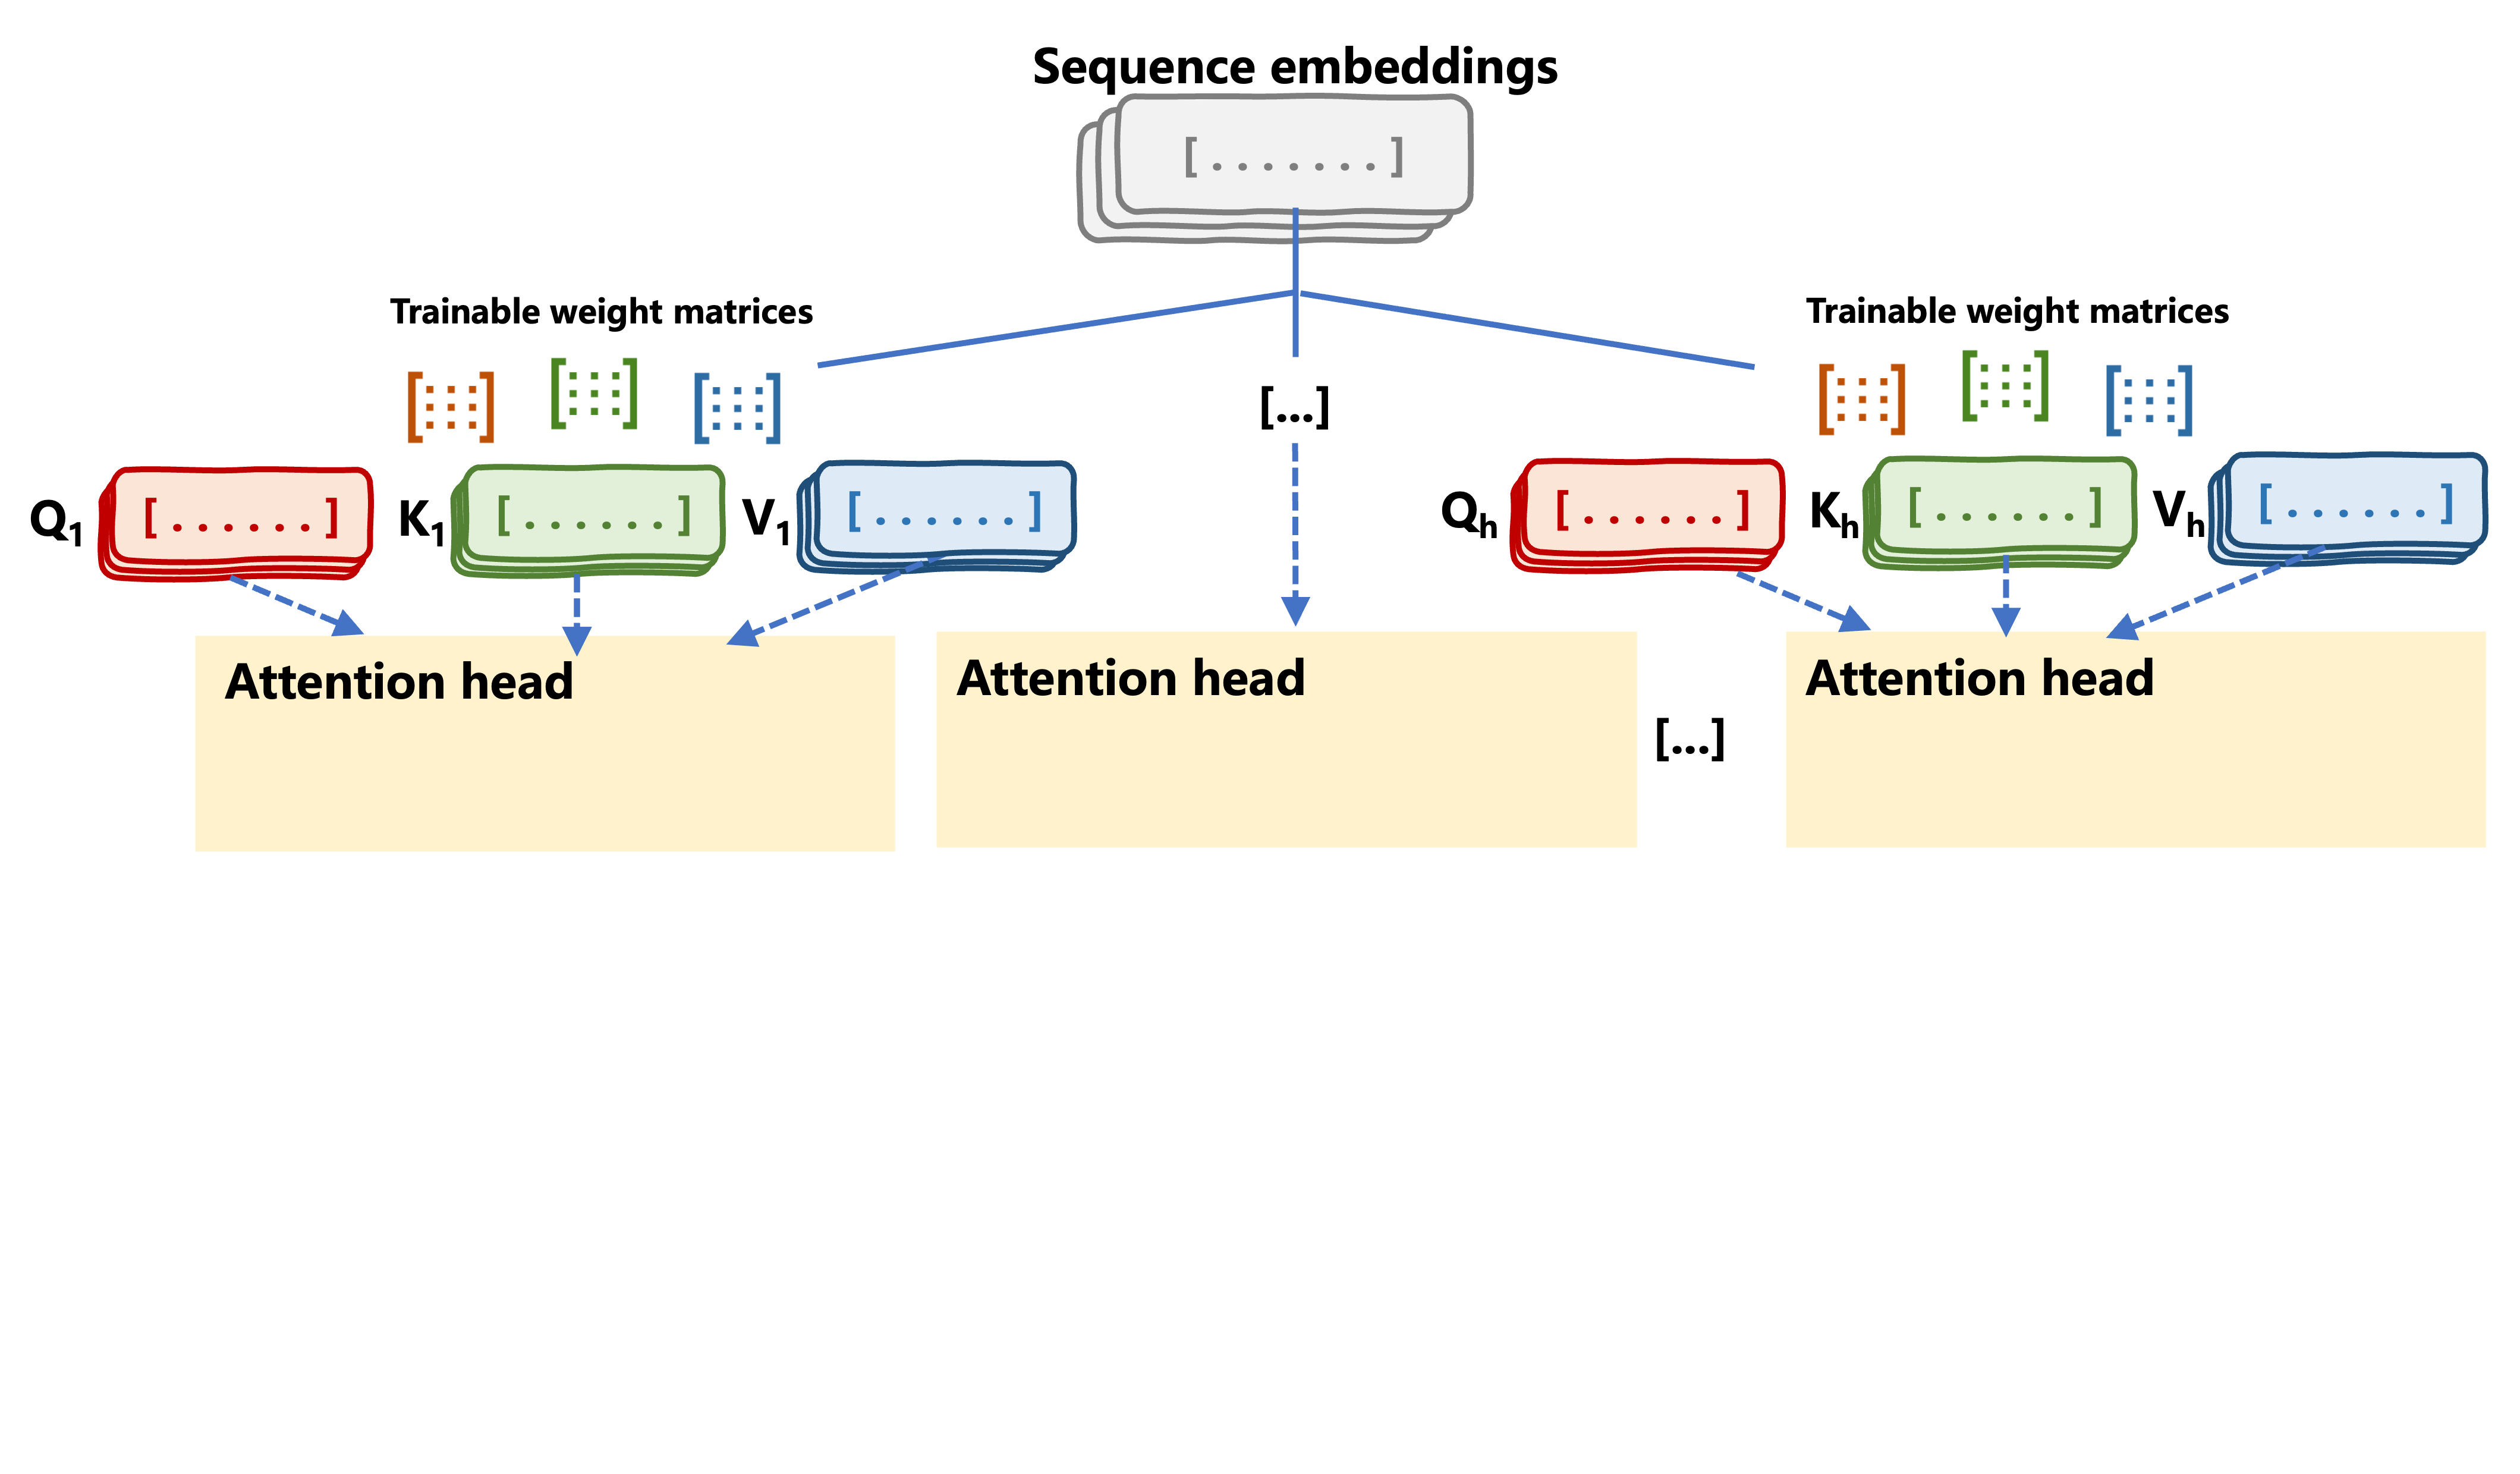
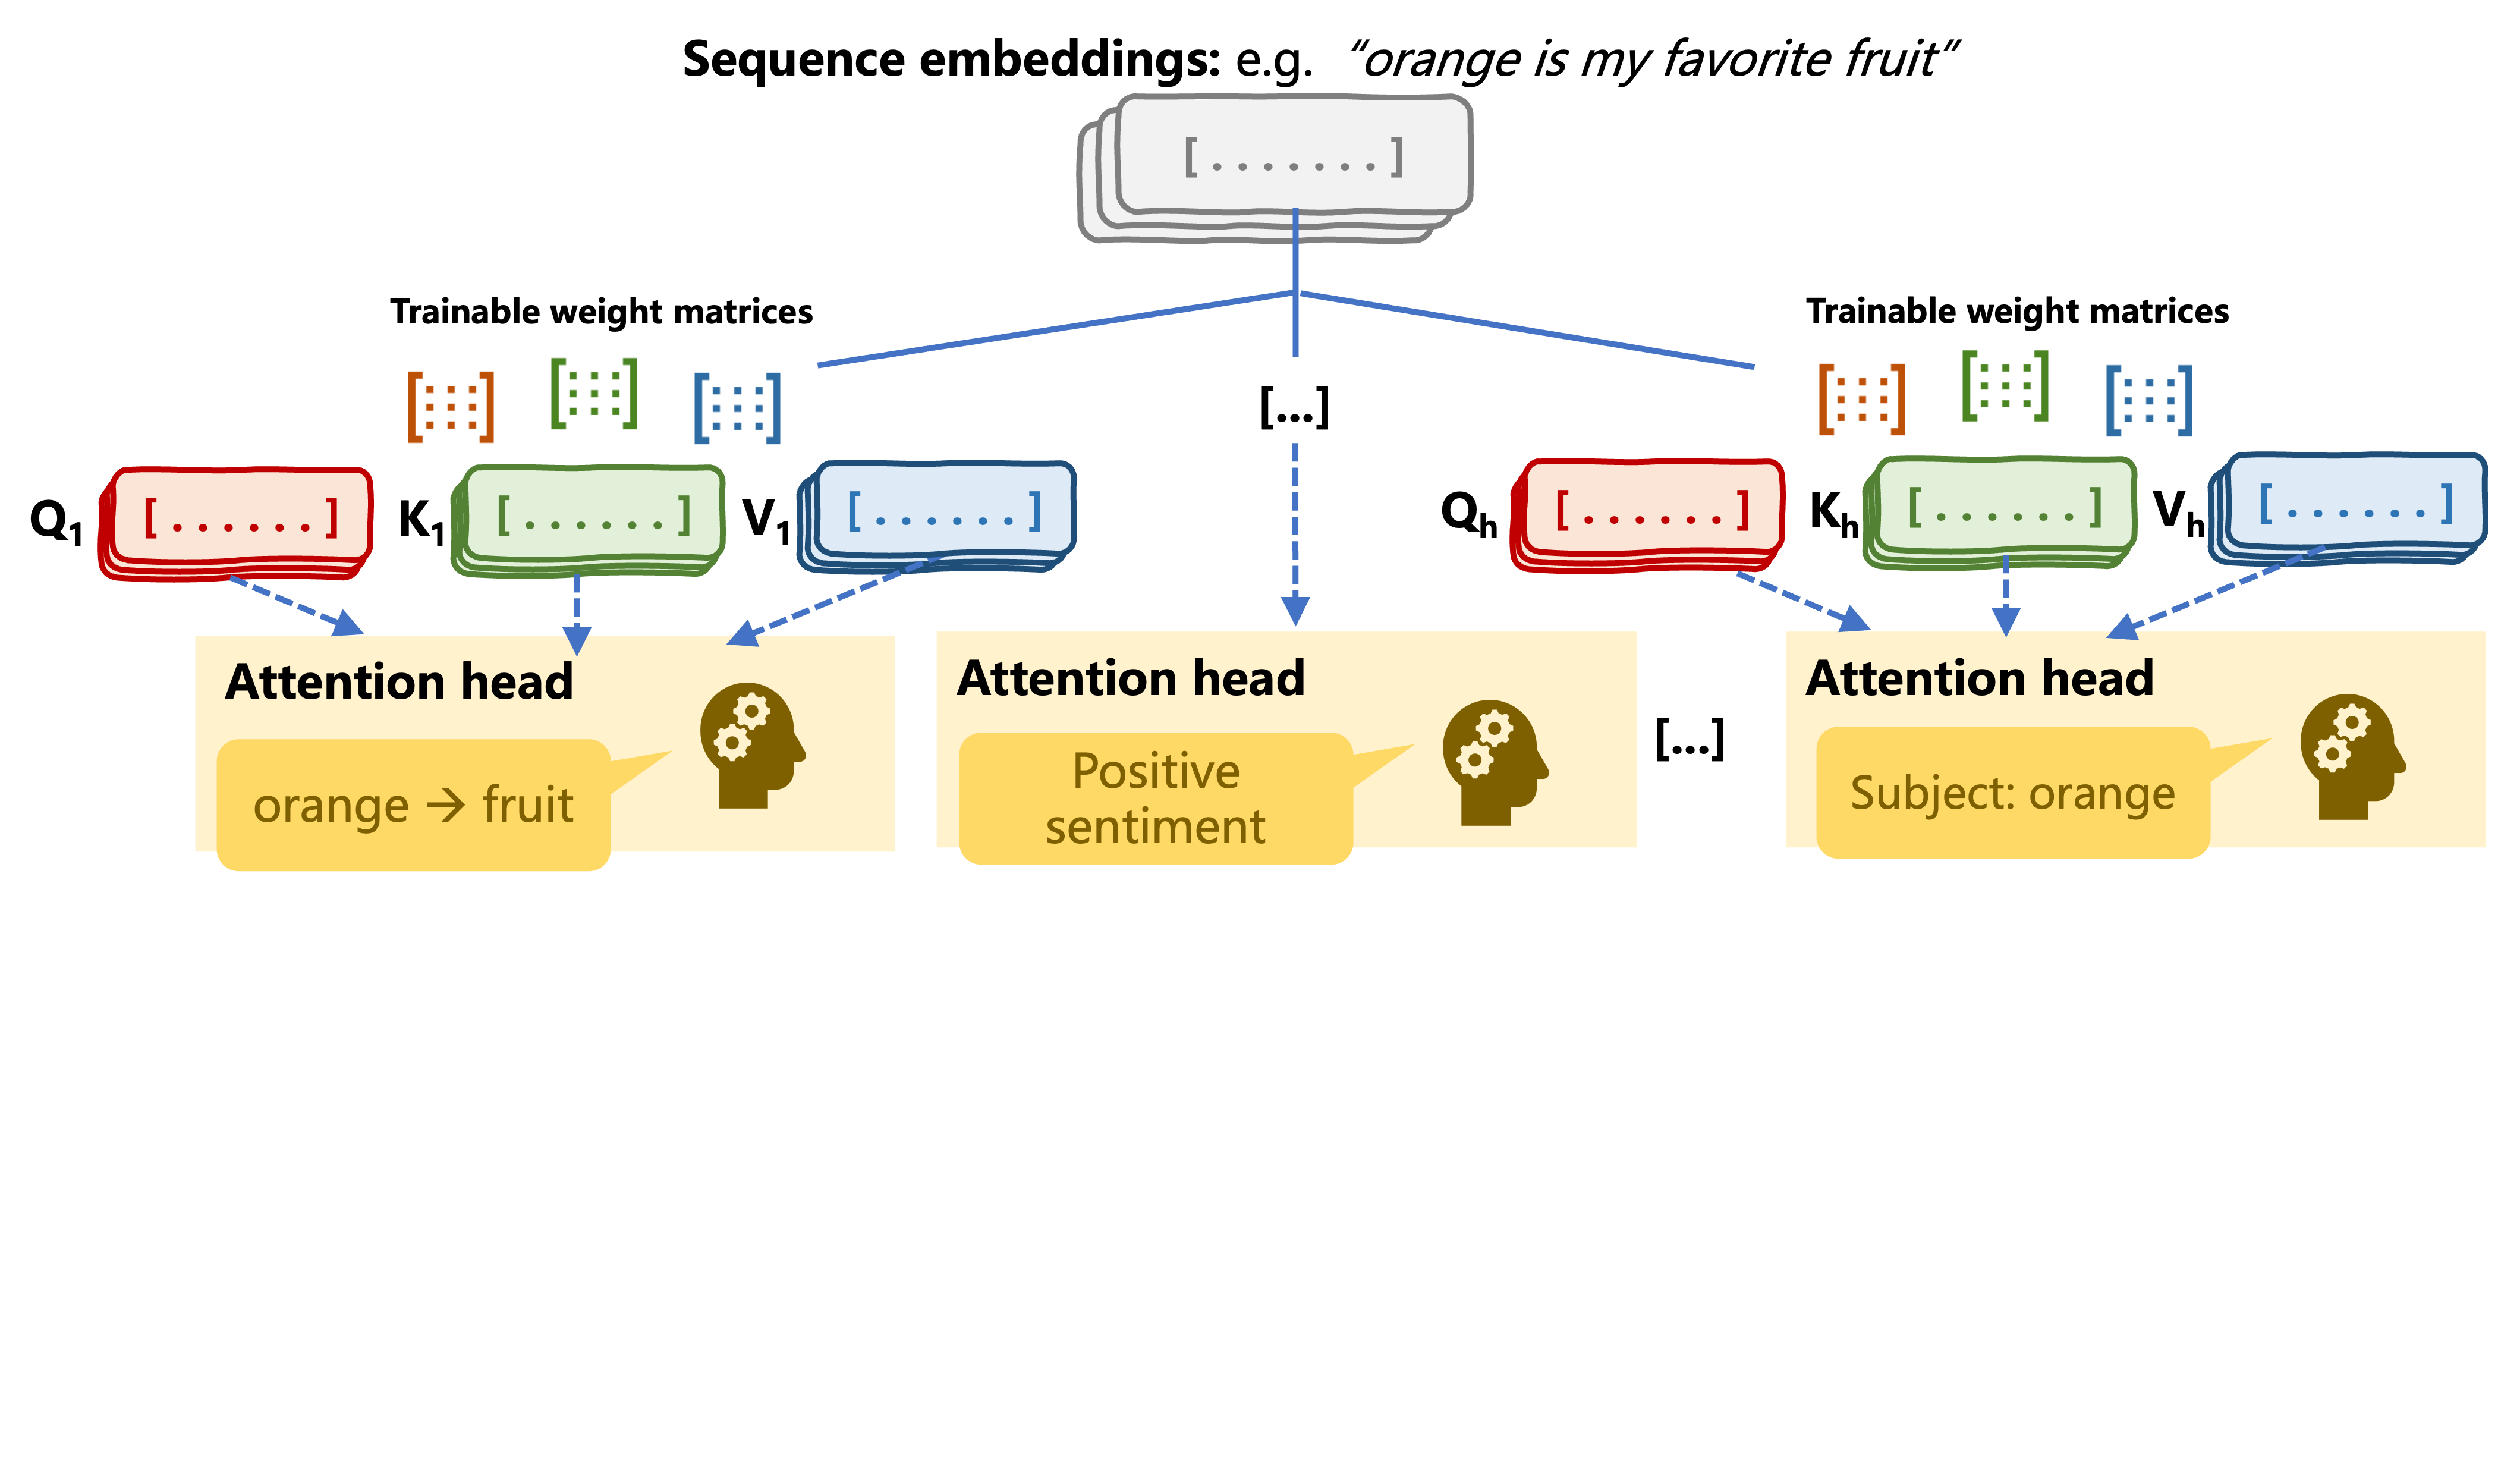
Atención multi-cabeza

Autoatención multi-cabeza

Modelos Transformer con PyTorch

Atención multi-cabeza

Autoatención multi-cabeza

Modelos Transformer con PyTorch

Atención multi-cabeza

Autoatención multi-cabeza

Modelos Transformer con PyTorch
import torch.nn as nn
import torch.nn.functional as F

class MultiHeadAttention(nn.Module):

def __init__(self, d_model, num_heads): super().__init__()
assert d_model % num_heads == 0, "d_model must be divisible by num_heads."
self.num_heads = num_heads self.d_model = d_model self.head_dim = d_model // num_heads
self.query_linear = nn.Linear(d_model, d_model, bias=False) self.key_linear = nn.Linear(d_model, d_model, bias=False) self.value_linear = nn.Linear(d_model, d_model, bias=False)
self.output_linear = nn.Linear(d_model, d_model)
  • num_heads: nº de cabezas de atención; cada una maneja embeddings de tamaño head_dim
  • bias=False: sin impacto en rendimiento y reduce complejidad (solo para entradas)
Modelos Transformer con PyTorch
    def split_heads(self, x, batch_size):

seq_length = x.size(1) x = x.reshape(batch_size, seq_length, self.num_heads, self.head_dim) return x.permute(0, 2, 1, 3)
def compute_attention(self, query, key, value, mask=None):
scores = torch.matmul(query, key.transpose(-2, -1)) / (self.head_dim ** 0.5)
if mask is not None: scores = scores.masked_fill(mask == 0, float('-inf'))
attention_weights = F.softmax(scores, dim=-1) return torch.matmul(attention_weights, value)
def combine_heads(self, x, batch_size):
x = x.permute(0, 2, 1, 3).contiguous() return x.view(batch_size, -1, self.d_model)
  • compute_attention(): calcula los pesos de atención con F.softmax()
  • torch.matmul(attention_weights, value): suma ponderada de los valores
Modelos Transformer con PyTorch
    def forward(self, query, key, value, mask=None):
        batch_size = query.size(0)

        query = self.split_heads(self.query_linear(query), batch_size)
        key = self.split_heads(self.key_linear(key), batch_size)
        value = self.split_heads(self.value_linear(value), batch_size)

        attention_weights = self.compute_attention(query, key, value, mask)


output = self.combine_heads(attention_weights, batch_size)
return self.output_linear(output)
  • self.output_linear(): concatena y proyecta las salidas de las cabezas
Modelos Transformer con PyTorch

¡Vamos a practicar!

Modelos Transformer con PyTorch

Preparing Video For Download...