Ajuste fino de modelos con Hugging Face
Ajuste fino con Llama 3

Francesca Donadoni
Curriculum Manager, DataCamp
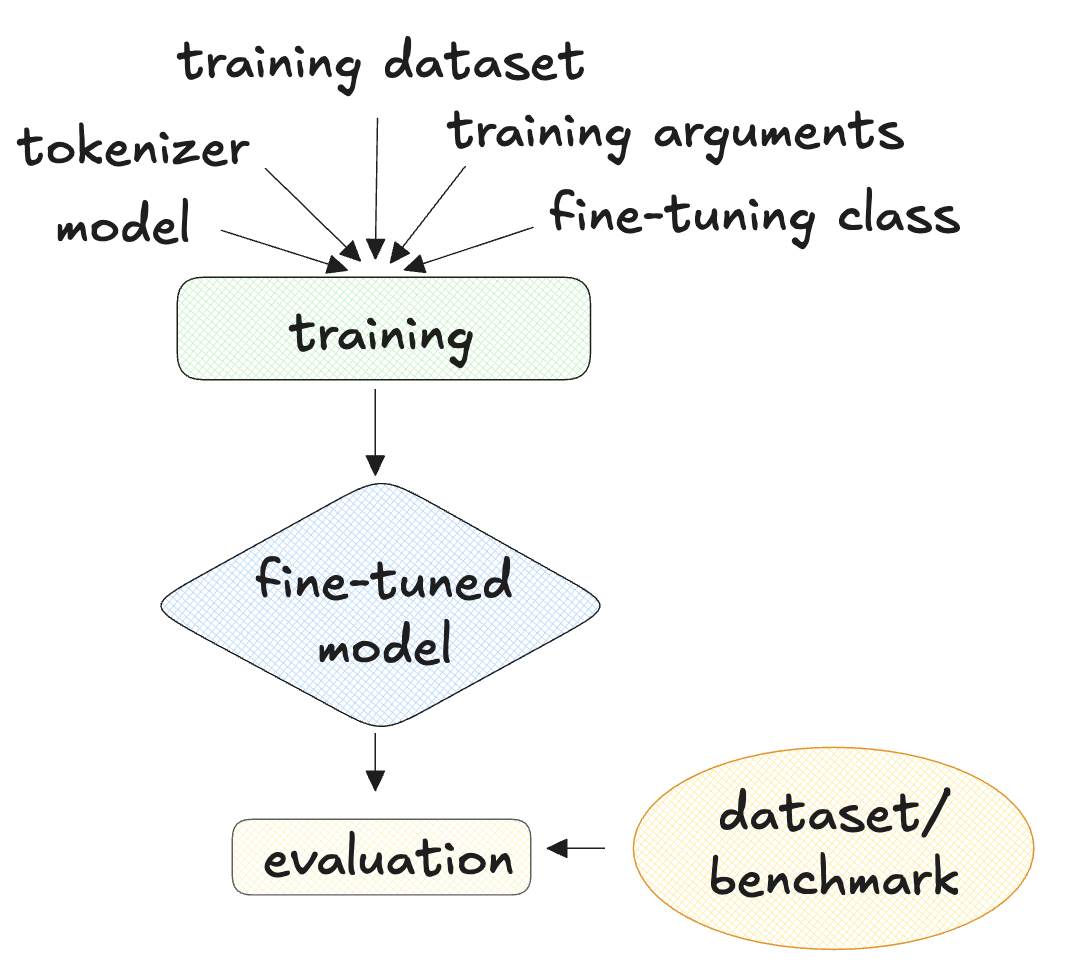
¿Qué necesitamos para hacer ajuste fino?
- Modelo de lenguaje + tokenizer (un modelo LLama, como TinyLLama-v0)
- Conjunto de entrenamiento (Bitext customer service dataset)
- Parámetros de entrenamiento
- Realizar ajuste fino (SFTTrainer de TRL)
- Benchmark o conjunto de evaluación
Cómo cargar modelos y tokenizers con clases Auto
model_name="Maykeye/TinyLLama-v0" model = AutoModelForCausalLM.from_pretrained(model_name) tokenizer = AutoTokenizer.from_pretrained(model_name)tokenizer.pad_token = tokenizer.eos_token
1 https://huggingface.co/docs/transformers/main/en/model_doc/auto
Definir parámetros de entrenamiento con TrainingArguments
training_arguments = TrainingArguments(per_device_train_batch_size=1,learning_rate=2e-3,max_grad_norm=0.3,max_steps=200,... gradient_accumulation_steps=2, save_steps=10,)
1 https://huggingface.co/docs/transformers/v4.40.1/en/main_classes/trainer#transformers.TrainingArguments
Cómo configurar el entrenamiento con SFTTrainer
trainer = SFTTrainer(model=model, tokenizer=tokenizer,train_dataset=dataset, dataset_text_field='conversation',max_seq_length=250,args=training_arguments)
Cómo interpretar resultados de ajuste fino con SFTTrainer
trainer.train()
TrainOutput(global_step=200, training_loss=1.9401231002807617,
            metrics={'train_runtime': 142.5501,
                     'train_samples_per_second': 2.806,
                     'train_steps_per_second': 1.403,
                     'total_flos': 1461265827840.0,
                     'train_loss': 1.9401231002807617,
                     'epoch': 2.0})
Cómo evaluar un modelo entrenado con ROUGE-1
- ROUGE-1: Proporción de solapamiento de palabras entre un texto de referencia y el generado
import evaluaterouge = evaluate.load('rouge')predictions = ["hello there", "general kenobi"] references = ["hello there", "master yoda"]results = rouge.compute(predictions=predictions, references=references) print(results)
{'rouge1': 0.5, 'rouge2': 0.5, 'rougeL': 0.5, 'rougeLsum': 0.5}
1 https://huggingface.co/spaces/evaluate-metric/rouge
Cómo usar la puntuación ROUGE-1
- Usa el conjunto de evaluación en
evaluation_dataset
def generate_predictions_and_reference(dataset): predictions = [] references = [] for row in dataset: inputs = tokenizer.encode(row["instruction"], return_tensors="pt")outputs = model.generate(inputs)decoded_outputs = tokenizer.decode(outputs[0, inputs.shape[1]:], skip_special_tokens = True)references += [row["response"]] predictions += [decoded_outputs] return references, predictions
Cómo ejecutar ROUGE-1 en un conjunto de evaluación
references, predictions = generate_predictions_and_reference(evaluation_dataset)
rouge = evaluate.load('rouge')
results = rouge.compute(predictions=predictions, references=references)
print(results)
Ajuste fino vs. sin ajuste fino
Con ajuste fino
{'rouge1': 0.22425812699023645,
 'rouge2': 0.039502543246449,
 'rougeL': 0.1501513006868983,
 'rougeLsum': 0.18685597710721613}
Sin ajuste fino
{'rouge1': 0.1310928764315105,
 'rouge2': 0.04581654122835097,
 'rougeL': 0.08415351421221628,
 'rougeLsum': 0.1224749866097021}
¡Vamos a practicar!
Ajuste fino con Llama 3

