Cómo ganar una competición de Kaggle con Python
Yauhen Babakhin
Kaggle Grandmaster

Fuga en las features: uso de datos no disponibles en producción
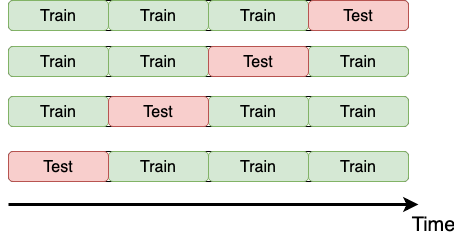
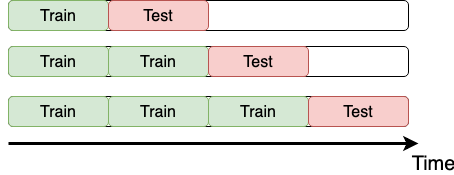
Fuga en la estrategia de validación: la validación no refleja el caso real


# Importar TimeSeriesSplit
from sklearn.model_selection import TimeSeriesSplit
# Crear el objeto TimeSeriesSplit
time_kfold = TimeSeriesSplit(n_splits=5)
# Ordenar train por fecha
train = train.sort_values('date')
# Iterar por cada split de validación cruzada
for train_index, test_index in time_kfold.split(train):
cv_train, cv_test = train.iloc[train_index], train.iloc[test_index]
# Lista para los resultados fold_metrics = []for train_index, test_index in CV_STRATEGY.split(train): cv_train, cv_test = train.iloc[train_index], train.iloc[test_index]# Entrenar un modelo model.fit(cv_train)# Hacer predicciones predictions = model.predict(cv_test)# Calcular la métrica metric = evaluate(cv_test, predictions) fold_metrics.append(metric)
| Nº de fold | MSE Modelo A | MSE Modelo B |
|---|---|---|
| Fold 1 | 2.95 | 2.97 |
| Fold 2 | 2.84 | 2.45 |
| Fold 3 | 2.62 | 2.73 |
| Fold 4 | 2.79 | 2.83 |
import numpy as np
# Media simple entre folds
mean_score = np.mean(fold_metrics)
# Puntuación global de validación
overall_score_minimizing = np.mean(fold_metrics) + np.std(fold_metrics)
# O
overall_score_maximizing = np.mean(fold_metrics) - np.std(fold_metrics)
| Nº de fold | MSE Modelo A | MSE Modelo B |
|---|---|---|
| Fold 1 | 2.95 | 2.97 |
| Fold 2 | 2.84 | 2.45 |
| Fold 3 | 2.62 | 2.73 |
| Fold 4 | 2.79 | 2.83 |
| Media | 2.80 | 2.75 |
| Global | 2.919 | 2.935 |
Cómo ganar una competición de Kaggle con Python