Introducción a Spark SQL en Python
Mark Plutowski
Data Scientist
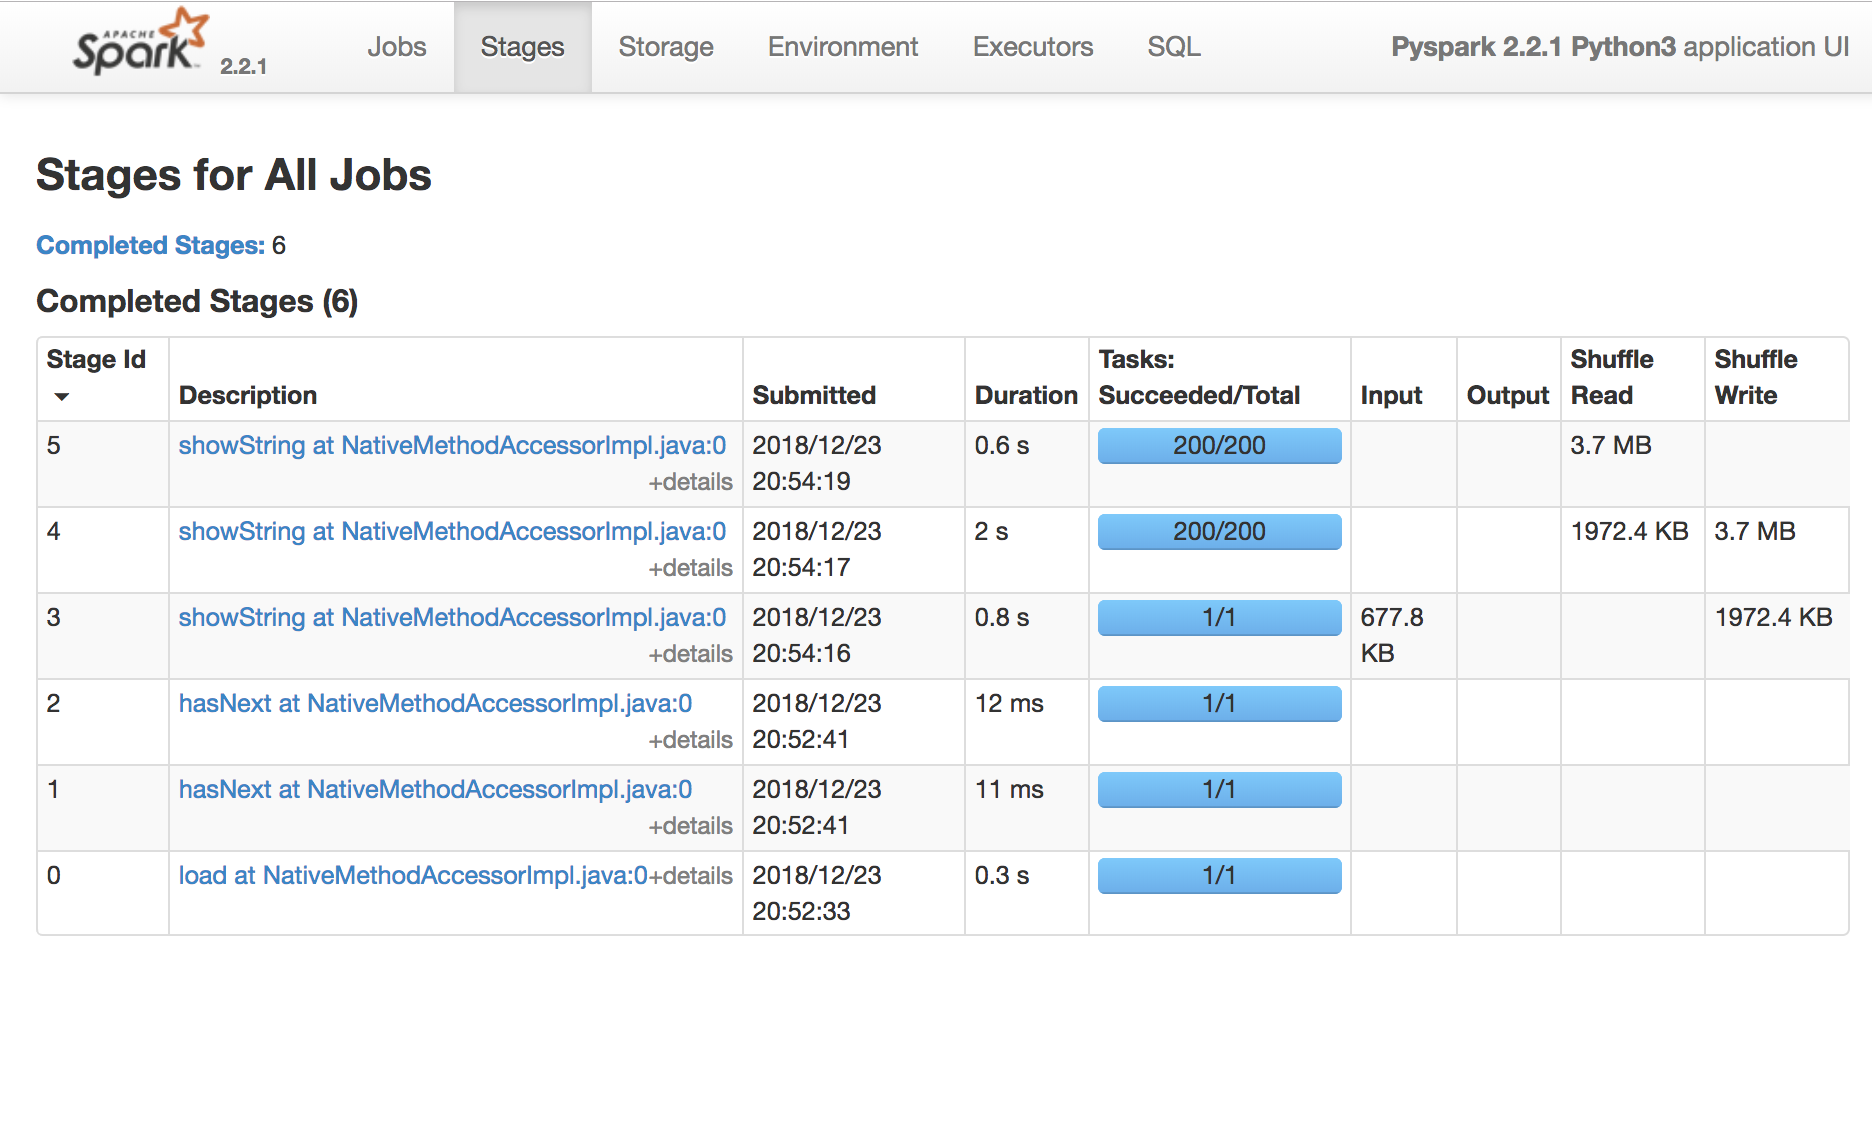
Una tarea de Spark es una unidad de ejecución que corre en una sola CPU
Una etapa de Spark agrupa tareas que hacen el mismo cálculo en paralelo, cada una sobre un subconjunto distinto de datos
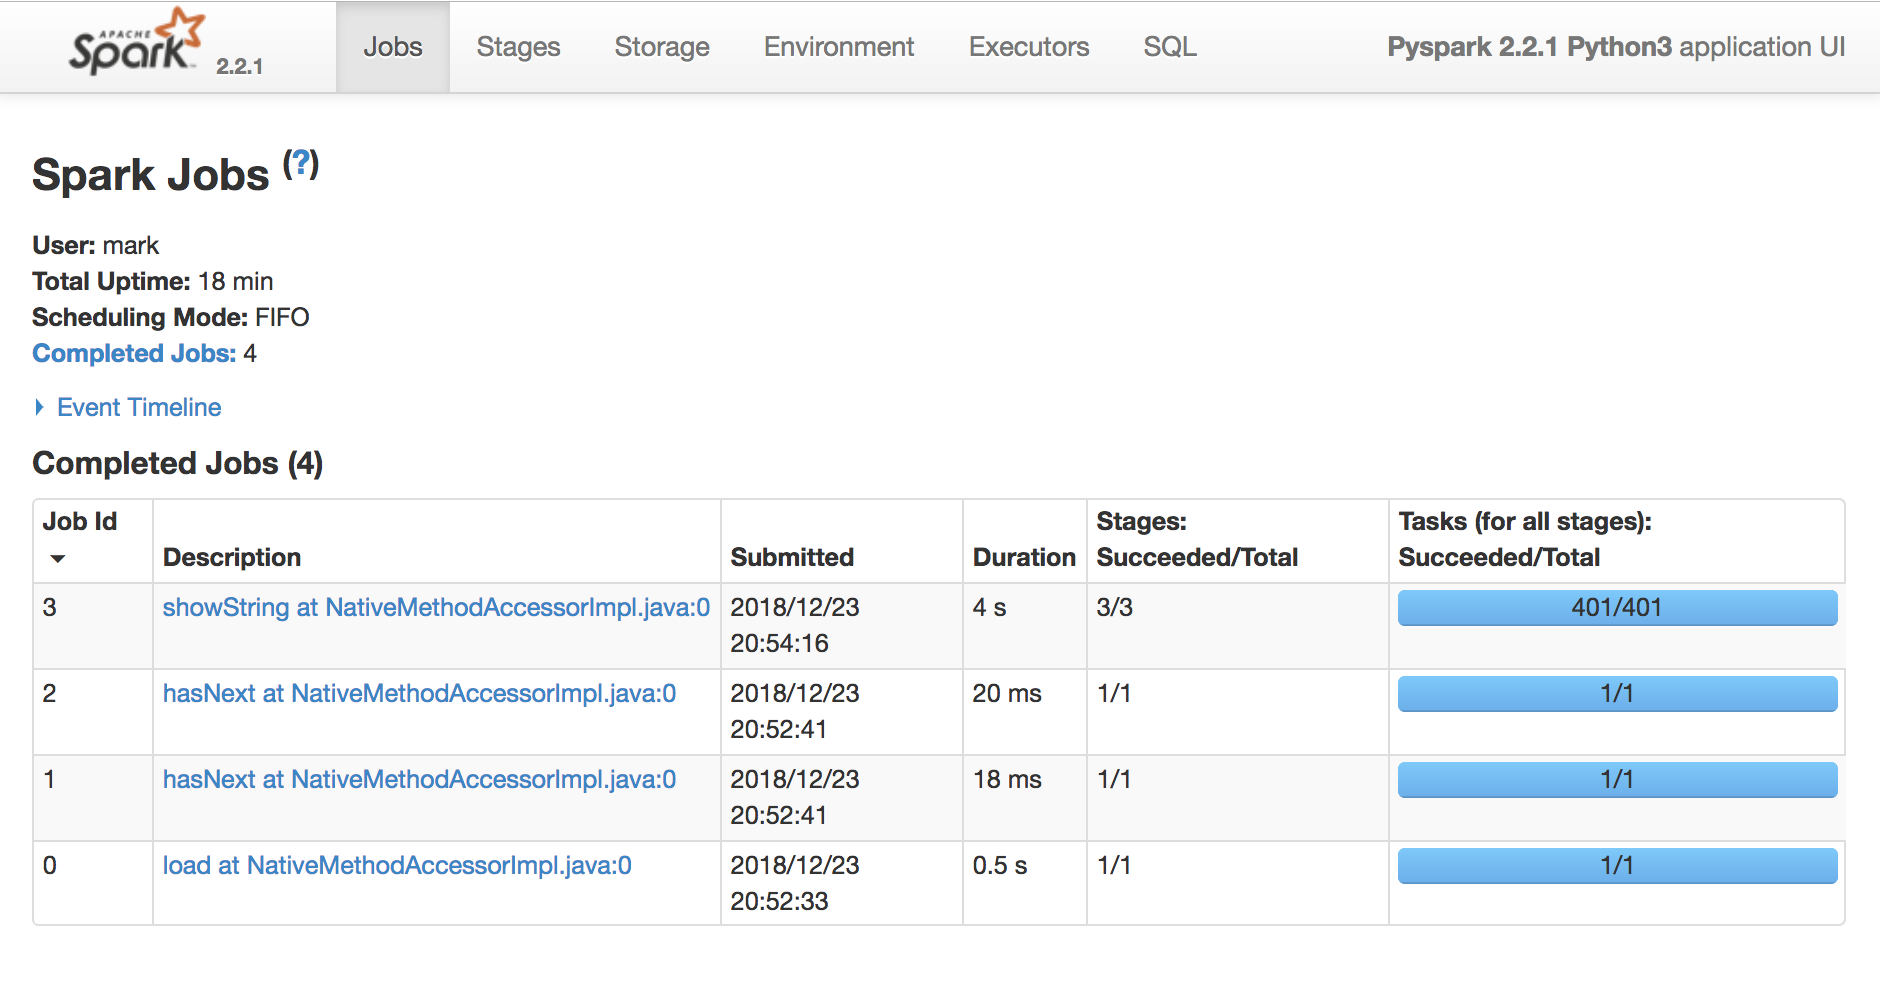
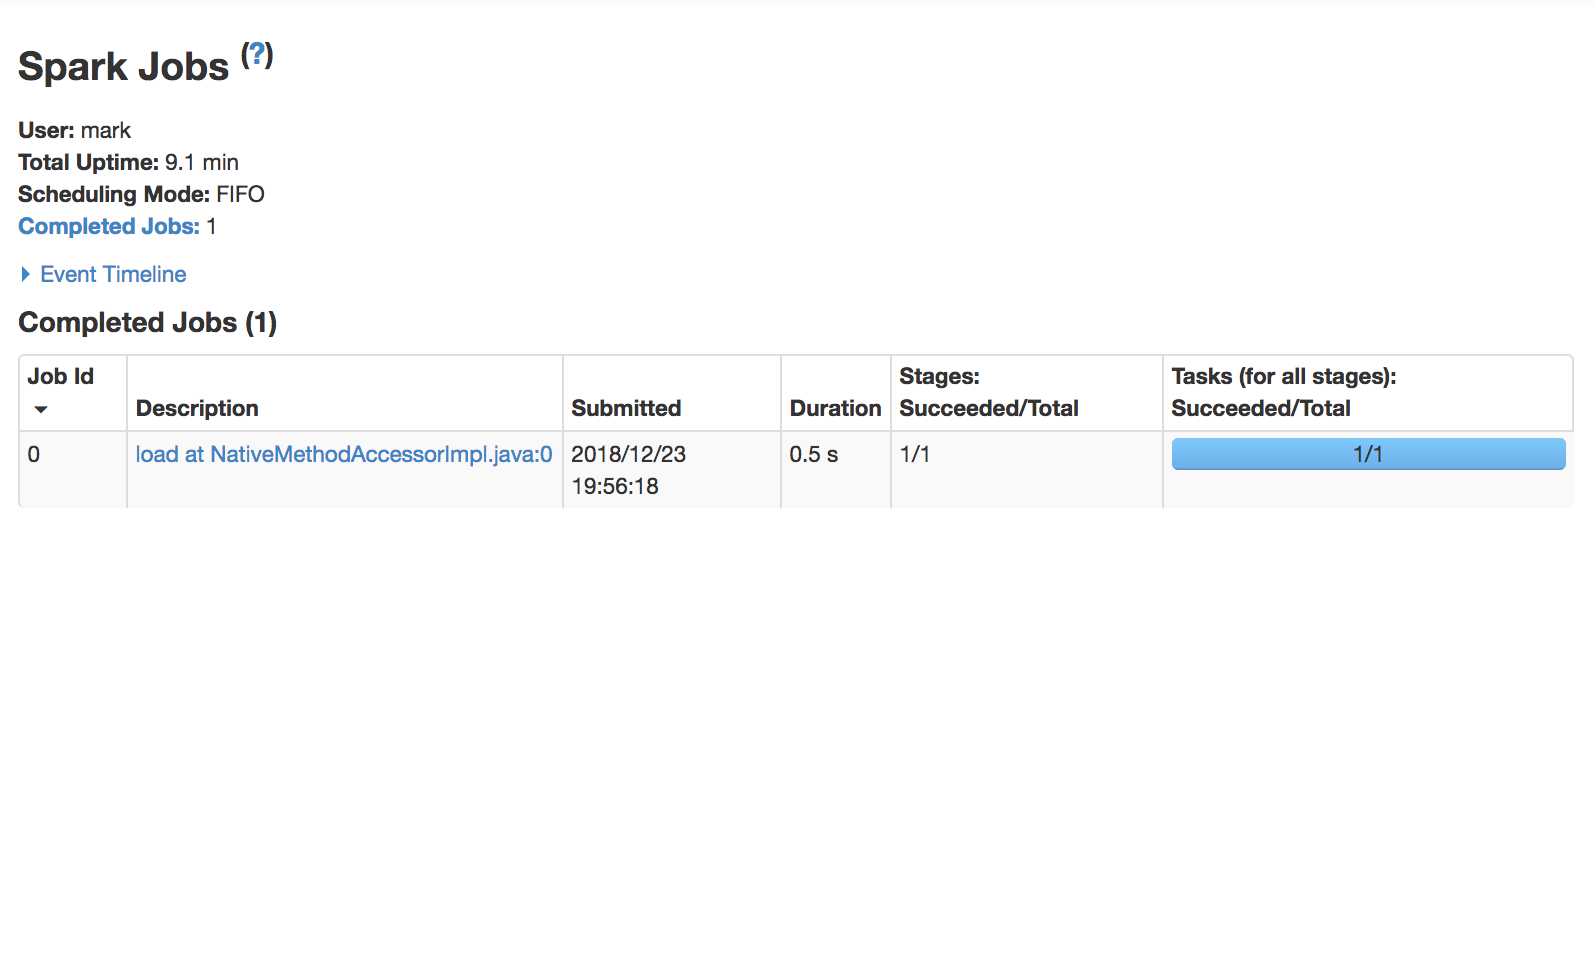
Un trabajo de Spark es un cómputo disparado por una acción, dividido en una o más etapas.

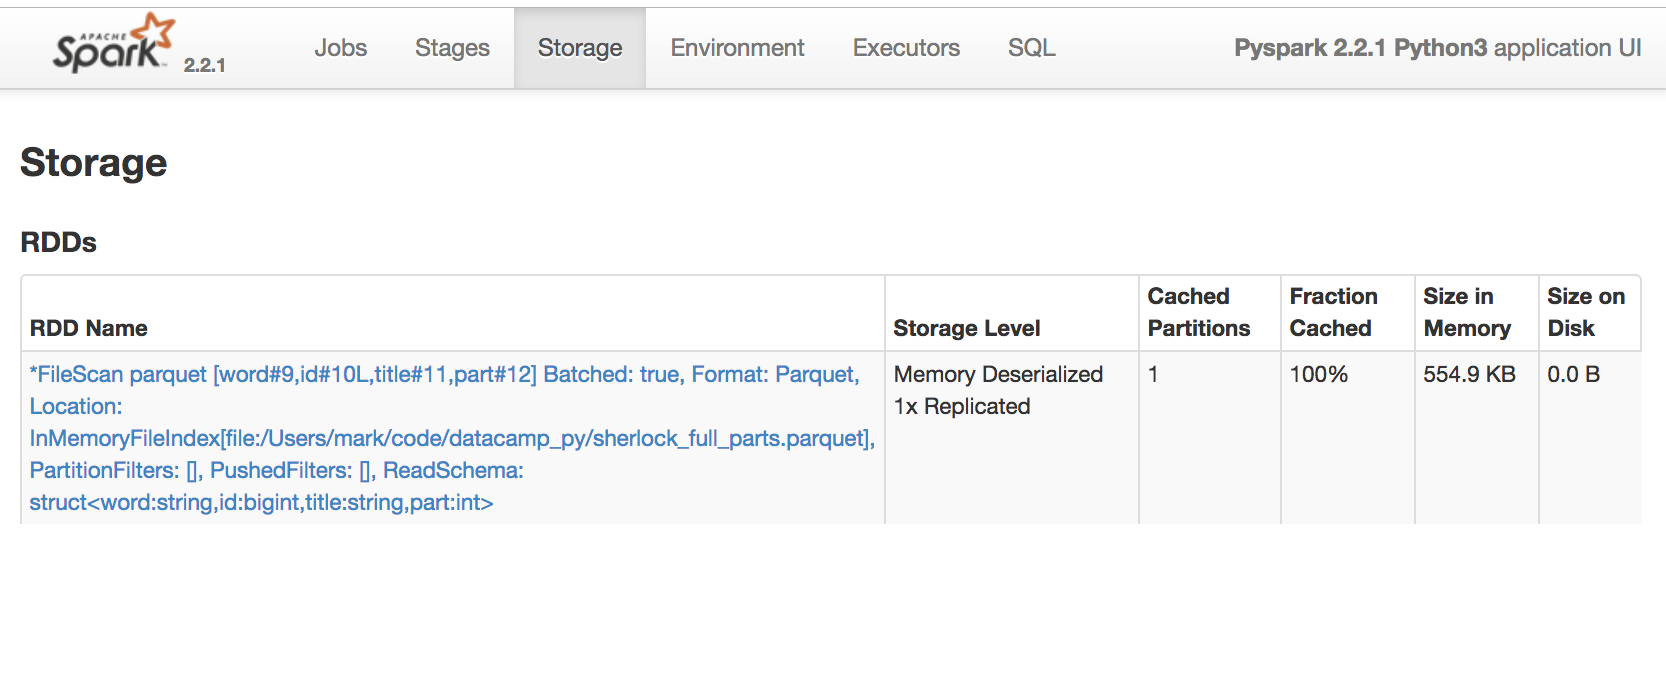
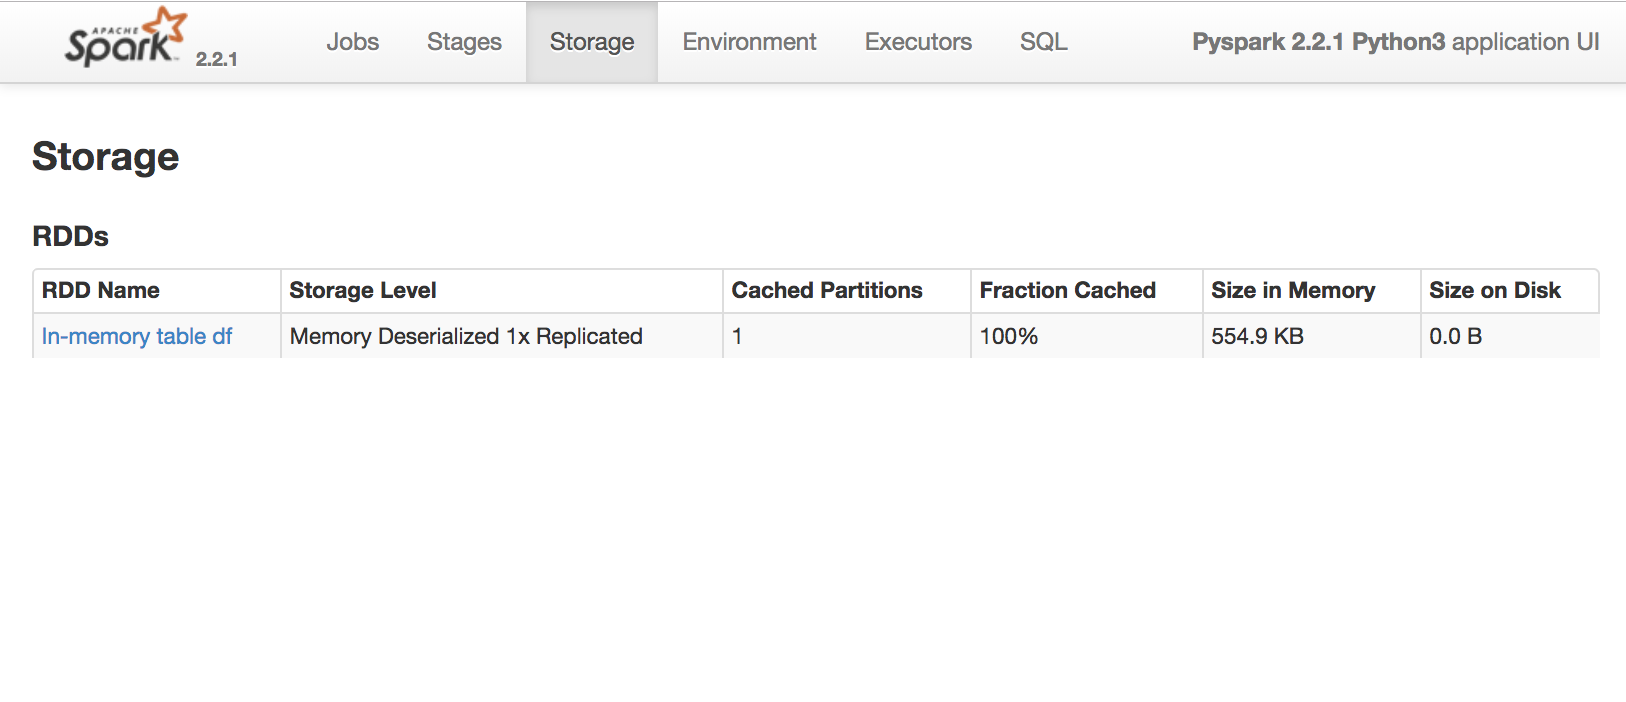
spark.catalog.cacheTable('table1')spark.catalog.uncacheTable('table1')spark.catalog.isCached('table1')spark.catalog.dropTempView('table1')spark.catalog.listTables()
[Table(name='text', database=None, description=None, tableType='TEMPORARY', isTemporary=True)]


Muestra dónde existen las particiones
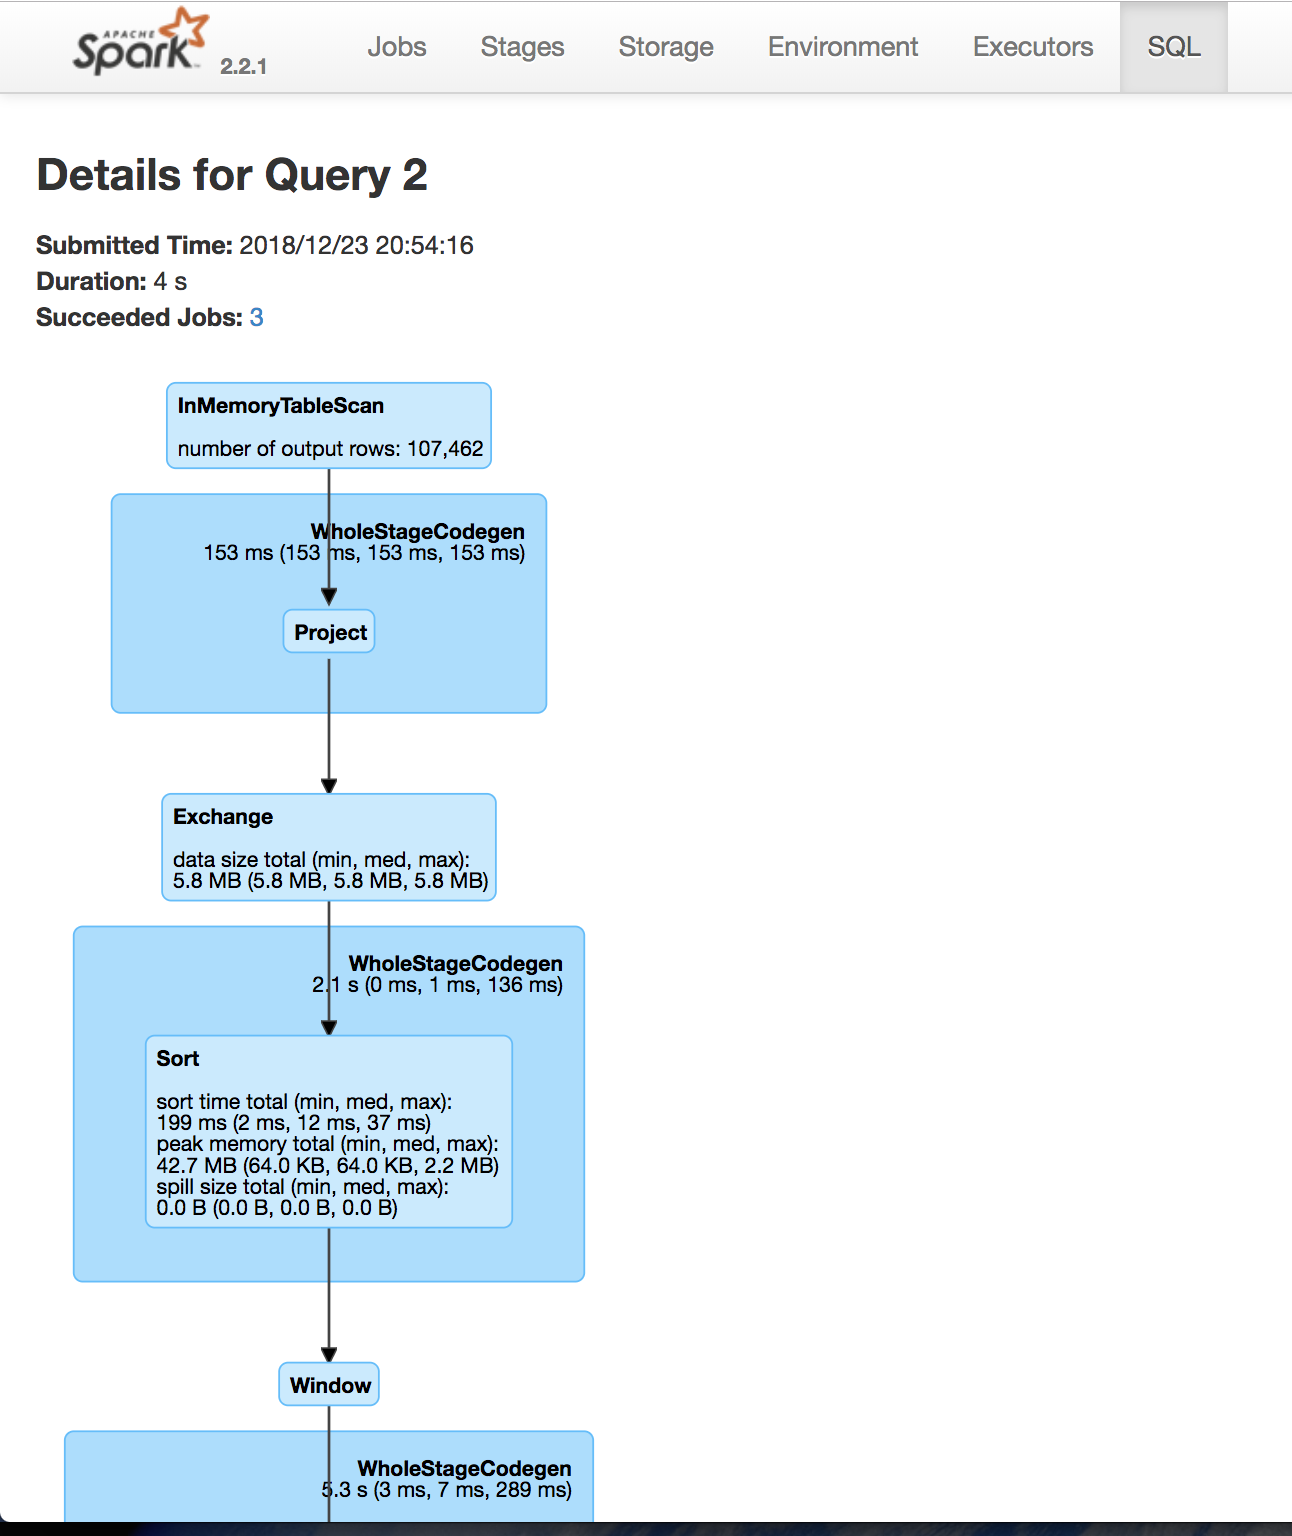
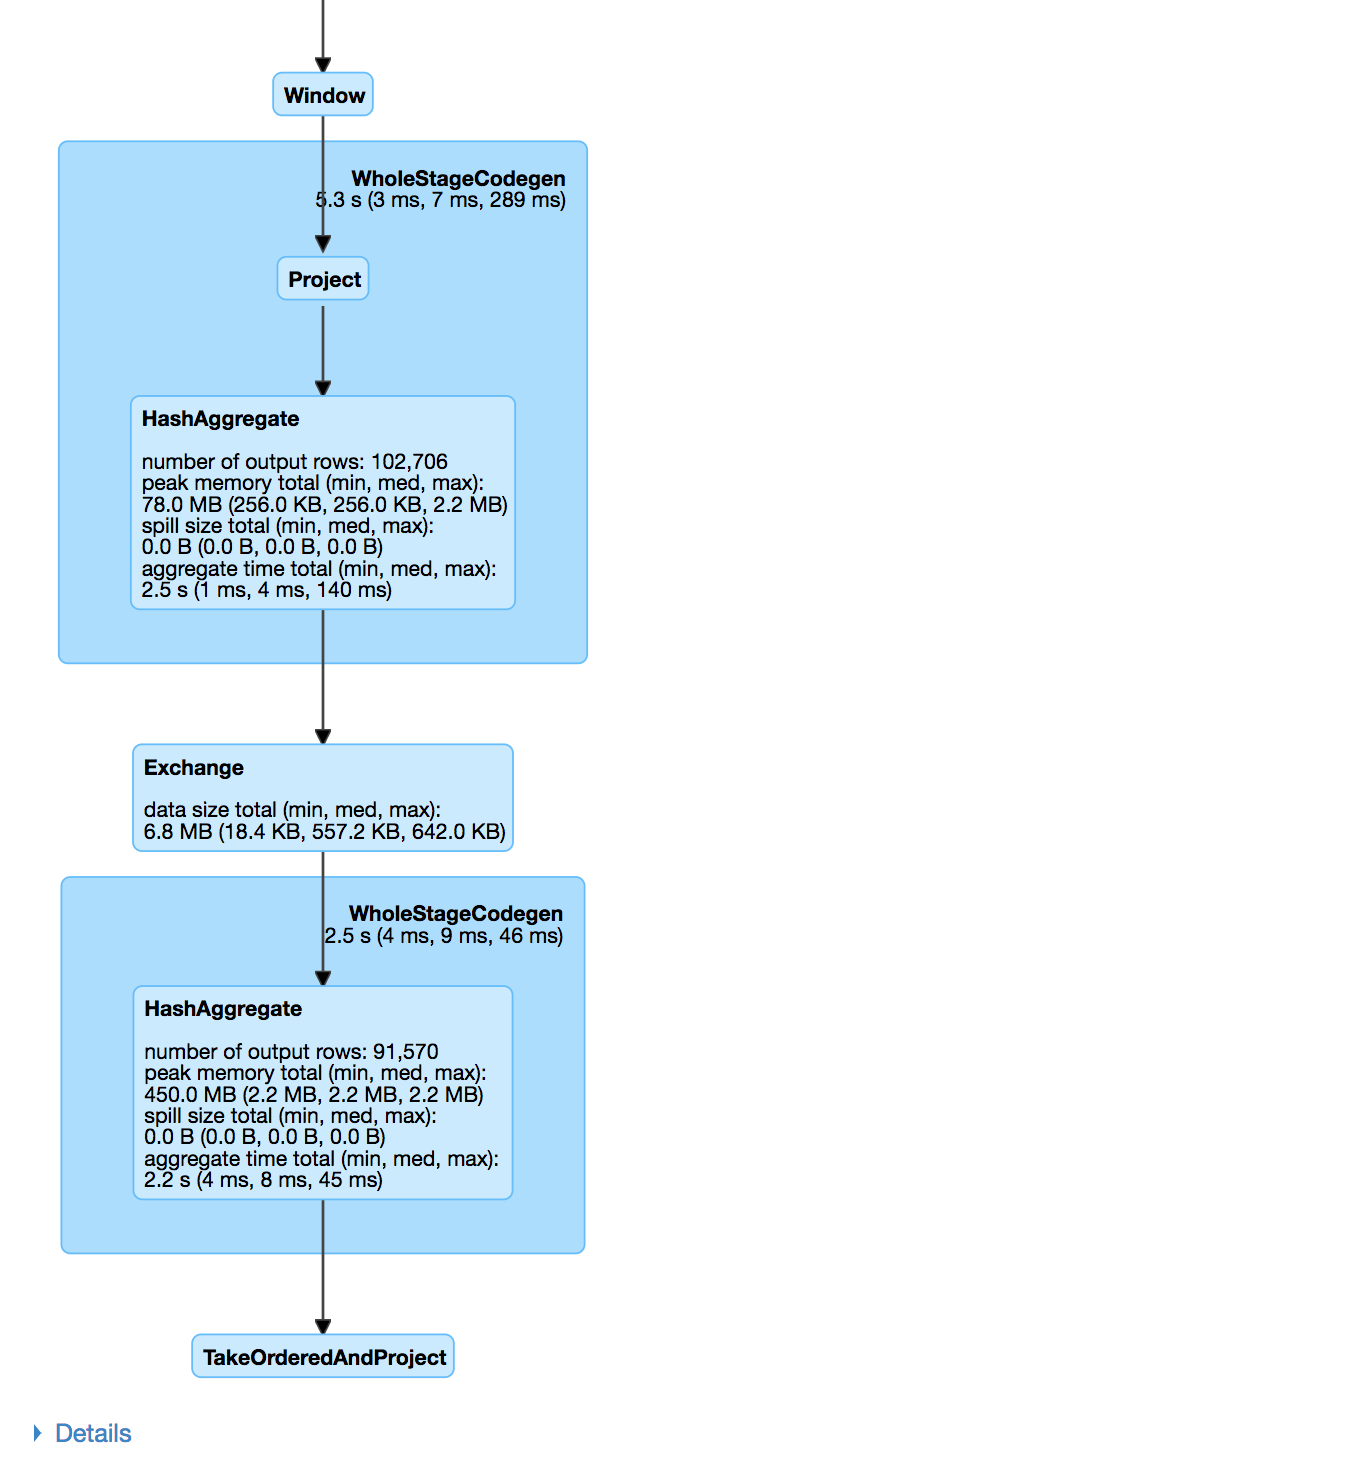
query3agg = """ SELECT w1, w2, w3, COUNT(*) as count FROM ( SELECT word AS w1, LEAD(word,1) OVER(PARTITION BY part ORDER BY id ) AS w2, LEAD(word,2) OVER(PARTITION BY part ORDER BY id ) AS w3 FROM df ) GROUP BY w1, w2, w3 ORDER BY count DESC """spark.sql(query3agg).show()


Introducción a Spark SQL en Python