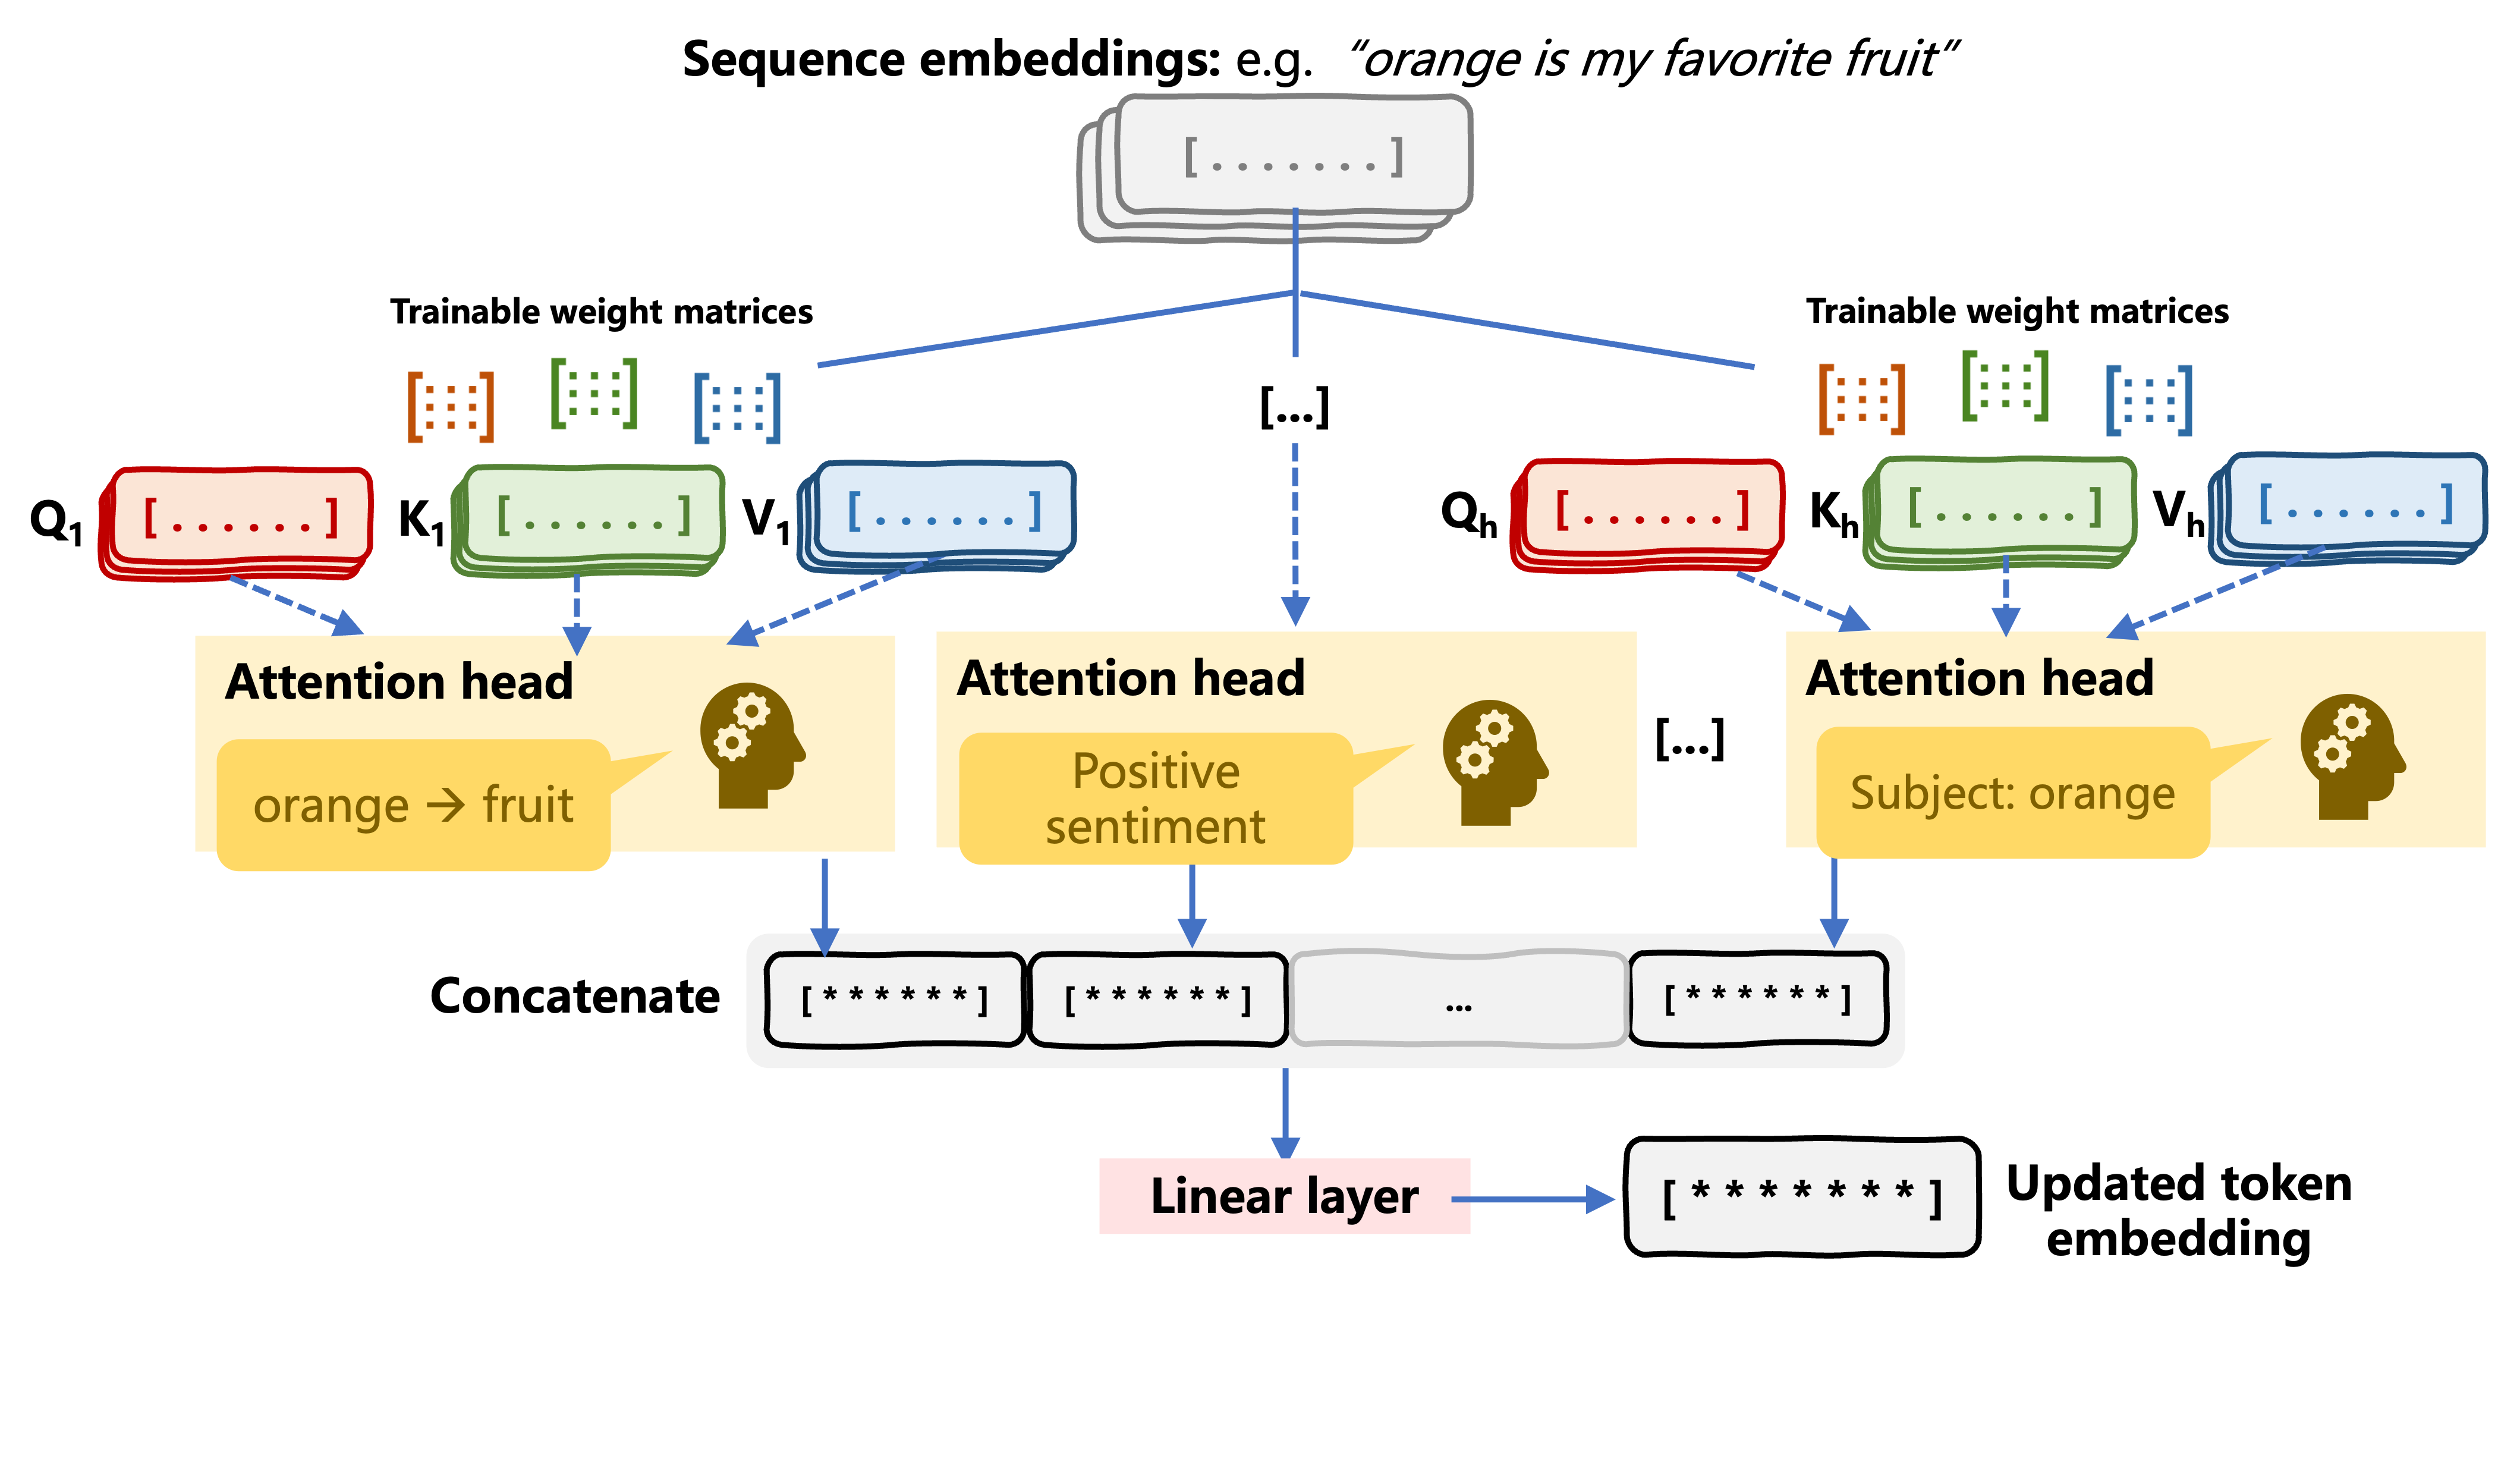
Autoatenção multi-head

Modelos Transformer com PyTorch

James Chapman

Curriculum Manager, DataCamp

Atenção multi-head em transformers
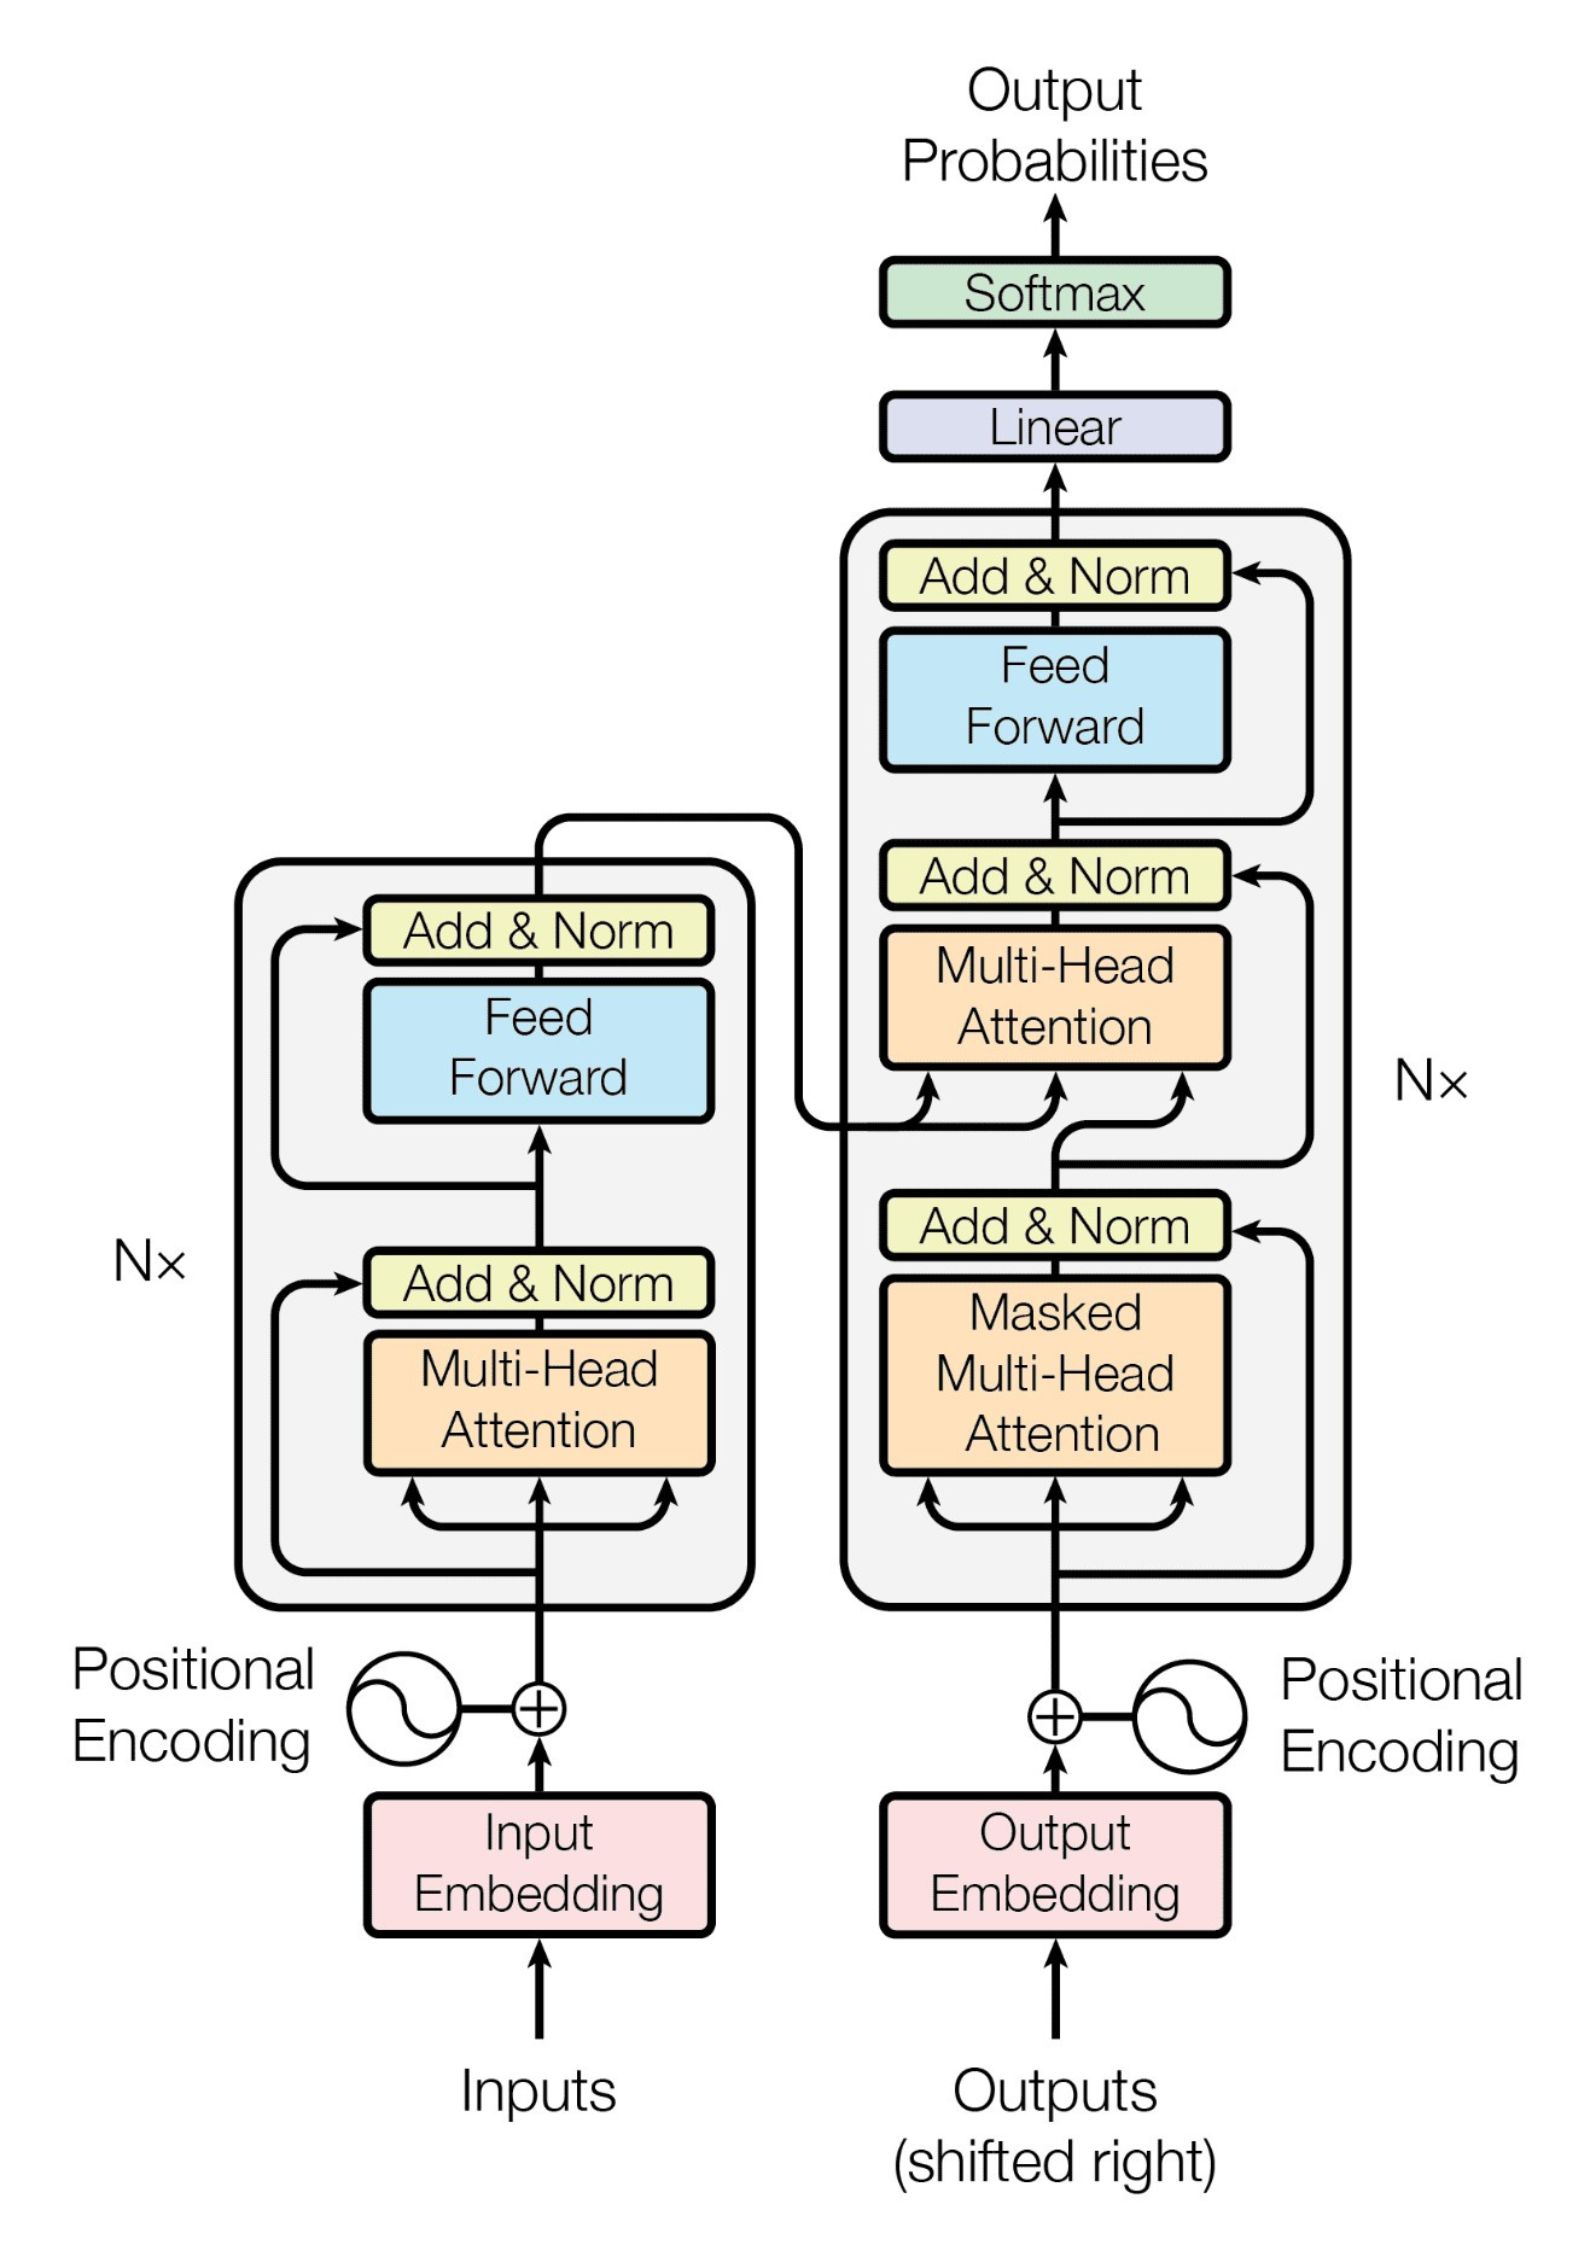
A arquitetura de transformers como mostrada no artigo acadêmico, Attention Is All You Need.

Modelos Transformer com PyTorch

Mecanismo de autoatenção

Anatomia do mecanismo de autoatenção

Modelos Transformer com PyTorch

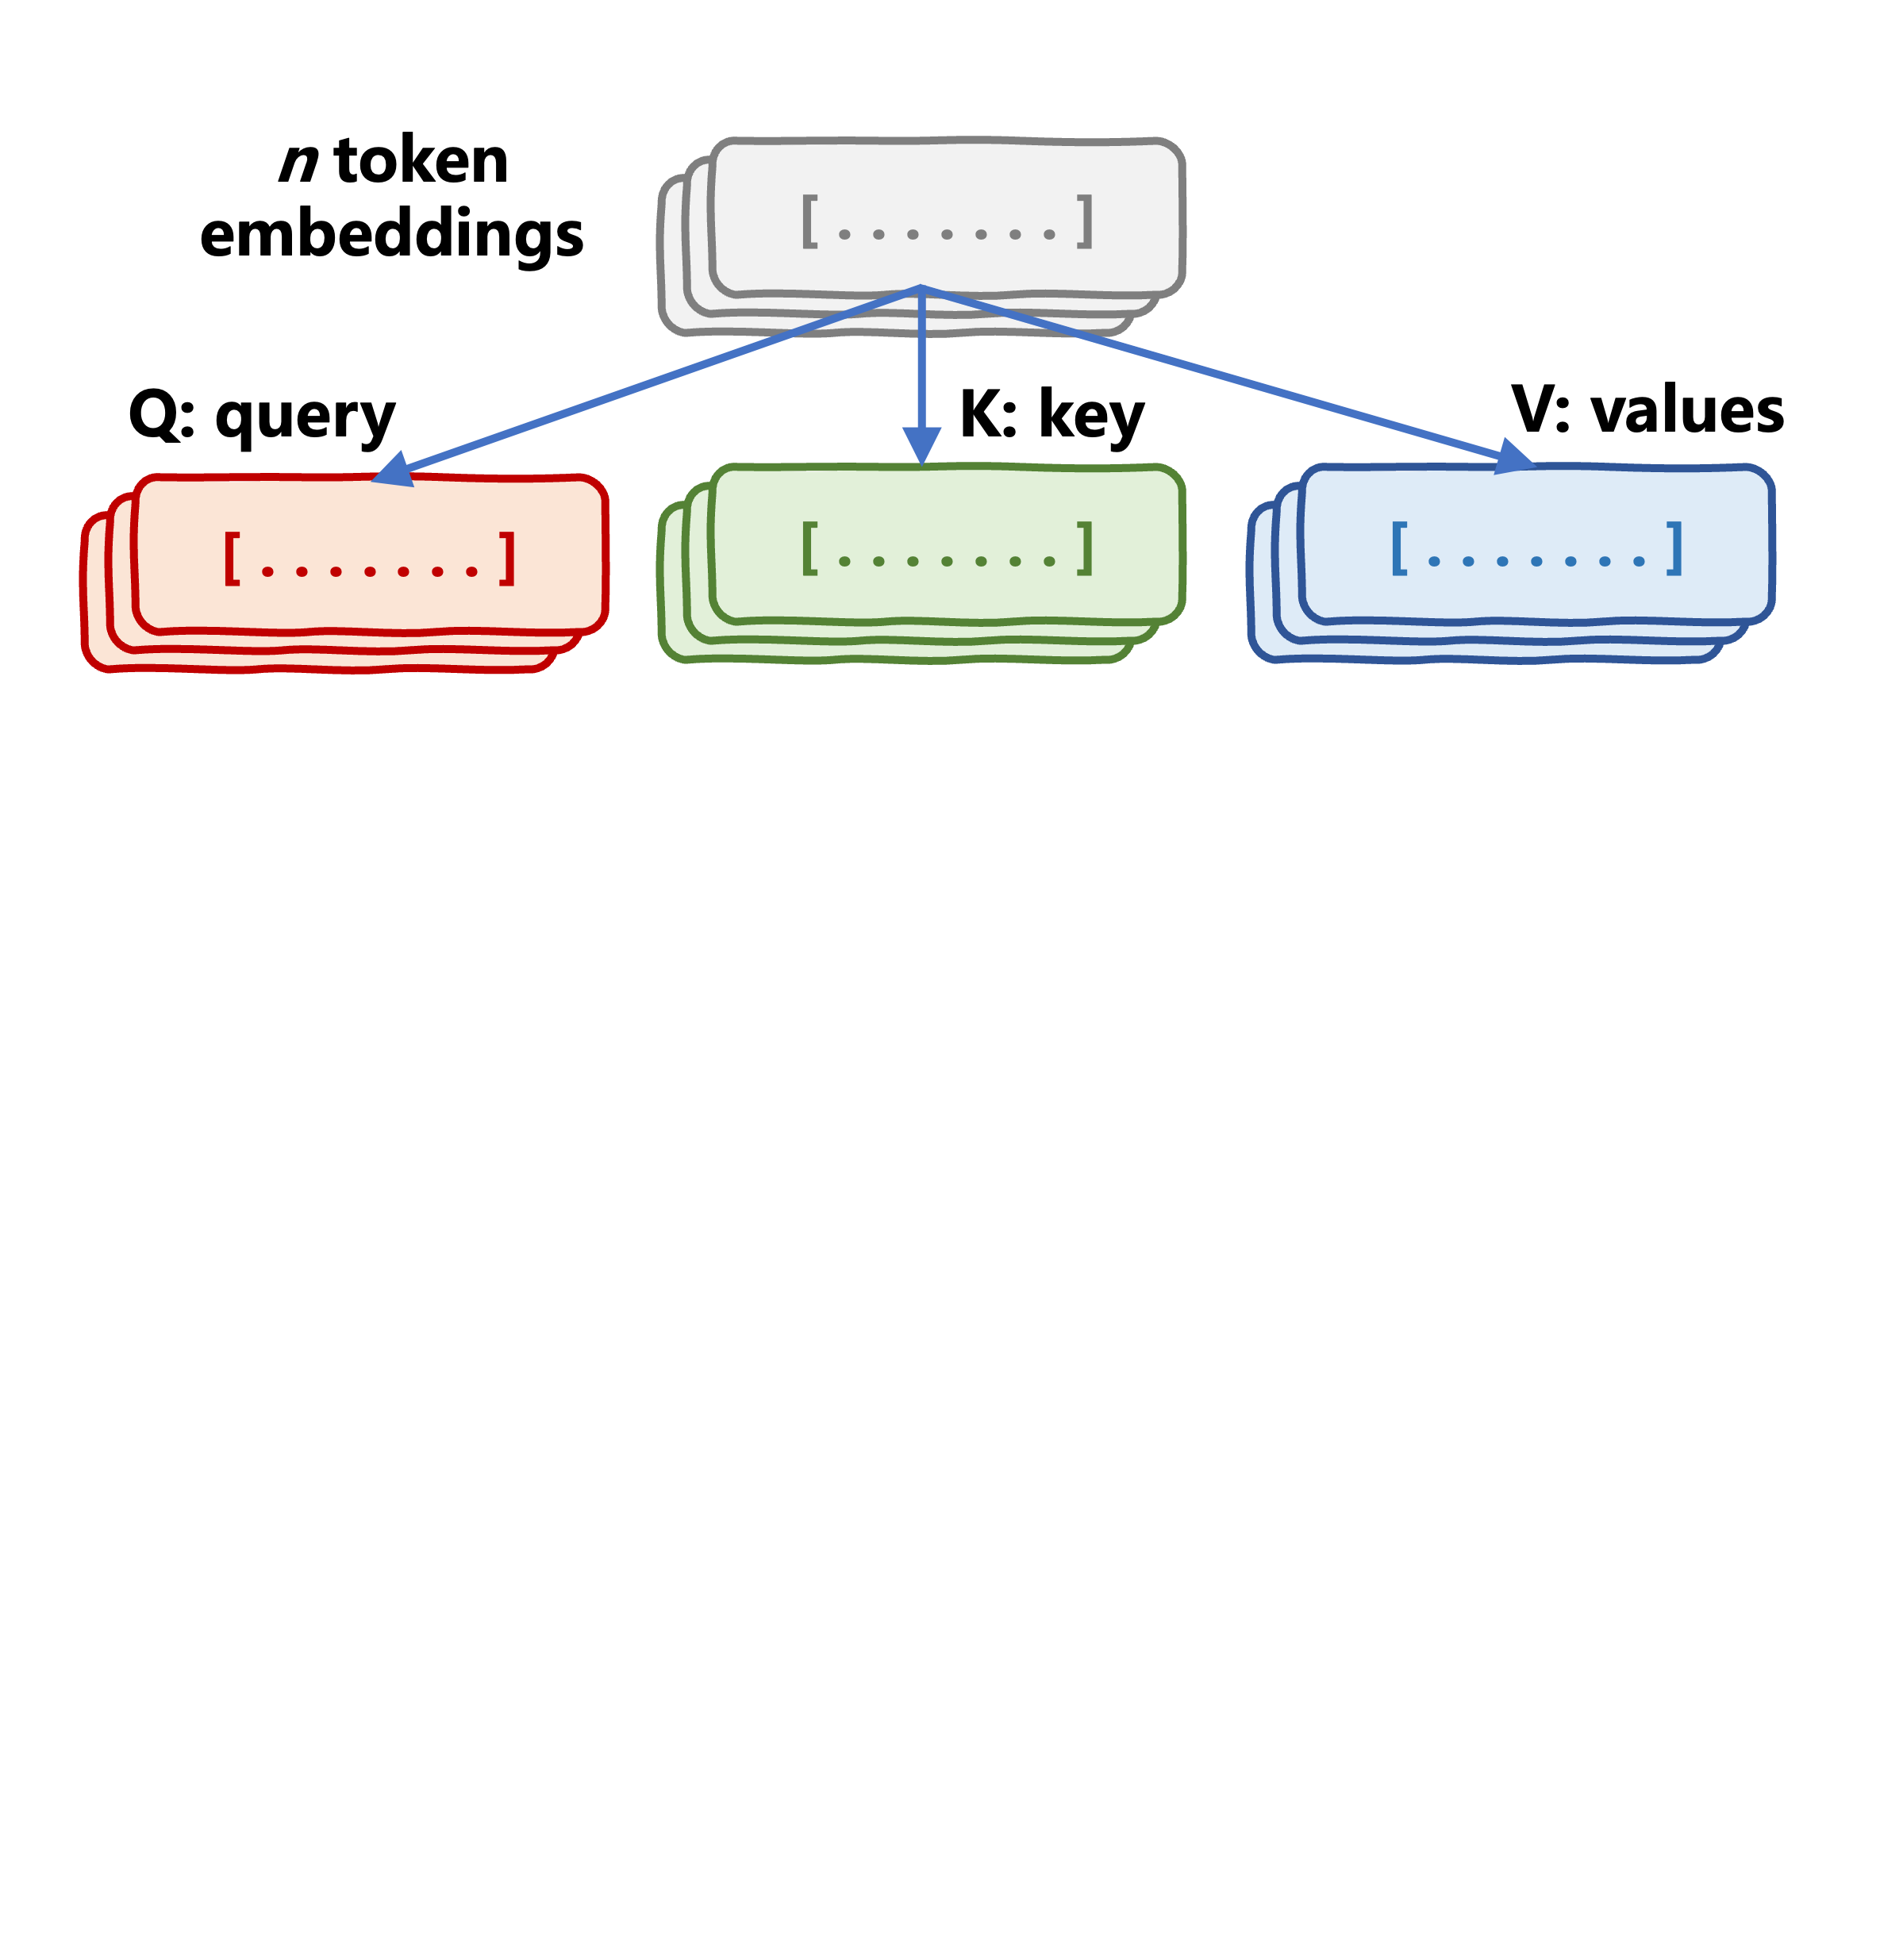
Mecanismo de autoatenção

Anatomia do mecanismo de autoatenção

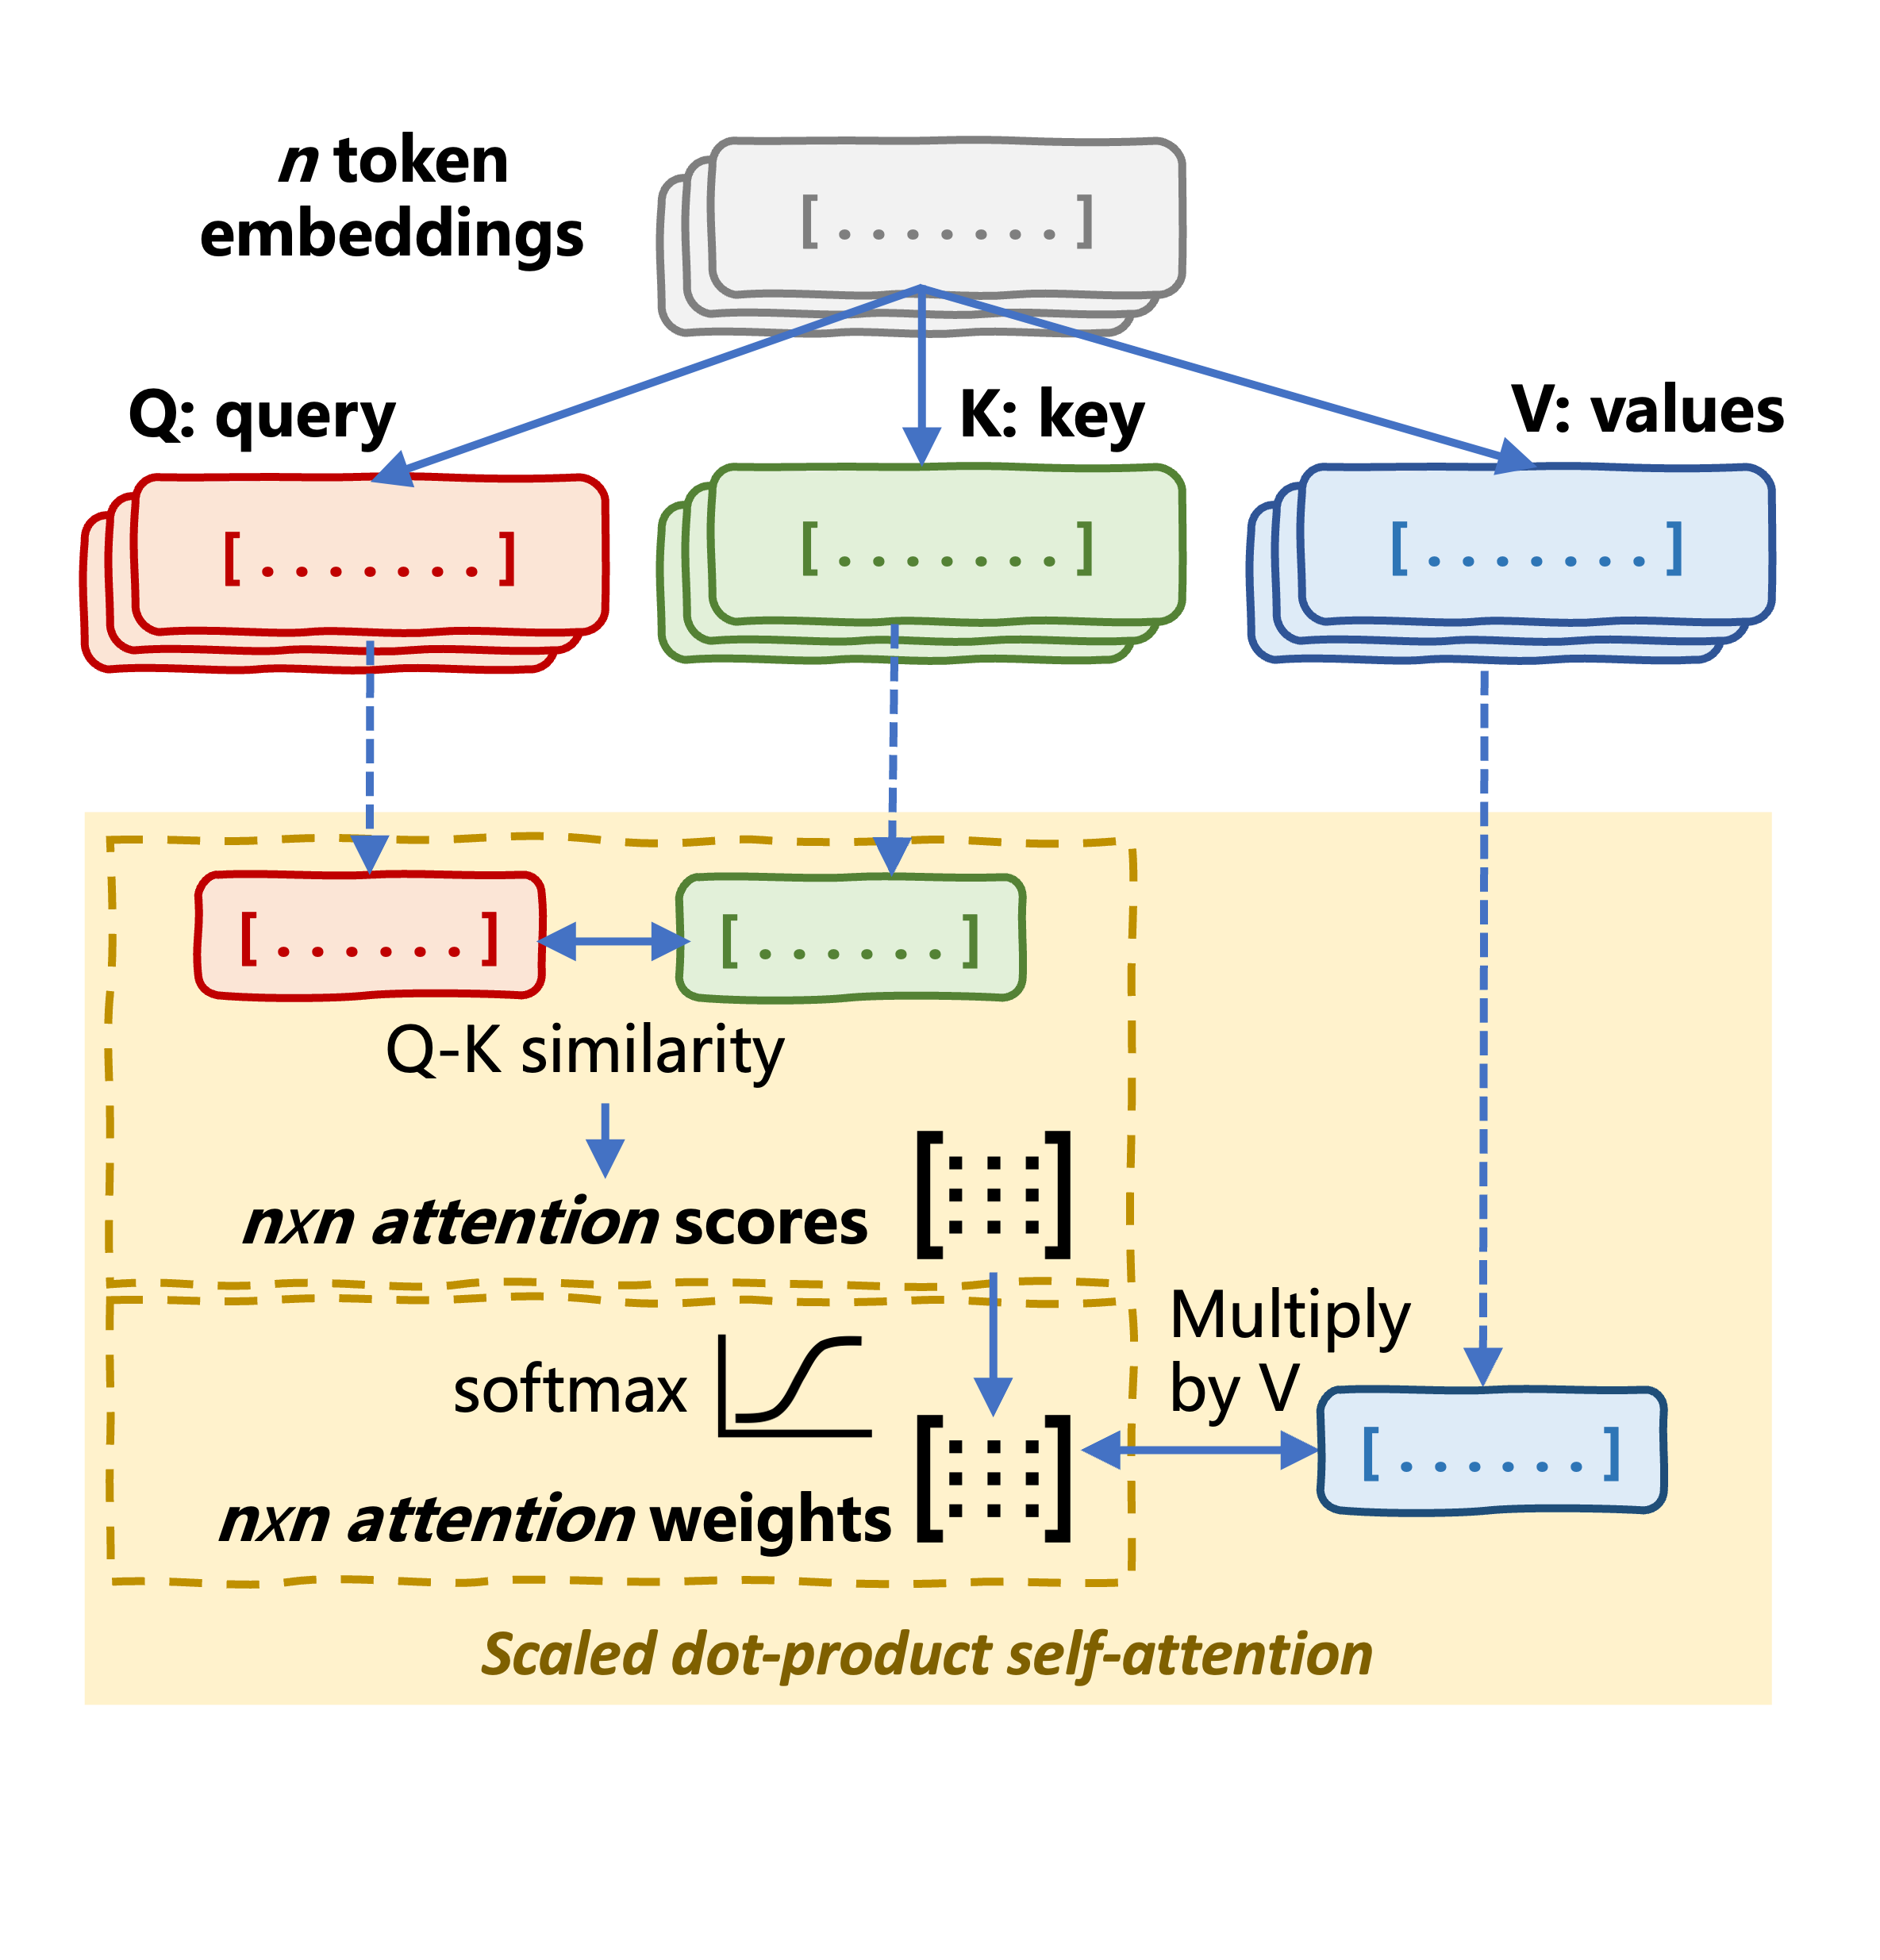
  • Q: Indica o que cada token está "procurando" nos outros tokens
  • K: Representa o conteúdo de cada token
  • V: Conteúdo a ser agregado ou ponderado
Modelos Transformer com PyTorch

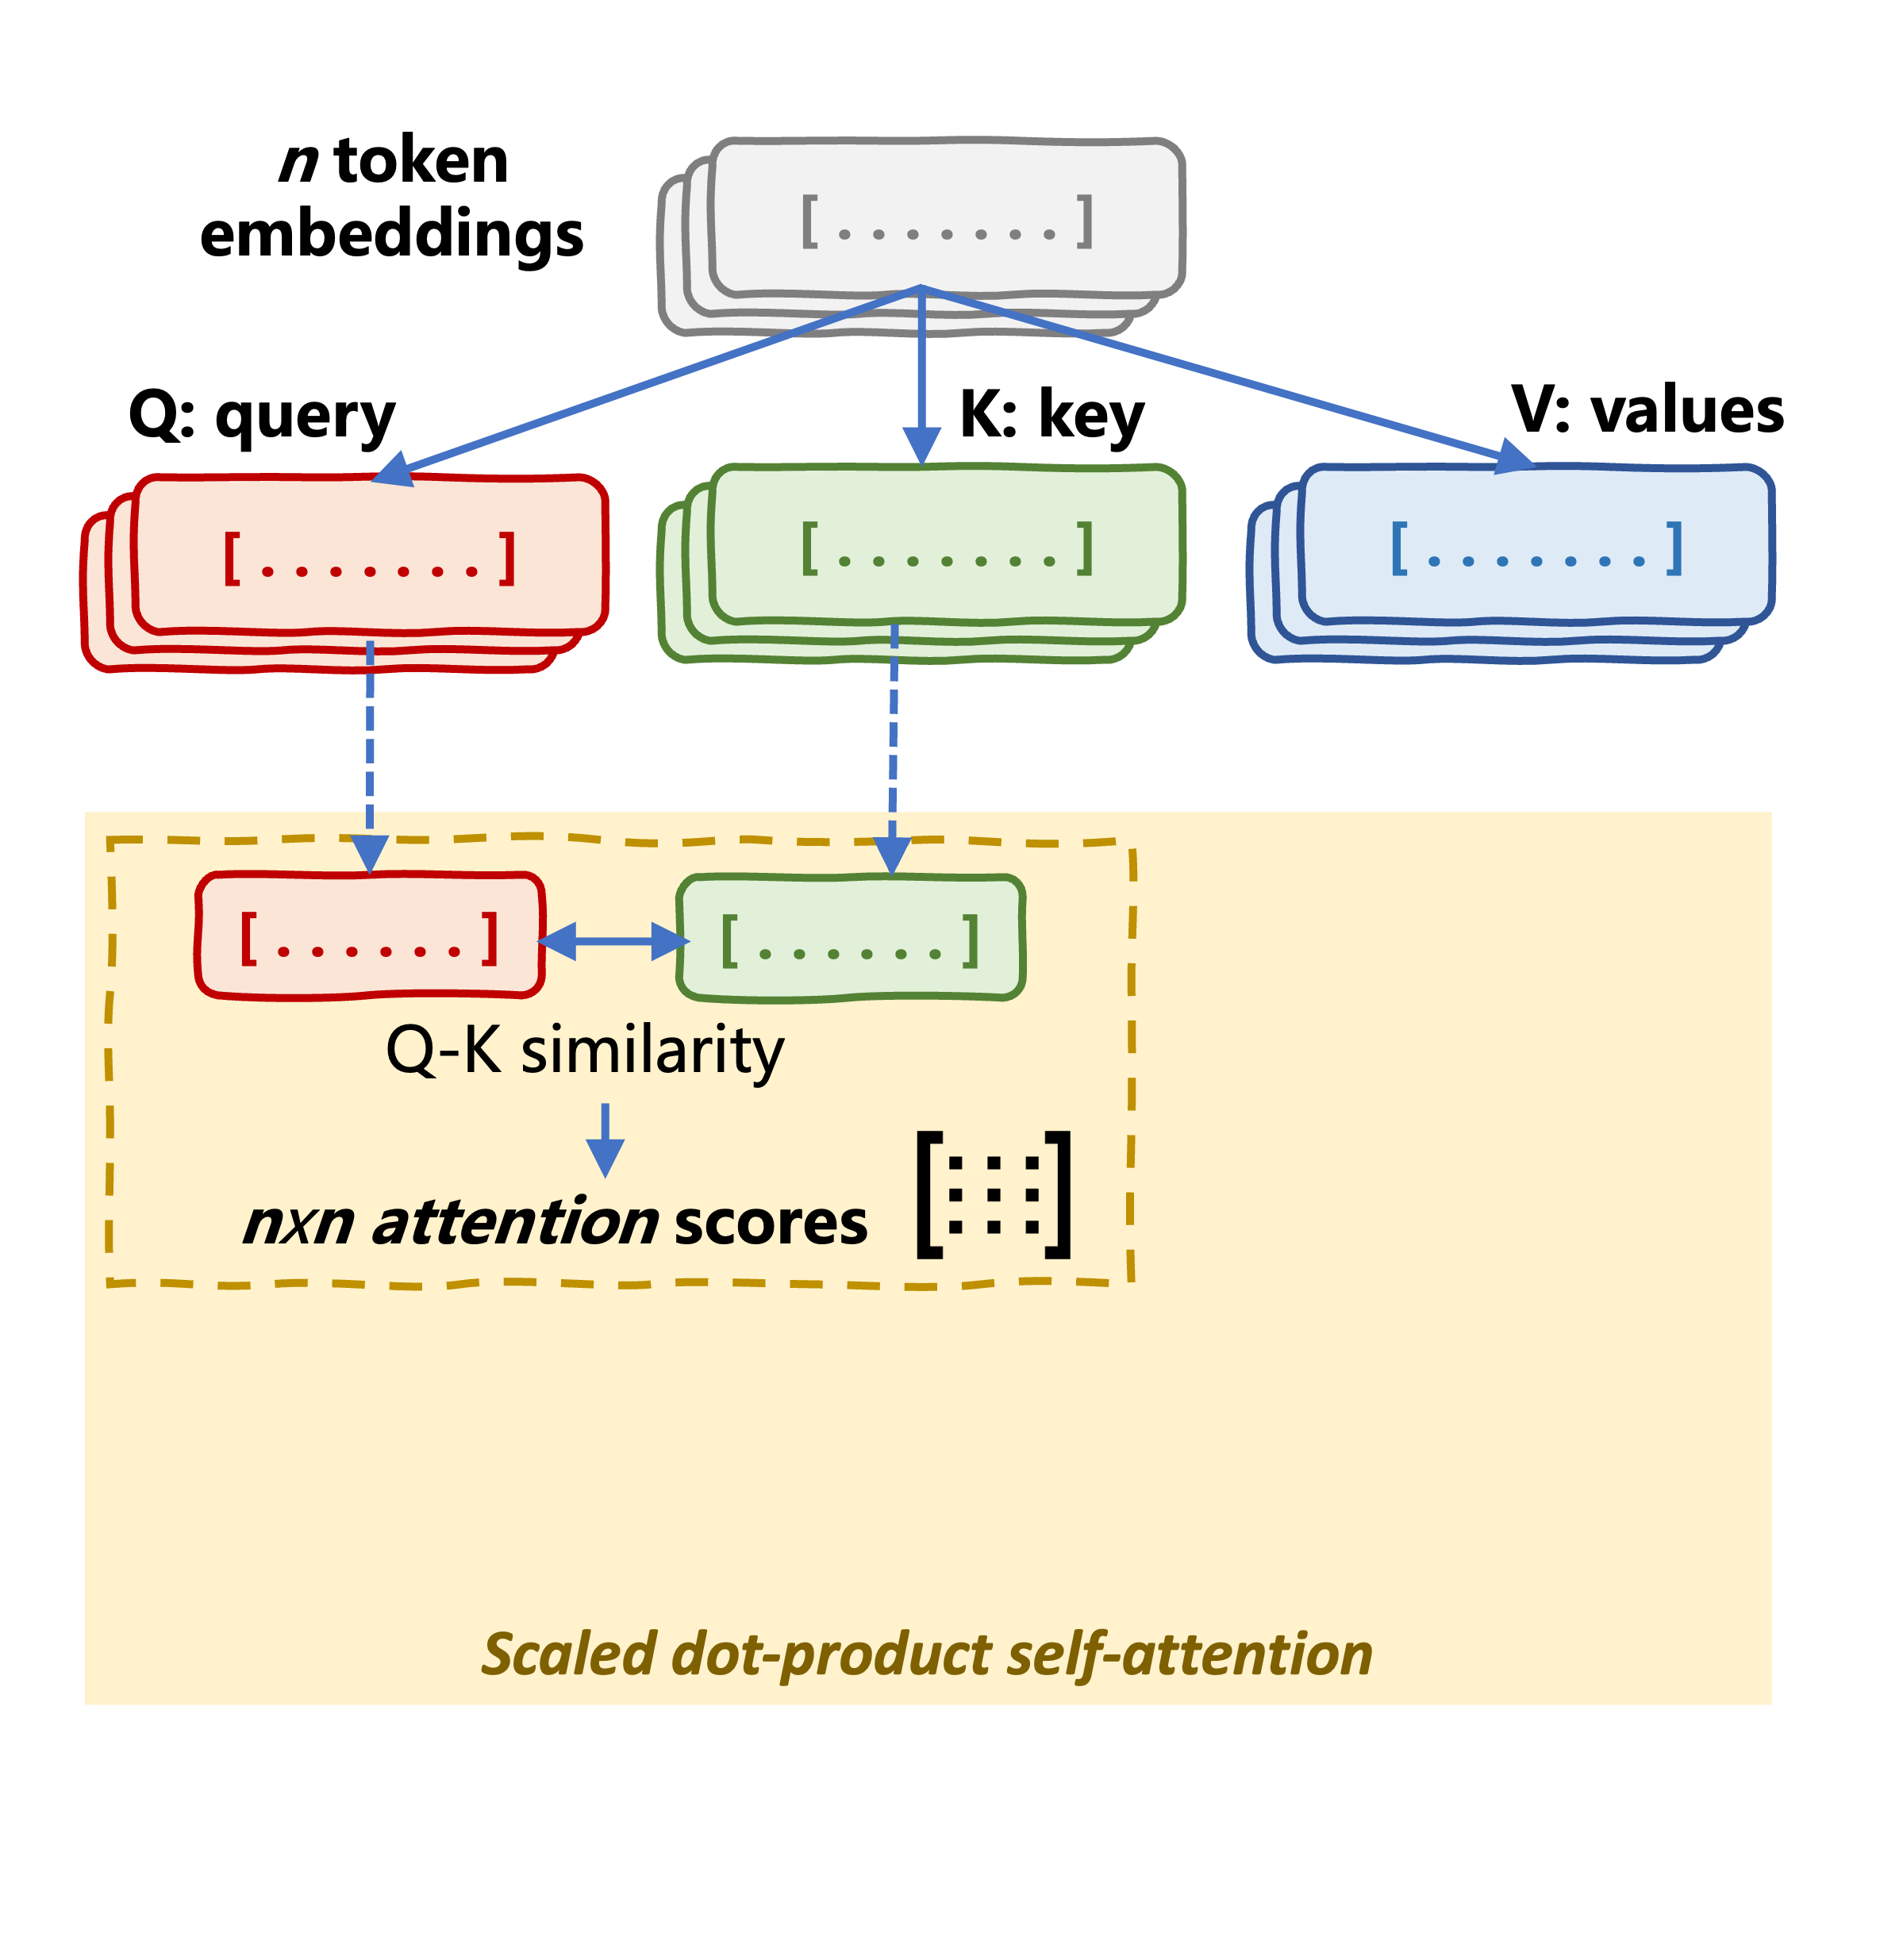
Mecanismo de autoatenção

Anatomia do mecanismo de autoatenção

  • Q: Indica o que cada token está "procurando" nos outros tokens
  • K: Representa o conteúdo de cada token
  • V: Conteúdo a ser agregado ou ponderado


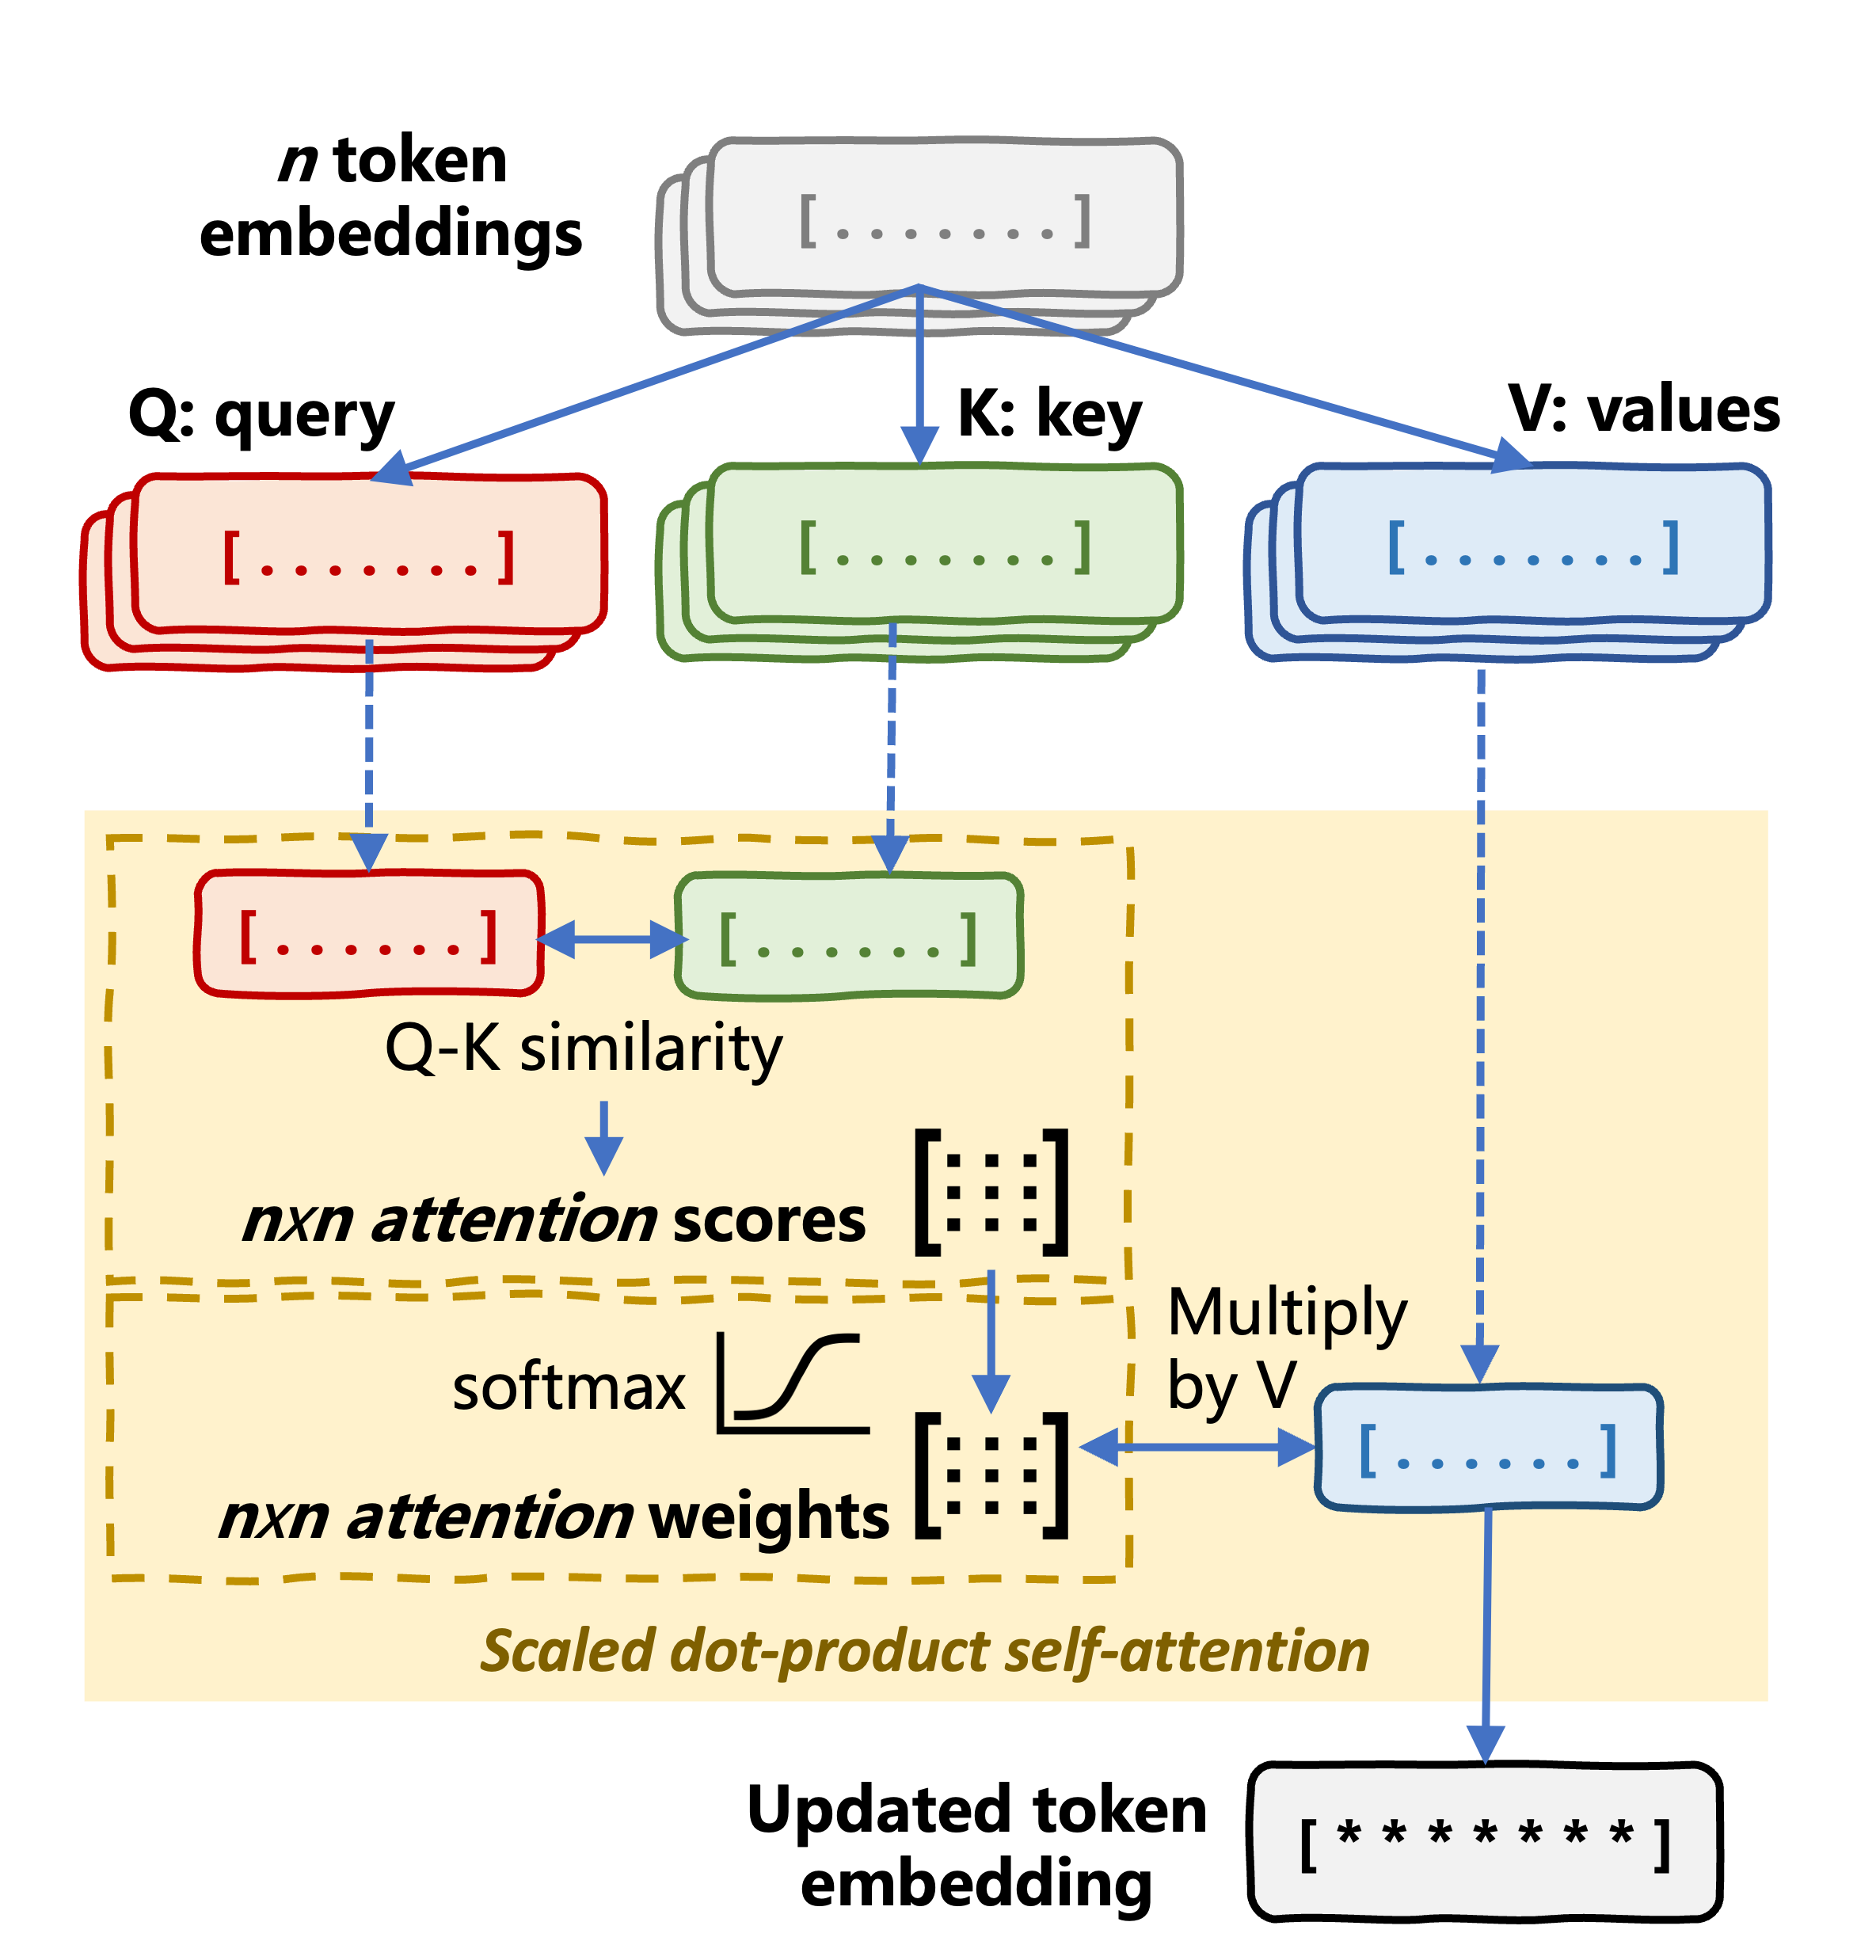
  • Attention Scores: similaridade Q-K → dot-product
Modelos Transformer com PyTorch

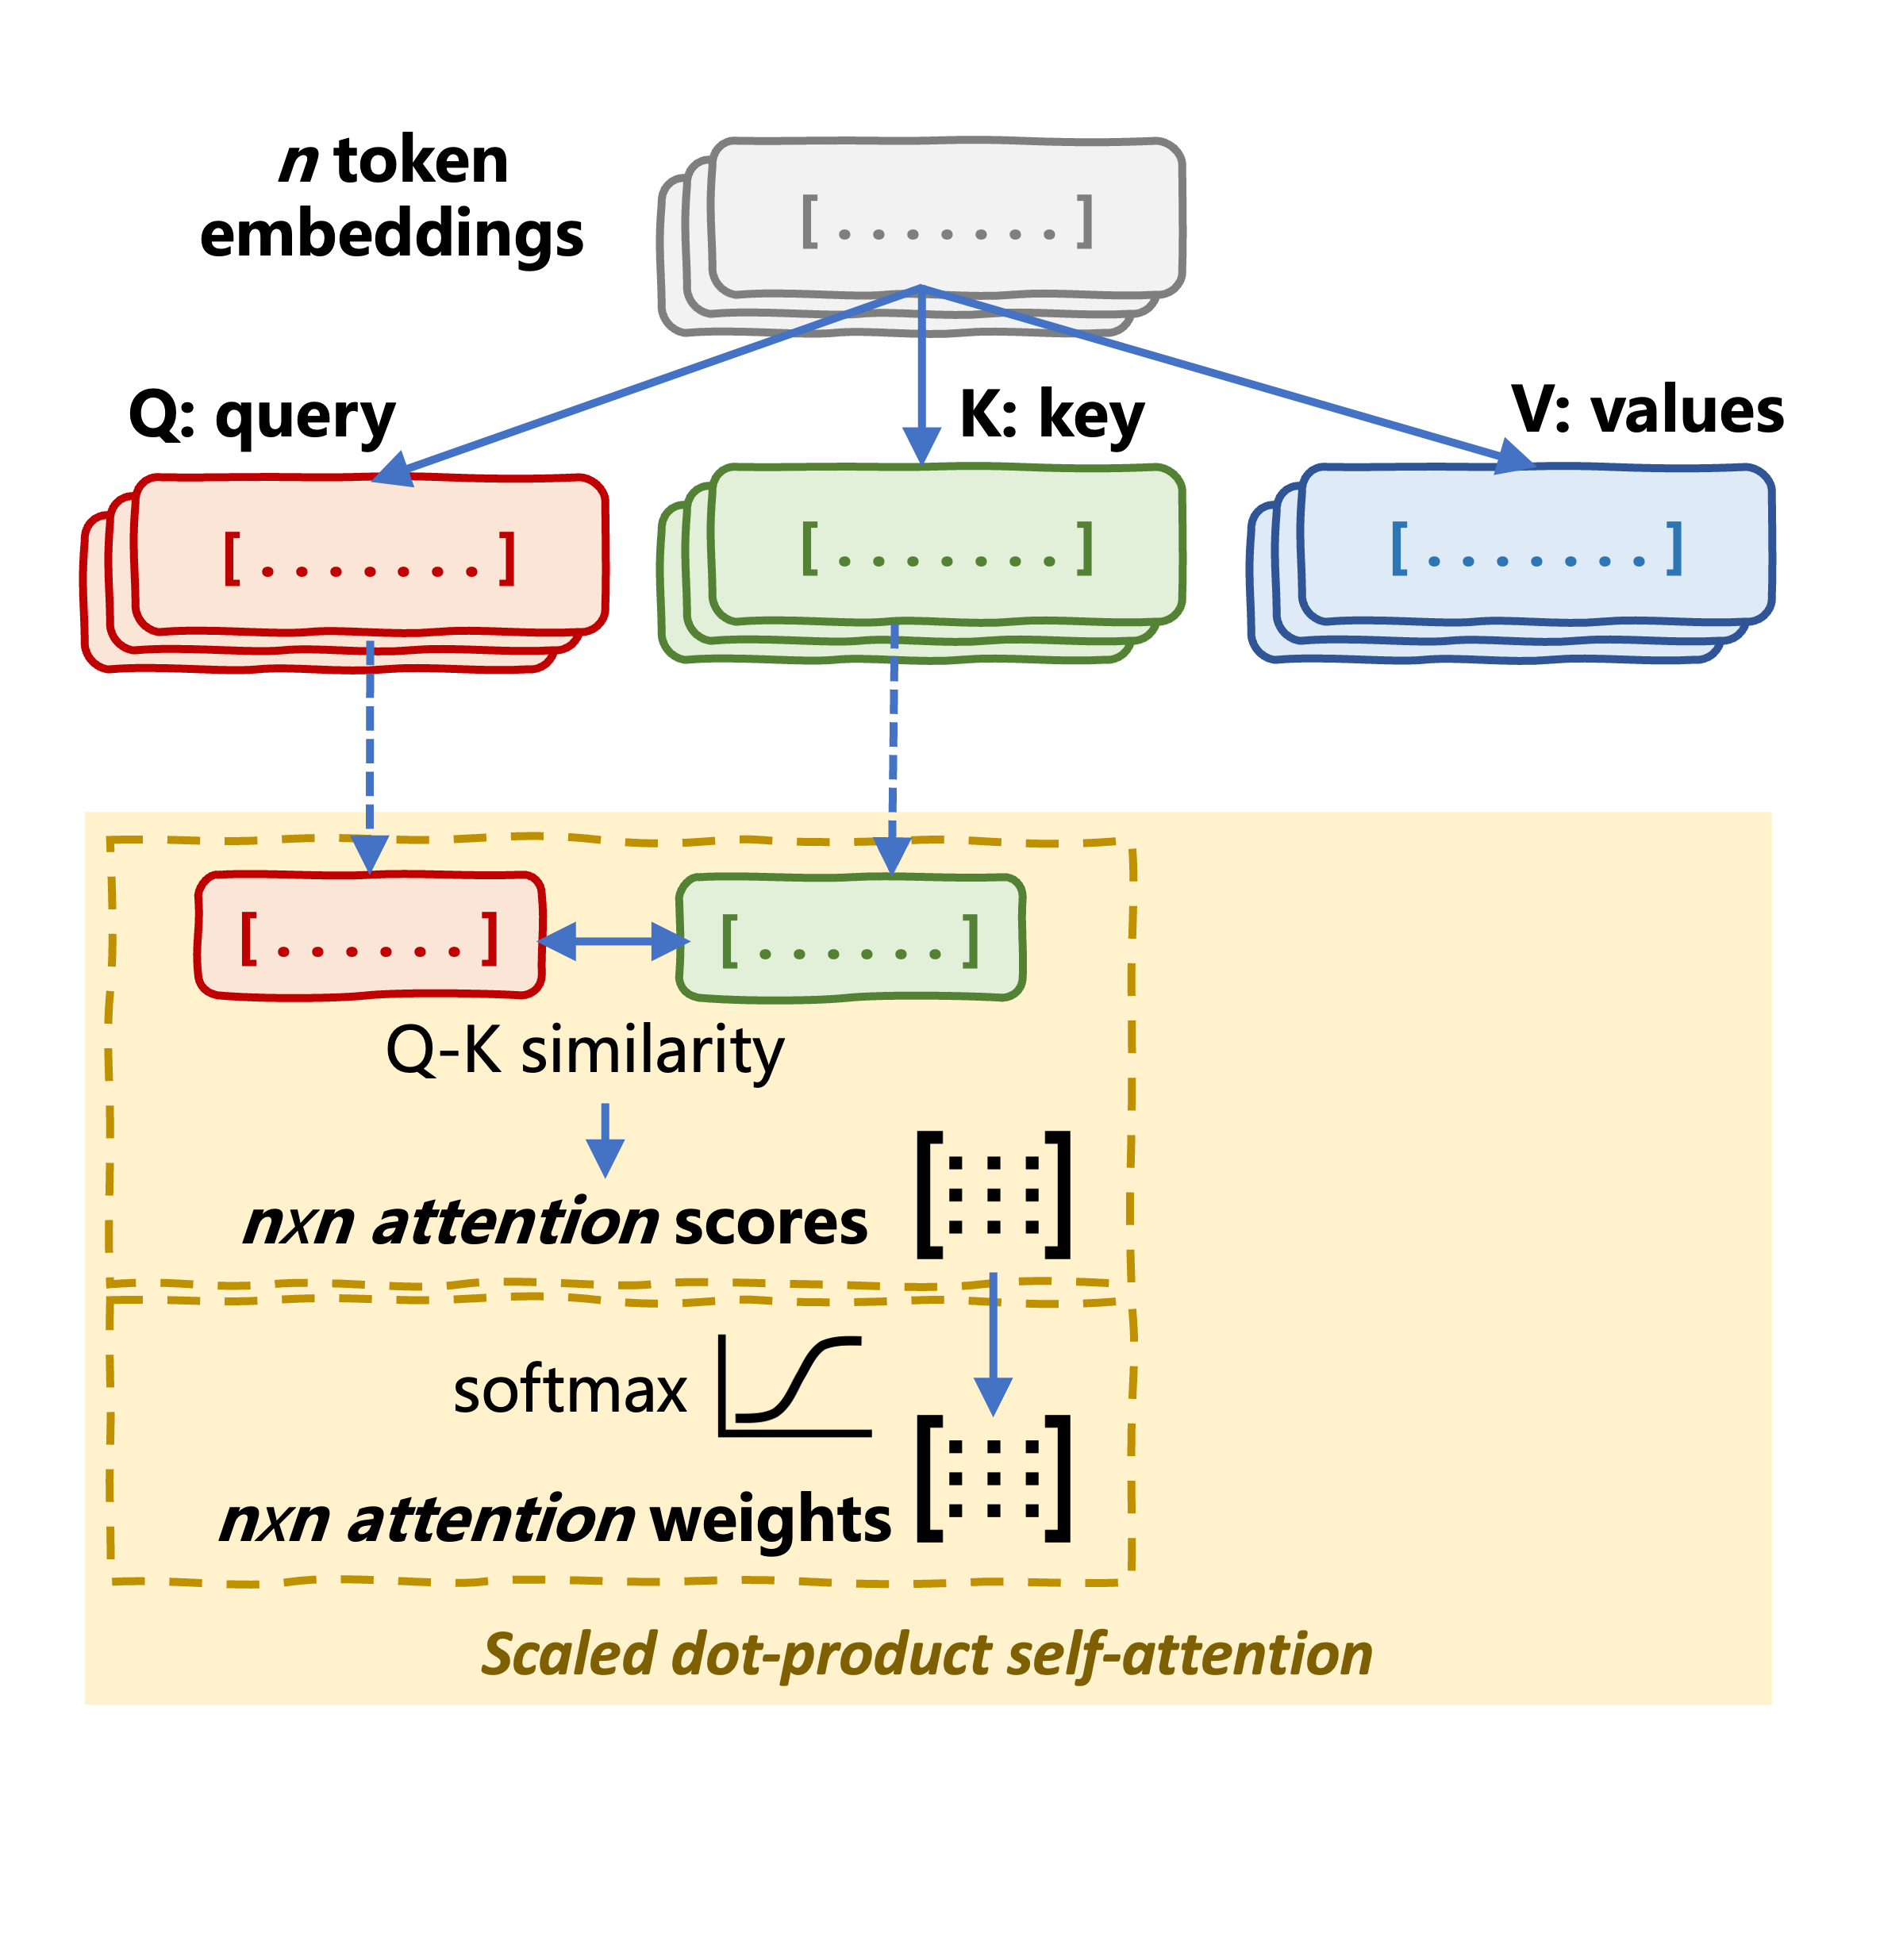
Mecanismo de autoatenção

Anatomia do mecanismo de autoatenção

  • Q: Indica o que cada token está "procurando" nos outros tokens
  • K: Representa o conteúdo de cada token
  • V: Conteúdo a ser agregado ou ponderado


  • Attention Scores: similaridade Q-K → dot-product
  • Attention Weights: escalonamento por softmax
Modelos Transformer com PyTorch

Mecanismo de autoatenção

Anatomia do mecanismo de autoatenção

  • Attention Scores: similaridade Q-K → dot-product
  • Attention Weights: escalonamento por softmax


Orange is my favorite fruit
Query: Orange
Attention weights: .21 .03 .05 .31 .40
Modelos Transformer com PyTorch

Mecanismo de autoatenção

Anatomia do mecanismo de autoatenção

  • Attention Scores: similaridade Q-K → dot-product
  • Attention Weights: escalonamento por softmax


Orange is my favorite fruit
Query: Orange
Attention weights: .21 .03 .05 .31 .40
Modelos Transformer com PyTorch

Mecanismo de autoatenção

Anatomia do mecanismo de autoatenção

  • Attention Scores: similaridade Q-K → dot-product
  • Attention Weights: escalonamento por softmax


Orange is my favorite fruit
Query: Orange
Attention weights: .21 .03 .05 .31 .40
Modelos Transformer com PyTorch

Atenção multi-head

Autoatenção multi-head

Modelos Transformer com PyTorch

Atenção multi-head

Autoatenção multi-head

Modelos Transformer com PyTorch

Atenção multi-head

Autoatenção multi-head

Modelos Transformer com PyTorch
import torch.nn as nn
import torch.nn.functional as F

class MultiHeadAttention(nn.Module):

def __init__(self, d_model, num_heads): super().__init__()
assert d_model % num_heads == 0, "d_model must be divisible by num_heads."
self.num_heads = num_heads self.d_model = d_model self.head_dim = d_model // num_heads
self.query_linear = nn.Linear(d_model, d_model, bias=False) self.key_linear = nn.Linear(d_model, d_model, bias=False) self.value_linear = nn.Linear(d_model, d_model, bias=False)
self.output_linear = nn.Linear(d_model, d_model)
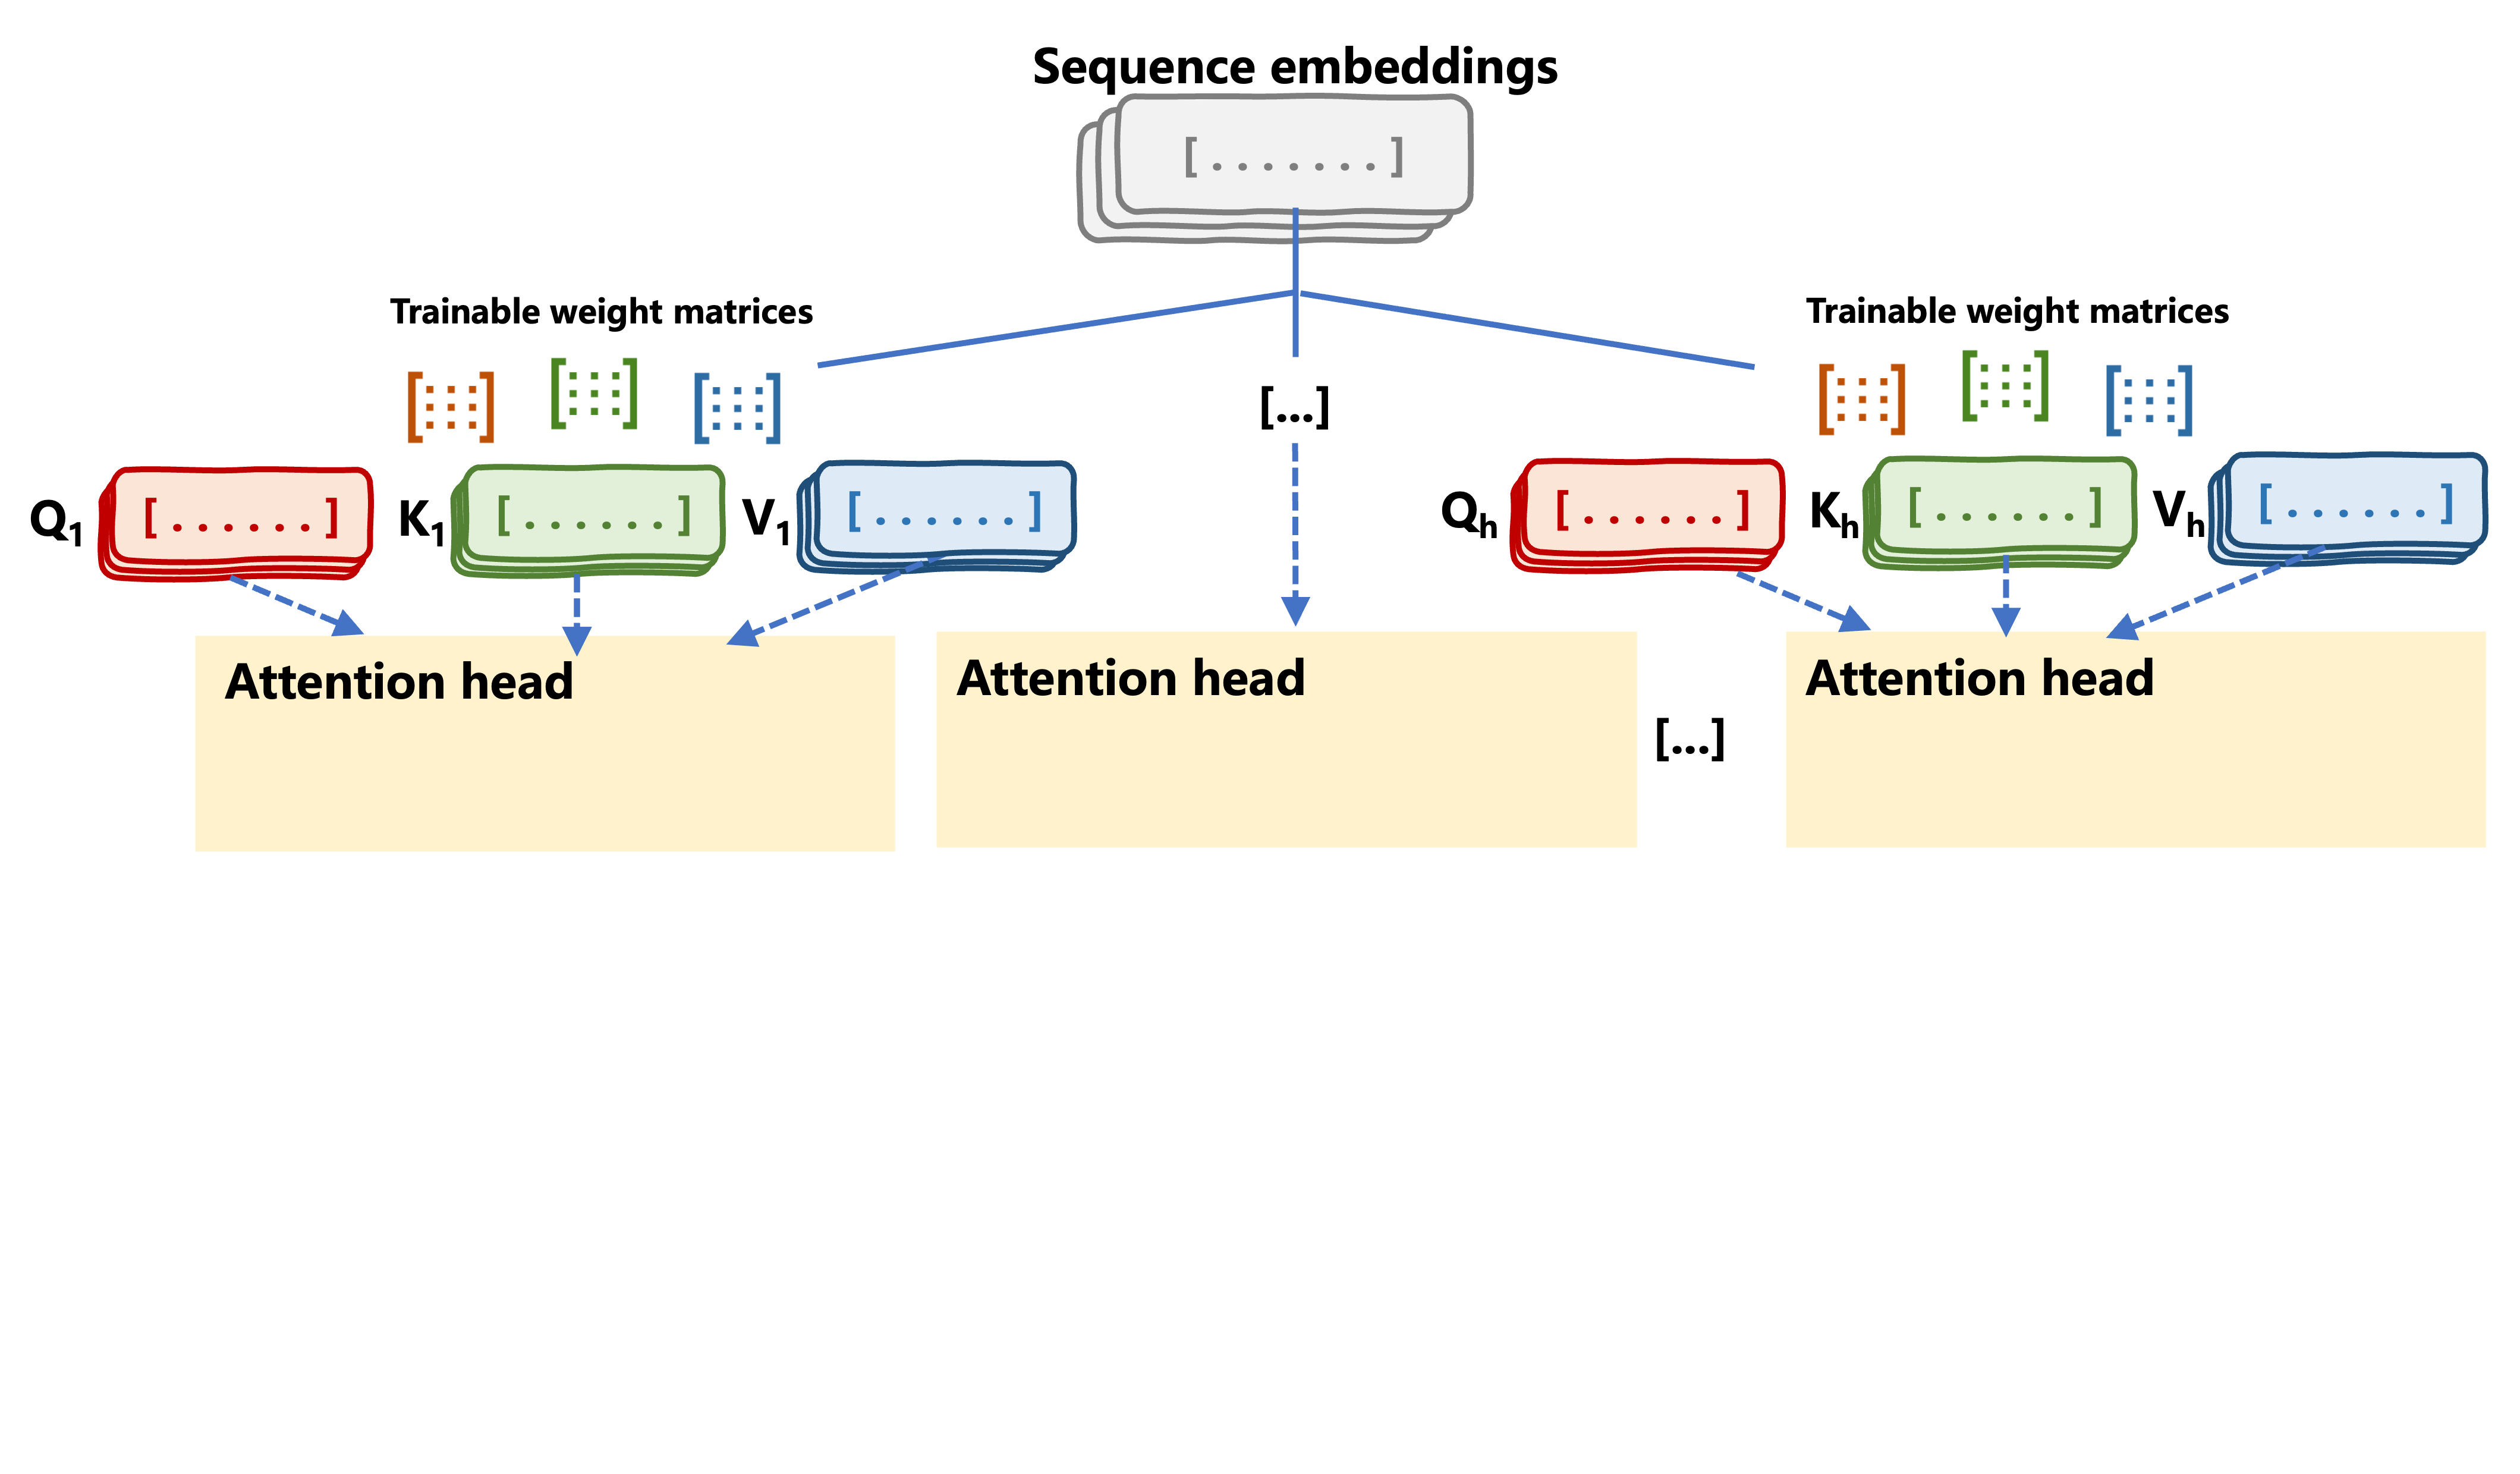
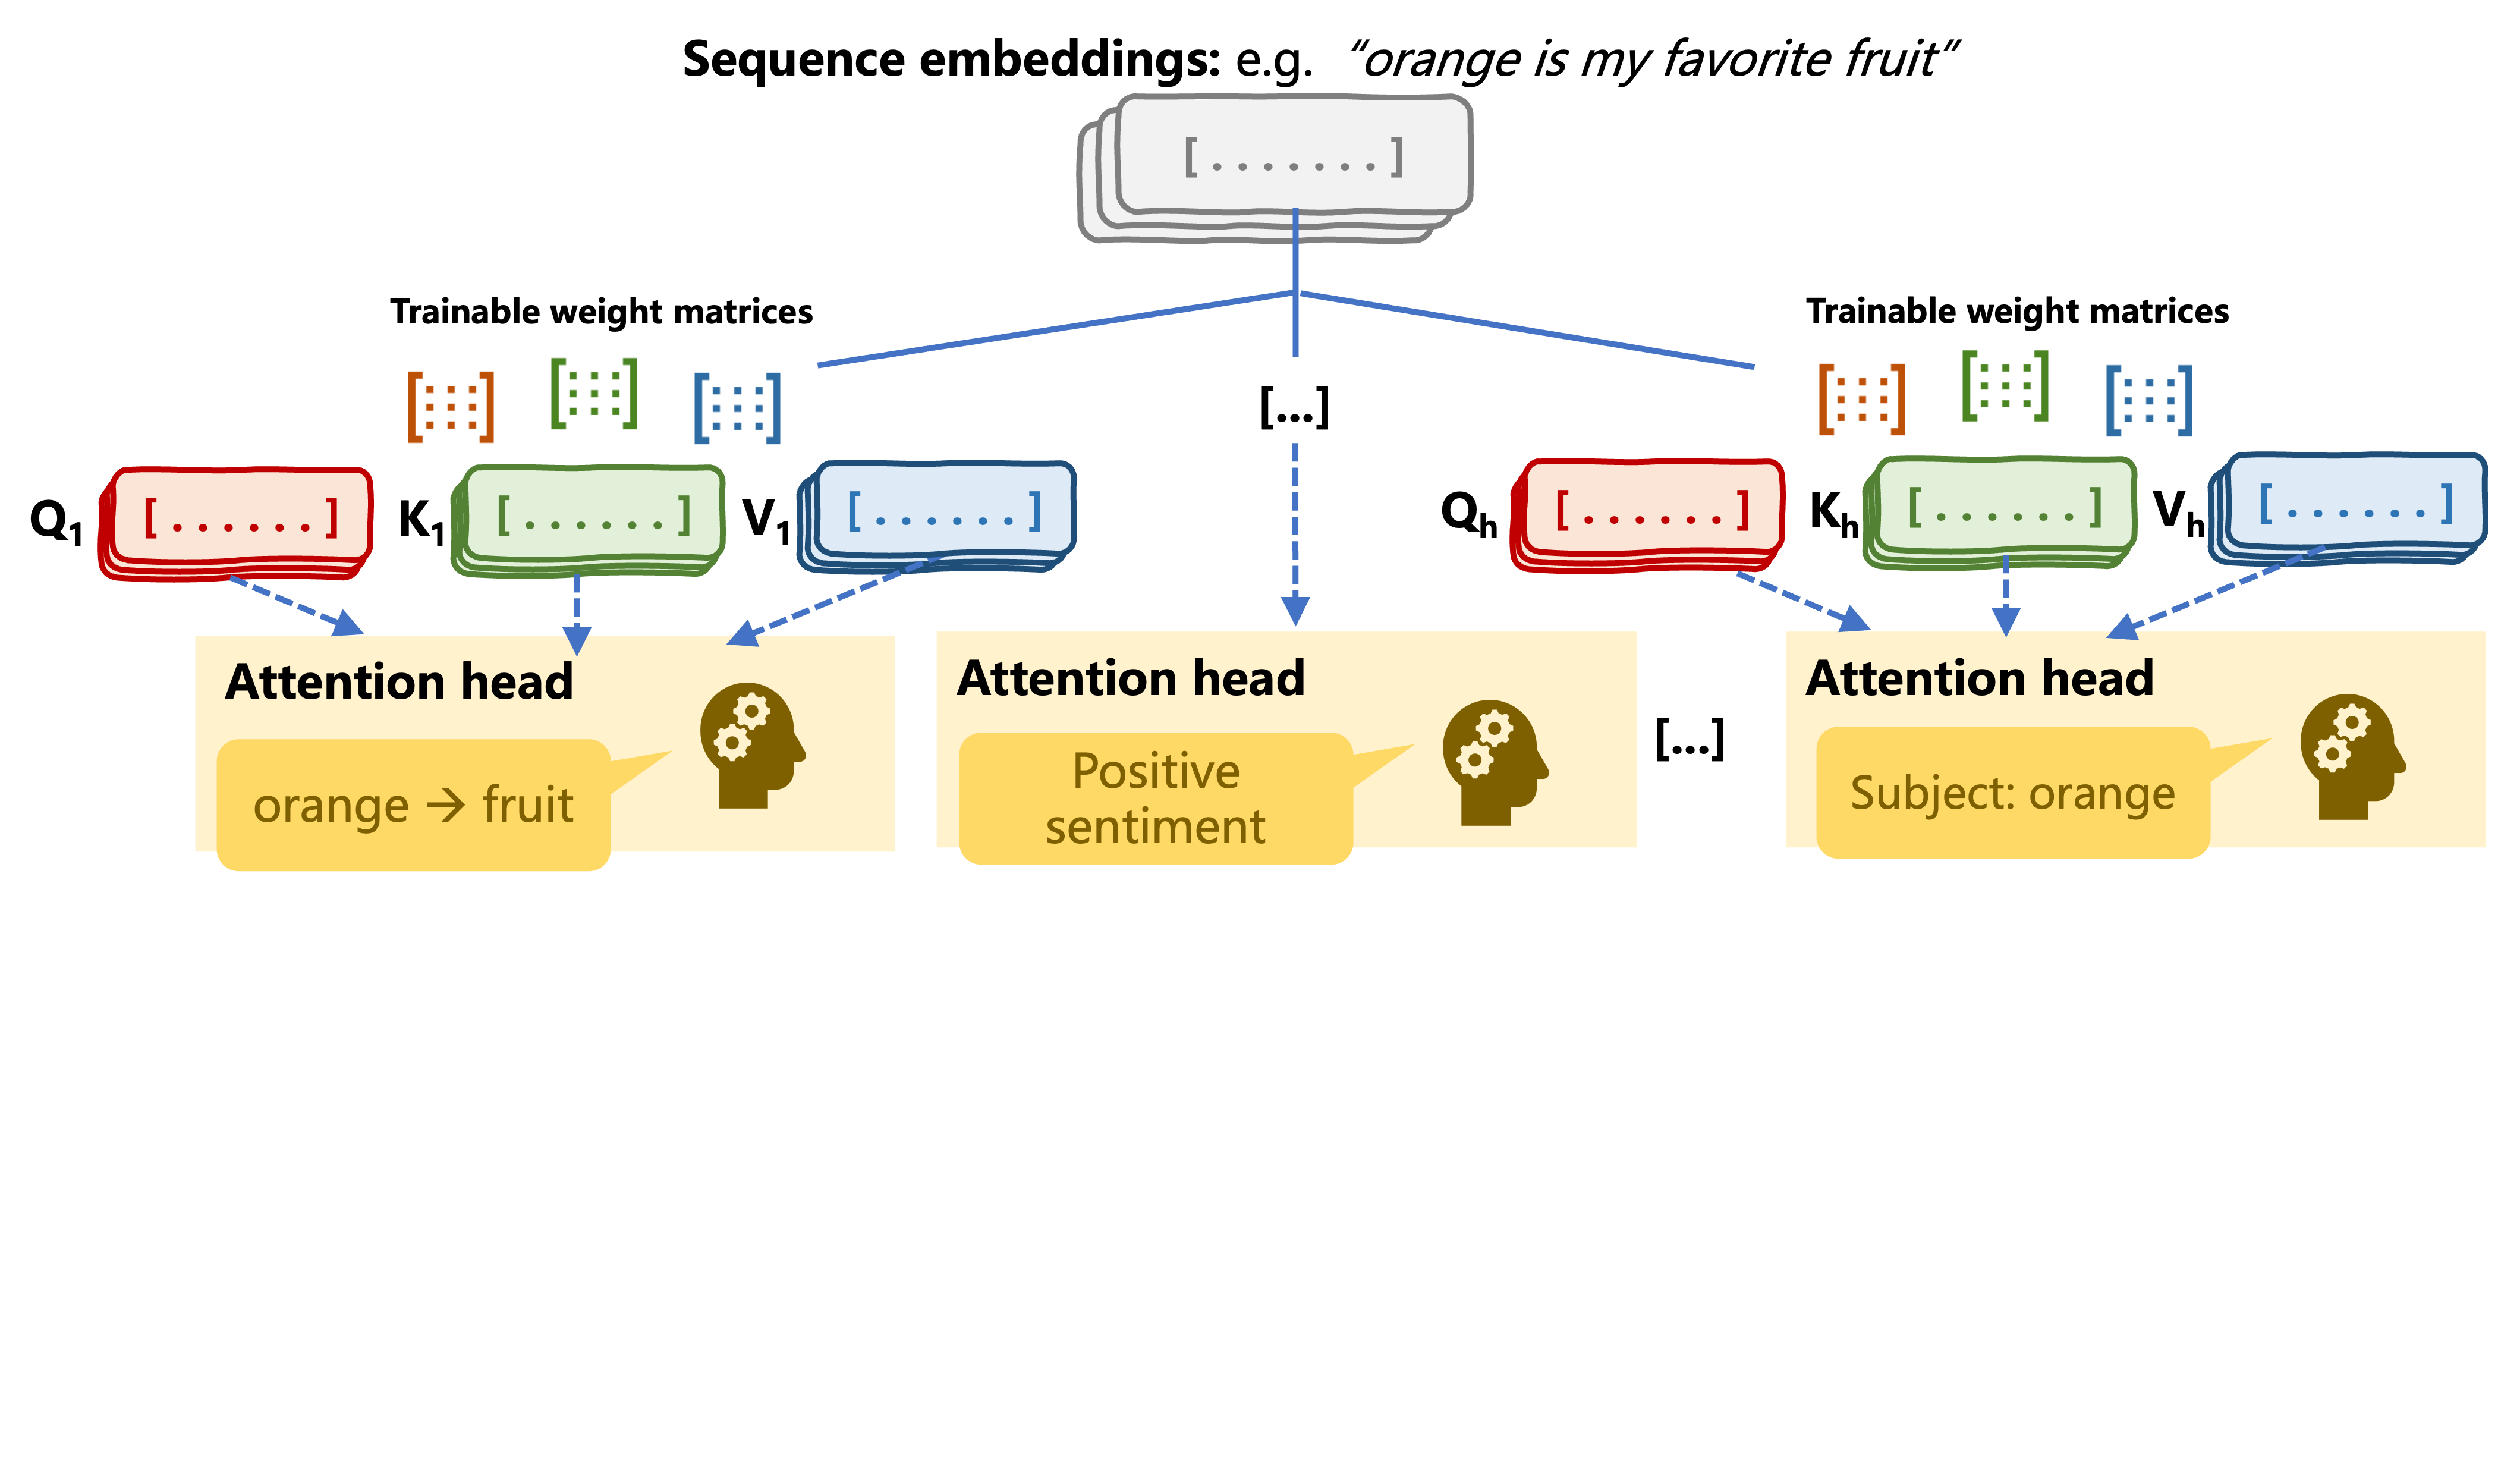
  • num_heads: nº de cabeças de atenção, cada uma trata embeddings de tamanho head_dim
  • bias=False: sem impacto no desempenho e reduz complexidade (apenas nas entradas)
Modelos Transformer com PyTorch
    def split_heads(self, x, batch_size):

seq_length = x.size(1) x = x.reshape(batch_size, seq_length, self.num_heads, self.head_dim) return x.permute(0, 2, 1, 3)
def compute_attention(self, query, key, value, mask=None):
scores = torch.matmul(query, key.transpose(-2, -1)) / (self.head_dim ** 0.5)
if mask is not None: scores = scores.masked_fill(mask == 0, float('-inf'))
attention_weights = F.softmax(scores, dim=-1) return torch.matmul(attention_weights, value)
def combine_heads(self, x, batch_size):
x = x.permute(0, 2, 1, 3).contiguous() return x.view(batch_size, -1, self.d_model)
  • compute_attention(): calcula pesos de atenção usando F.softmax()
  • torch.matmul(attention_weights, value): soma ponderada dos valores
Modelos Transformer com PyTorch
    def forward(self, query, key, value, mask=None):
        batch_size = query.size(0)

        query = self.split_heads(self.query_linear(query), batch_size)
        key = self.split_heads(self.key_linear(key), batch_size)
        value = self.split_heads(self.value_linear(value), batch_size)

        attention_weights = self.compute_attention(query, key, value, mask)


output = self.combine_heads(attention_weights, batch_size)
return self.output_linear(output)
  • self.output_linear(): concatena e projeta as saídas das cabeças
Modelos Transformer com PyTorch

Vamos praticar!

Modelos Transformer com PyTorch

Preparing Video For Download...