Comparando amostragens e distribuições bootstrap
Amostragem em R

Richie Cotton
Data Evangelist at DataCamp
Subconjunto focado em café
set.seed(19790801)
coffee_sample <- coffee_ratings %>%
  select(variety, country_of_origin, flavor) %>%
  rowid_to_column() %>%
  slice_sample(n = 500)
glimpse(coffee_sample)
Rows: 500
Columns: 4
$ rowid             <int> 10, 278, 458, 622, 131, 385, 1292, 47, 904, 1020, 5...
$ variety           <chr> "Other", "Bourbon", NA, "Caturra", "Caturra", "Yell...
$ country_of_origin <chr> "Ethiopia", "Guatemala", "Colombia", "Thailand", "C...
$ flavor            <dbl> 8.58, 7.75, 7.75, 7.50, 8.00, 7.83, 7.17, 8.08, 7.3...
Bootstrap das médias de sabor do café
mean_flavors_1000 <- replicate(
  n = 1000,
  expr = coffee_sample %>%
    slice_sample(prop = 1, replace = TRUE) %>%
    summarize(mean_flavor = mean(flavor, na.rm = TRUE)) %>%
    pull(mean_flavor)
)
bootstrap_distn <- tibble(
  resample_mean = mean_flavors_1000
)
Distribuição bootstrap da média de sabor
 ggplot(bootstrap_distn, aes(resample_mean)) +
  geom_histogram(binwidth = 0.0025)
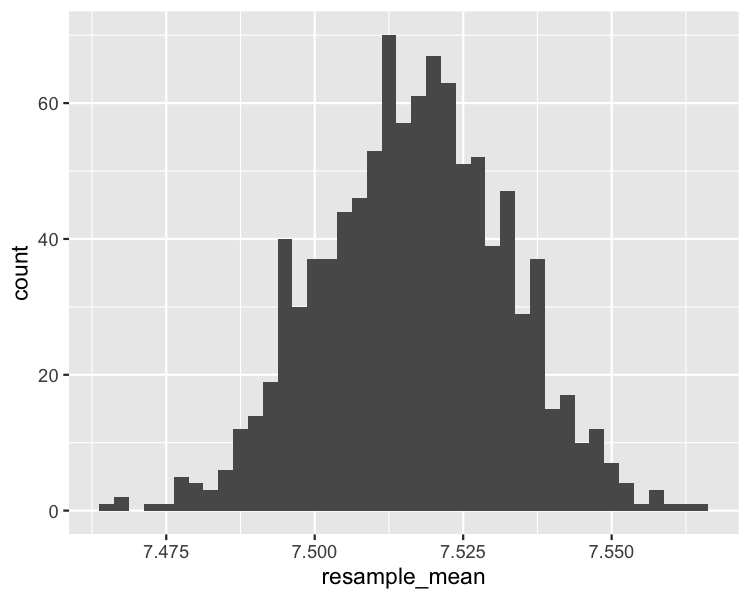
Médias: amostra, distribuição bootstrap, população
Média da amostra
coffee_sample %>%
  summarize(mean_flavor = mean(flavor)) %>%
  pull(mean_flavor)
7.5163
Média populacional estimada
bootstrap_distn %>%
  summarize(mean_mean_flavor = mean(resample_mean)) %>%
  pull(mean_mean_flavor)
7.5167
Média populacional verdadeira
coffee_ratings %>%
  summarize(mean_flavor = mean(flavor)) %>%
  pull(mean_flavor)
7.5260
Interpretando as médias
- A média da distribuição bootstrap geralmente é quase idêntica à média da amostra.
- Ela pode não ser uma boa estimativa da média populacional.
- O bootstrap não corrige vieses por diferenças entre sua amostra e a população.
DP da amostra vs DP da distribuição bootstrap
Desvio padrão da amostra
coffee_focus %>%
  summarize(sd_flavor = sd(flavor)) %>%
  pull(sd_flavor)
0.3525
Desvio padrão populacional estimado?
bootstrap_distn %>%
  summarize(sd_mean_flavor = sd(resample_mean)) %>%
  pull(sd_mean_flavor)
0.01572
DPs: amostra, dist. bootstrap e população
Desvio padrão da amostra
coffee_focus %>%
  summarize(sd_flavor = sd(flavor)) %>%
  pull(sd_flavor)
0.3525
Desvio padrão populacional estimado
standard_error <- bootstrap_distn %>%
  summarize(sd_mean_flavor = sd(resample_mean)) %>%
  pull(sd_mean_flavor)
standard_error * sqrt(500)
0.3515
Desvio padrão verdadeiro
coffee_ratings %>%
  summarize(sd_flavor = sd(flavor)) %>%
  pull(sd_flavor)
0.3414
Erro padrão é o desvio padrão da estatística de interesse.
Erro padrão vezes a raiz quadrada do tamanho da amostra estima o desvio padrão populacional.
Interpretando os erros padrão
- O erro padrão estimado é o desvio padrão da distribuição bootstrap para uma estatística da amostra.
- O erro padrão da distribuição bootstrap vezes a raiz quadrada do tamanho da amostra estima o desvio padrão na população.
Vamos praticar!
Amostragem em R

