Ajuste de Hiperparâmetros em Python
Alex Scriven
Data Scientist
Por que fazer este curso?
Você pode se surpreender com o que há por baixo do capô!
O conjunto de dados trata de inadimplência em cartão de crédito.
Contém variáveis da história financeira de consumidores em Taiwan. São 30.000 usuários e 24 atributos.
Nosso alvo é se houve inadimplência no empréstimo
Já foi pré-processado e, às vezes, usaremos amostras menores para demonstrar um conceito
Mais informações sobre o conjunto de dados estão aqui:
https://archive.ics.uci.edu/ml/datasets/default+of+credit+card+clients
O que é um parâmetro?
Um modelo simples de regressão logística:
log_reg_clf = LogisticRegression() log_reg_clf.fit(X_train, y_train)print(log_reg_clf.coef_)
array([[-2.88651273e-06, -8.23168511e-03, 7.50857018e-04,
3.94375060e-04, 3.79423562e-04, 4.34612046e-04,
4.37561467e-04, 4.12107102e-04, -6.41089138e-06,
-4.39364494e-06, cont... ]])
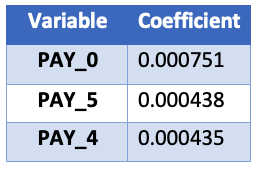
Organize os coeficientes:
# Get the original variable names original_variables = list(X_train.columns)# Zip together the names and coefficients zipped_together = list(zip(original_variables, log_reg_clf.coef_[0])) coefs = [list(x) for x in zipped_together]# Put into a DataFrame with column labels coefs = pd.DataFrame(coefs, columns=["Variable", "Coefficient"])
Agora ordene e imprima os três maiores coeficientes
coefs.sort_values(by=["Coefficient"], axis=0, inplace=True, ascending=False)
print(coefs.head(3))
Para encontrar parâmetros, precisamos de:
Os parâmetros estarão na seção "Attributes", e não em "parameters"!
E os algoritmos baseados em árvore?
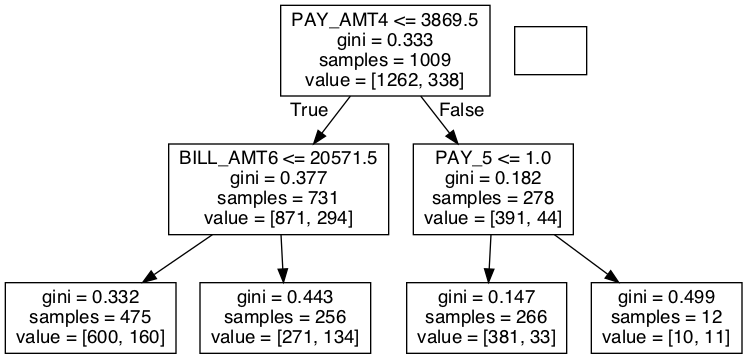
Random forest não tem coeficientes, mas decisões nos nós (qual atributo e valor de corte).
# A simple random forest estimator rf_clf = RandomForestClassifier(max_depth=2) rf_clf.fit(X_train, y_train)# Pull out one tree from the forest chosen_tree = rf_clf.estimators_[7]
Para simplificar, mostraremos o produto final (uma imagem) da árvore de decisão. Fique à vontade para explorar os pacotes usados (graphviz & pydotplus).

Podemos extrair detalhes do nó à esquerda, o segundo de cima:
# Get the column it split on split_column = chosen_tree.tree_.feature[1] split_column_name = X_train.columns[split_column]# Get the level it split on split_value = chosen_tree.tree_.threshold[1]print("This node split on feature {}, at a value of {}" .format(split_column_name, split_value))
"Este nó dividiu na feature PAY_0, no valor 1.5"
Ajuste de Hiperparâmetros em Python