Ajuste de Hiperparâmetros em Python
Alex Scriven
Data Scientist
Seu trabalho anterior:
neighbors_list = [3,5,10,20,50,75]
accuracy_list = []
for test_number in neighbors_list:
model = KNeighborsClassifier(n_neighbors=test_number)
predictions = model.fit(X_train, y_train).predict(X_test)
accuracy = accuracy_score(y_test, predictions)
accuracy_list.append(accuracy)
Depois reunimos tudo em um dataframe para analisar.
E testar valores de 2 hiperparâmetros?
Usando um algoritmo GBM:
learn_rate [0.001, 0.01, 0.05]max_depth [4,6,8,10]Podemos usar um for (aninhado)!
Primeiro, uma função para criar o modelo:
def gbm_grid_search(learn_rate, max_depth): model = GradientBoostingClassifier( learning_rate=learn_rate, max_depth=max_depth)predictions = model.fit(X_train, y_train).predict(X_test)return([learn_rate, max_depth, accuracy_score(y_test, predictions)])
Agora podemos iterar pelas listas de hiperparâmetros e chamar a função:
results_list = []
for learn_rate in learn_rate_list:
for max_depth in max_depth_list:
results_list.append(gbm_grid_search(learn_rate,max_depth))
Também podemos colocar esses resultados em um DataFrame e imprimir:
results_df = pd.DataFrame(results_list, columns=['learning_rate', 'max_depth', 'accuracy'])
print(results_df)
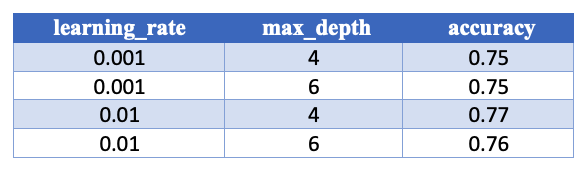
Ao adicionar mais hiperparâmetros e valores, criamos muito mais modelos.
E a validação cruzada?
E se adicionarmos mais hiperparâmetros?
Podemos aninhar nosso loop!
# Ajuste a lista de valores a testar
learn_rate_list = [0.001, 0.01, 0.1, 0.2, 0.3, 0.4, 0.5]
max_depth_list = [4,6,8, 10, 12, 15, 20, 25, 30]
subsample_list = [0.4,0.6, 0.7, 0.8, 0.9]
max_features_list = ['auto', 'sqrt']
Ajuste da nossa função:
def gbm_grid_search(learn_rate, max_depth,subsample,max_features):
model = GradientBoostingClassifier(
learning_rate=learn_rate,
max_depth=max_depth,
subsample=subsample,
max_features=max_features)
predictions = model.fit(X_train, y_train).predict(X_test)
return([learn_rate, max_depth, accuracy_score(y_test, predictions)])
Ajustando nosso for (aninhamento):
for learn_rate in learn_rate_list:
for max_depth in max_depth_list:
for subsample in subsample_list:
for max_features in max_features_list:
results_list.append(gbm_grid_search(learn_rate,max_depth,
subsample,max_features))
results_df = pd.DataFrame(results_list, columns=['learning_rate',
'max_depth', 'subsample', 'max_features','accuracy'])
print(results_df)
Quantos modelos agora?
Não dá para aninhar para sempre!
Além disso, e se quisermos:
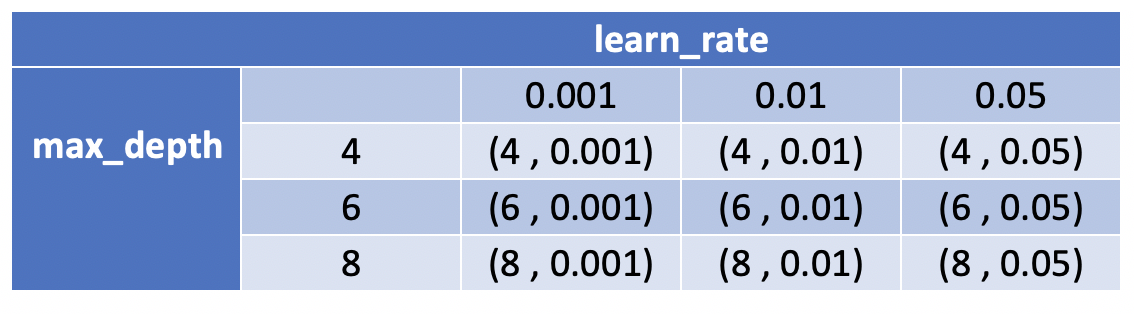
Vamos criar uma grade:

Percorrendo cada célula da grade:

(4,0.001) equivale a criar um estimator assim:
GradientBoostingClassifier(max_depth=4, learning_rate=0.001)
Algumas vantagens desta abordagem:
Vantagens:
Algumas desvantagens desta abordagem:
Veremos métodos "informados" depois!
Ajuste de Hiperparâmetros em Python