Ajuste de Hiperparâmetros em Python
Alex Scriven
Data Scientist
Bem parecido com grid search:
MAS em vez disso selecionamos quadrados da grade de forma aleatória.
Bengio & Bergstra (2012):
Este artigo mostra, empiricamente e teoricamente, que testes escolhidos aleatoriamente são mais eficientes para otimização de hiperparâmetros do que testes em grade.
Duas razões principais:
Uma grid search:

Quantos modelos precisamos rodar para ter 95% de chance de pegar um dos quadrados verdes?
Nossos melhores modelos:
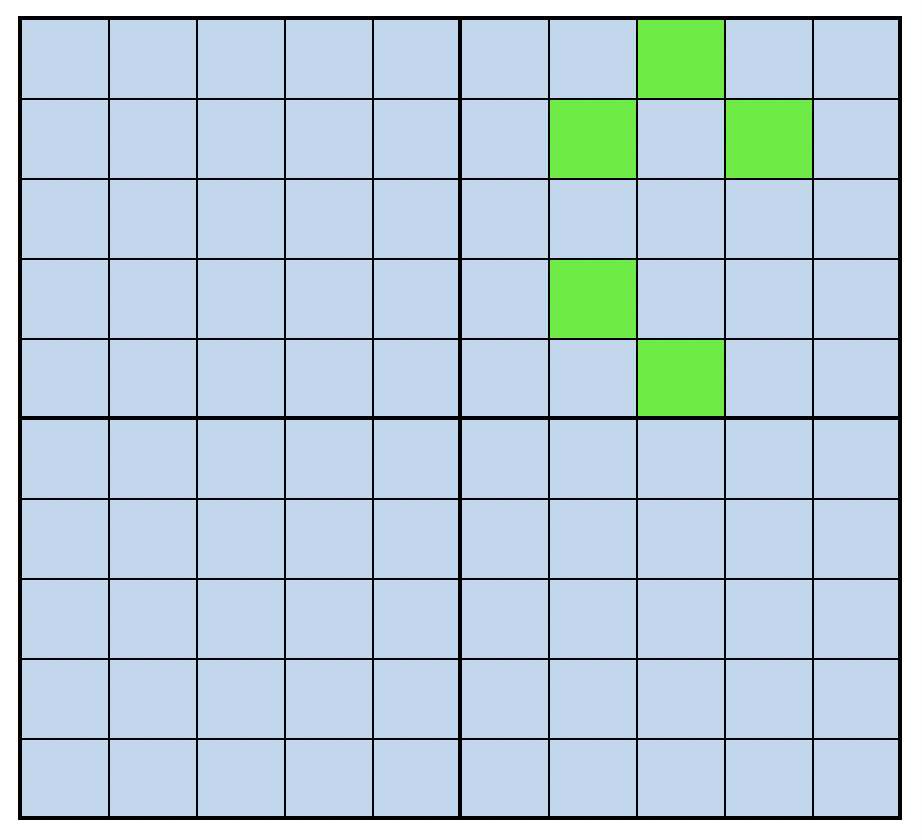
Se selecionarmos combinações de hiperparâmetros aleatoriamente e de forma uniforme, vamos considerar a chance de ERRAR todos os testes, para mostrar como isso é improvável
Teste 1 = 0,05 de chance de sucesso e (1 - 0,05) de errar
Com n testes, temos (1-0,05)^n de chance de que cada teste erre o ponto desejado.
Então, quantos testes para ter alta (95%) chance de cair nessa região?
O que isso tudo significa?
Lembre-se:
O máximo ainda é tão bom quanto a grade que você definiu!
Para comparar de forma justa com grid search, use o mesmo "orçamento" de modelagem
Podemos criar nossa própria amostra aleatória de combinações de hiperparâmetros:
# Set some hyperparameter lists
learn_rate_list = np.linspace(0.001,2,150)
min_samples_leaf_list = list(range(1,51))
# Create list of combinations
from itertools import product
combinations_list = [list(x) for x in
product(learn_rate_list, min_samples_leaf_list)]
# Select 100 models from our larger set
random_combinations_index = np.random.choice(
range(0,len(combinations_list)), 100,
replace=False)
combinations_random_chosen = [combinations_list[x] for x in
random_combinations_index]
Também podemos visualizar a cobertura do random search plotando as escolhas de hiperparâmetros nos eixos X e Y.
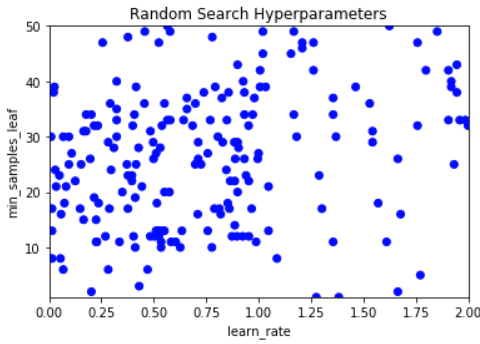
Perceba que há ampla dispersão, mas pouca cobertura em profundidade.
Ajuste de Hiperparâmetros em Python