Ajuste de Hiperparâmetros em Python
Alex Scriven
Data Scientist
Vamos analisar as saídas do GridSearchCV.
Três grupos de propriedades do GridSearchCV:
cv_results_best_index_, best_params_ e best_score_scorer_, n_splits_ e refit_time_
As propriedades são acessadas com notação de ponto.
Por exemplo:
grid_search_object.property
Onde property é a propriedade que você quer obter
A propriedade cv_results_:
Leia em um DataFrame para imprimir e analisar:
cv_results_df = pd.DataFrame(grid_rf_class.cv_results_)
print(cv_results_df.shape)
(12, 23)
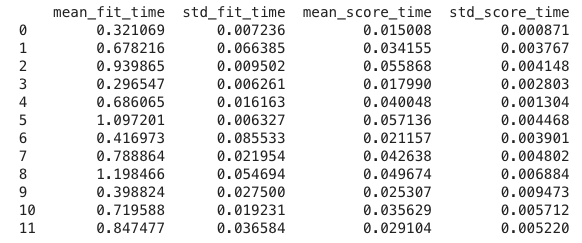
As colunas time indicam o tempo para ajustar (e avaliar) o modelo.
Lembra da validação cruzada 5-fold? Ela roda 5 vezes e armazena a média e o desvio padrão dos tempos em segundos.
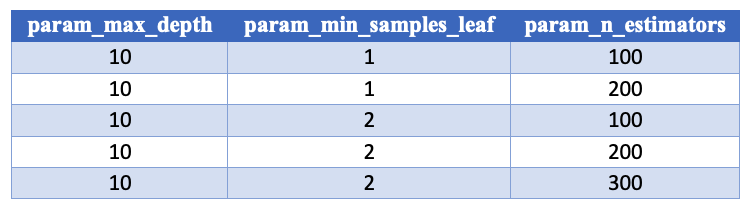
As colunas param_ guardam os parâmetros testados naquela linha, uma coluna por parâmetro
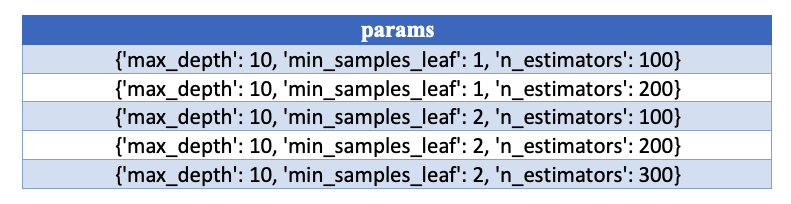
A coluna params contém um dicionário com todos os parâmetros:
pd.set_option("display.max_colwidth", -1)
print(cv_results_df.loc[:, "params"])
As colunas test_score trazem as pontuações no conjunto de teste para cada fold, além de estatísticas resumidas:
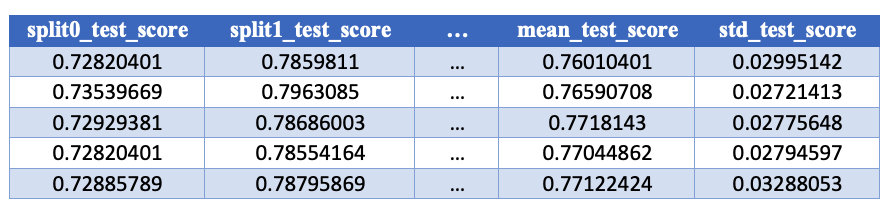
A coluna de ranking, ordenando o mean_test_score do melhor ao pior:
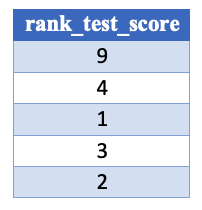
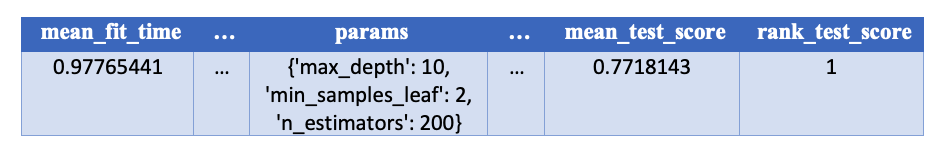
Podemos selecionar facilmente o melhor quadrado da grade a partir de cv_results_ usando a coluna rank_test_score
best_row = cv_results_df[cv_results_df["rank_test_score"] == 1]
print(best_row)
As colunas test_score são repetidas para training_scores.
Alguns pontos importantes:
return_train_score deve ser True para incluir as colunas de treino.
Não há coluna de ranking para as pontuações de treino, pois nos importam os resultados no teste
As informações do melhor quadrado da grade ficam resumidas nestas três propriedades:
best_params_, o dicionário de parâmetros que gerou a melhor pontuação.
best_score_, a melhor pontuação.
best_index_, a linha em cv_results_.rank_test_score que foi a melhor.
A propriedade best_estimator_ é um estimador construído com os melhores parâmetros da grid search.
No nosso caso, é um estimador Random Forest:
type(grid_rf_class.best_estimator_)
sklearn.ensemble.forest.RandomForestClassifier
Você também pode usar esse objeto diretamente como estimador!
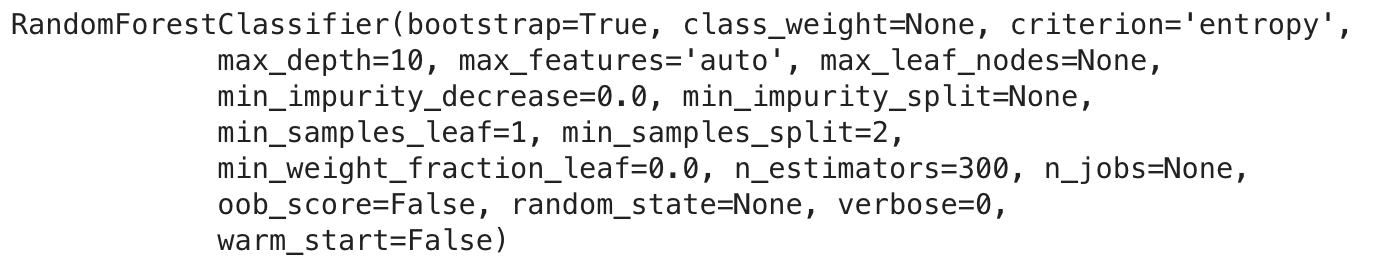
print(grid_rf_class.best_estimator_)

Algumas informações extras estão disponíveis nas propriedades:
scorer_Qual função de pontuação foi usada no conjunto de validação. (definimos AUC)
n_splits_Quantos splits de validação cruzada. (Definimos 5)
refit_time_Segundos usados para reajustar o melhor modelo em todo o conjunto de dados.
Ajuste de Hiperparâmetros em Python