Busca em grade com Scikit Learn
Ajuste de Hiperparâmetros em Python

Alex Scriven
Data Scientist
Objeto GridSearchCV
Apresentando um objeto GridSearchCV:
sklearn.model_selection.GridSearchCV(
    estimator,
    param_grid, scoring=None, fit_params=None,
    n_jobs=None, refit=True, cv='warn',
    verbose=0, pre_dispatch='2*n_jobs',
    error_score='raise-deprecating',
    return_train_score='warn')
Etapas de uma busca em grade
Etapas de uma busca em grade:
- Um algoritmo para ajustar os hiperparâmetros (às vezes chamado de "estimator")
- Definir quais hiperparâmetros serão ajustados
- Definir um intervalo de valores para cada hiperparâmetro
- Definir um esquema de validação cruzada; e
- Definir uma função de pontuação para escolher o melhor quadrado da grade
- Incluir informações ou funções extras úteis
Entradas do objeto GridSearchCV
As entradas importantes são:
estimatorparam_gridcvscoringrefitn_jobsreturn_train_score
GridSearchCV "estimator"
A entrada estimator:
- Essencialmente, nosso algoritmo
- Você já trabalhou com KNN, Random Forest, GBM, Regressão Logística
Lembre-se:
- Apenas um estimator por objeto GridSearchCV
GridSearchCV "param_grid"
A entrada param_grid:
- Define quais hiperparâmetros e valores testar
Em vez de uma lista:
max_depth_list = [2, 4, 6, 8]
min_samples_leaf_list = [1, 2, 4, 6]
Ficaria assim:
param_grid = {'max_depth': [2, 4, 6, 8],
              'min_samples_leaf': [1, 2, 4, 6]}
GridSearchCV "param_grid"
A entrada param_grid:
Lembre-se: As chaves do dicionário param_grid devem ser hiperparâmetros válidos.
Por exemplo, para um estimator de Regressão Logística:
# Incorrect
param_grid = {'C': [0.1,0.2,0.5],
              'best_choice': [10,20,50]}
ValueError: Invalid parameter best_choice for estimator LogisticRegression
GridSearchCV "cv"
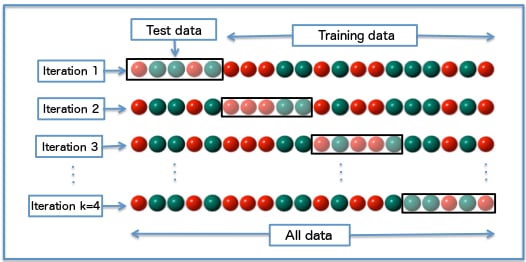
A entrada cv:
- Escolha de como fazer a validação cruzada
- Um inteiro faz k-fold cross validation; 5 ou 10 costuma ser padrão
GridSearchCV "scoring"
A entrada scoring:
- Qual métrica usar para escolher o melhor quadrado (modelo)
- Use a sua ou o módulo
metricsdo Scikit Learn
Você pode ver todas as funções de pontuação embutidas assim:
from sklearn import metrics
sorted(metrics.SCORERS.keys())
GridSearchCV "refit"
A entrada refit:
- Ajusta os melhores hiperparâmetros aos dados de treino
- Permite usar o
GridSearchCVcomo um estimator (para prever) - Muito útil!
GridSearchCV "n_jobs"
A entrada n_jobs:
- Ajuda na execução paralela
- Permite criar vários modelos ao mesmo tempo, em vez de sequencialmente
Código útil:
import os
print(os.cpu_count())
Cuidado ao usar todos os núcleos se quiser fazer outras tarefas!
GridSearchCV "return_train_score"
A entrada return_train_score:
- Registra estatísticas das execuções de treino realizadas
- Útil para analisar o trade-off viés-variância, mas aumenta o custo computacional
- Não ajuda a escolher o melhor modelo; serve apenas para análise
Construindo um objeto GridSearchCV
Construindo nosso próprio objeto GridSearchCV:
# Create the grid param_grid = {'max_depth': [2, 4, 6, 8], 'min_samples_leaf': [1, 2, 4, 6]}#Get a base classifier with some set parameters. rf_class = RandomForestClassifier(criterion='entropy', max_features='auto')
Construindo um objeto GridSearchCv
Juntando as peças:
grid_rf_class = GridSearchCV(
    estimator = rf_class,
    param_grid = parameter_grid,
    scoring='accuracy',
    n_jobs=4,
    cv = 10,
    refit=True,
    return_train_score=True)
Usando um objeto GridSearchCV
Como definimos refit como True, podemos usar o objeto diretamente:
#Fit the object to our data
grid_rf_class.fit(X_train, y_train)

# Make predictions
grid_rf_class.predict(X_test)
Vamos praticar!
Ajuste de Hiperparâmetros em Python

