Random Search no Scikit Learn
Ajuste de Hiperparâmetros em Python

Alex Scriven
Data Scientist
Comparando com GridSearchCV
Não precisamos reinventar a roda. Vamos relembrar as etapas do Grid Search:
- Escolher um algoritmo/estimador
- Definir quais hiperparâmetros serão ajustados
- Definir um intervalo de valores para cada hiperparâmetro
- Definir um esquema de validação cruzada; e
- Definir uma função de pontuação
- Incluir informações ou funções extras úteis
Comparando com Grid Search
Há apenas uma diferença:
- Etapa 7 = Decidir quantas amostras pegar (e então amostrar)
É isso! (quase)
Comparando módulos do Scikit Learn
Os módulos também são parecidos:
GridSearchCV:
sklearn.model_selection.GridSearchCV(estimator, param_grid,
        scoring=None, fit_params=None,
        n_jobs=None,
        refit=True, cv='warn', verbose=0,
        pre_dispatch='2*n_jobs',
        error_score='raise-deprecating',
        return_train_score='warn')
RandomizedSearchCV:
sklearn.model_selection.RandomizedSearchCV(estimator,
        param_distributions, n_iter=10,
        scoring=None, fit_params=None,
        n_jobs=None, refit=True,
        cv='warn', verbose=0,
        pre_dispatch='2*n_jobs',
        random_state=None,
        error_score='raise-deprecating',
        return_train_score='warn')
Principais diferenças
Duas diferenças principais:
n_iter, o número de amostras que a busca aleatória vai pegar do seu grid. No exemplo anterior você usou 300.param_distributionsé um pouco diferente deparam_grid, permitindo opcionalmente definir uma distribuição para amostragem.- O padrão é todas as combinações com chance igual de serem escolhidas.
Criar um objeto RandomizedSearchCV
Agora dá para montar um objeto de busca aleatória como o grid search, com nossa pequena mudança:
# Set up the sample space learn_rate_list = np.linspace(0.001,2,150) min_samples_leaf_list = list(range(1,51)) # Create the grid parameter_grid = { 'learning_rate' : learn_rate_list, 'min_samples_leaf' : min_samples_leaf_list}# Define how many samples number_models = 10
Criar um objeto RandomizedSearchCV
Agora podemos construir o objeto
# Create a random search object
random_GBM_class = RandomizedSearchCV(
    estimator = GradientBoostingClassifier(),
    param_distributions = parameter_grid,
    n_iter = number_models,
    scoring='accuracy',
    n_jobs=4,
    cv = 10,
    refit=True,
    return_train_score = True)
# Fit the object to our data
random_GBM_class.fit(X_train, y_train)
Analisar a saída
A saída é exatamente a mesma!
Como ver quais valores de hiperparâmetros foram escolhidos?
No dicionário cv_results_ (nas colunas param_ relevantes)!
Extraia as listas:
rand_x = list(random_GBM_class.cv_results_['param_learning_rate'])
rand_y = list(random_GBM_class.cv_results_['param_min_samples_leaf'])
Analisar a saída
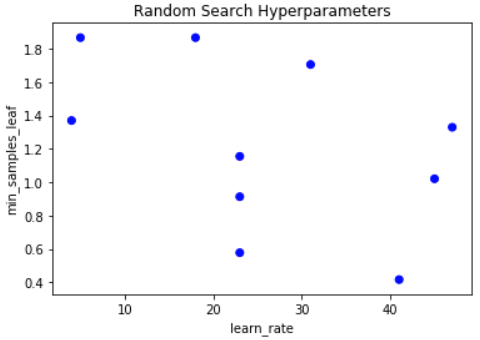
Vamos montar nossa visualização:
# Make sure we set the limits of Y and X appriately x_lims = [np.min(learn_rate_list), np.max(learn_rate_list)] y_lims = [np.min(min_samples_leaf_list), np.max(min_samples_leaf_list)]# Plot grid results plt.scatter(rand_y, rand_x, c=['blue']*10) plt.gca().set(xlabel='learn_rate', ylabel='min_samples_leaf', title='Random Search Hyperparameters') plt.show()
Analisar a saída
Um gráfico parecido com o anterior:
Vamos praticar!
Ajuste de Hiperparâmetros em Python

