Métodos para coletar feedback de alta qualidade

Reinforcement Learning from Human Feedback (RLHF)

Mina Parham

AI Engineer

Métodos para coletar feedback de alta qualidade
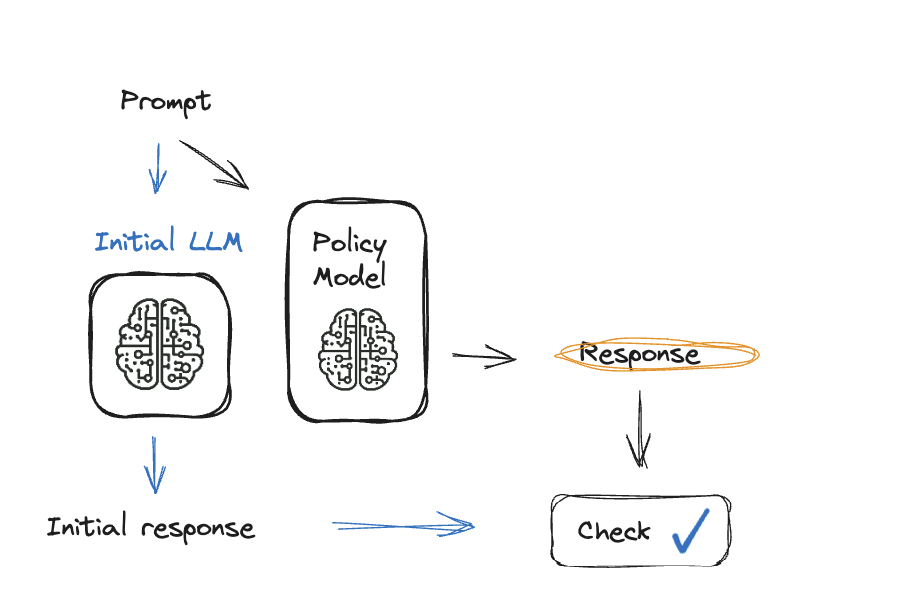
O processo de RLHF, sem o modelo de recompensa.

Reinforcement Learning from Human Feedback (RLHF)

Métodos para coletar feedback de alta qualidade

O processo completo de RLHF.

Reinforcement Learning from Human Feedback (RLHF)

Comparações em pares

  • Escolha entre duas opções:
  • Vantagens: Simples, intuitivo, reduz viés
  • Desafios: Fornece menos informação por rótulo
  • Exemplo: Filme A vs. Filme B: "Qual você prefere?

Uma pessoa segurando dois cartazes nas mãos: um com um ícone de "Aceito" e outro com um ícone de "Rejeitado".

Reinforcement Learning from Human Feedback (RLHF)

Comparações em pares

def evaluate_responses(responses_A, responses_B):
    wins_A, wins_B = 0, 0
    for (response_A, score_A), (response_B, score_B) in zip(responses_A, responses_B):
        if score_A > score_B:
            wins_A += 1
        else:
            wins_B += 1
    success_rate_A = (wins_A / len(responses_A)) * 100
    success_rate_B = (wins_B / len(responses_B)) * 100
    return success_rate_A, success_rate_B
Reinforcement Learning from Human Feedback (RLHF)

Avaliações

  • Atribuir uma nota em uma escala:

  • Vantagens: Fornece feedback mais detalhado

  • Desafios: Propenso a vieses, escalas inconsistentes
  • Exemplo:
      Filme A: 4/5
      Filme B: 3/5
    

Ilustração de uma mulher segurando uma estrela, com ícones de avaliação ao redor.

Reinforcement Learning from Human Feedback (RLHF)

Fatores psicológicos

  • Vieses cognitivos:
    • Efeito de enquadramento: Como a pergunta é apresentada pode influenciar respostas
    • Efeito de posição serial: A ordem das opções pode afetar decisões
    • Ancoragem: Informações prévias enviesam decisões atuais

Uma pessoa vendo um quadrado com os olhos, mas interpretando-o como um retângulo na mente, ilustrando viés.

Reinforcement Learning from Human Feedback (RLHF)

Diretrizes para coletar feedback de alta qualidade
 

  • Carga cognitiva: usuários cansados, feedback inconsistente
  • Formule perguntas com cuidado
    • Para reduzir riscos da carga cognitiva.
  • Aleatorize a ordem das consultas
    • Para minimizar viés de ancoragem e enquadramento
  • Colete dados diversos
    • Para mitigar o ruído.

Um homem e uma mulher analisando feedbacks e textos.

Reinforcement Learning from Human Feedback (RLHF)

Vamos praticar!

Reinforcement Learning from Human Feedback (RLHF)

Preparing Video For Download...