Fine-tuning eficiente em RLHF

Reinforcement Learning from Human Feedback (RLHF)

Mina Parham

AI Engineer

Fine-tuning eficiente em parâmetros

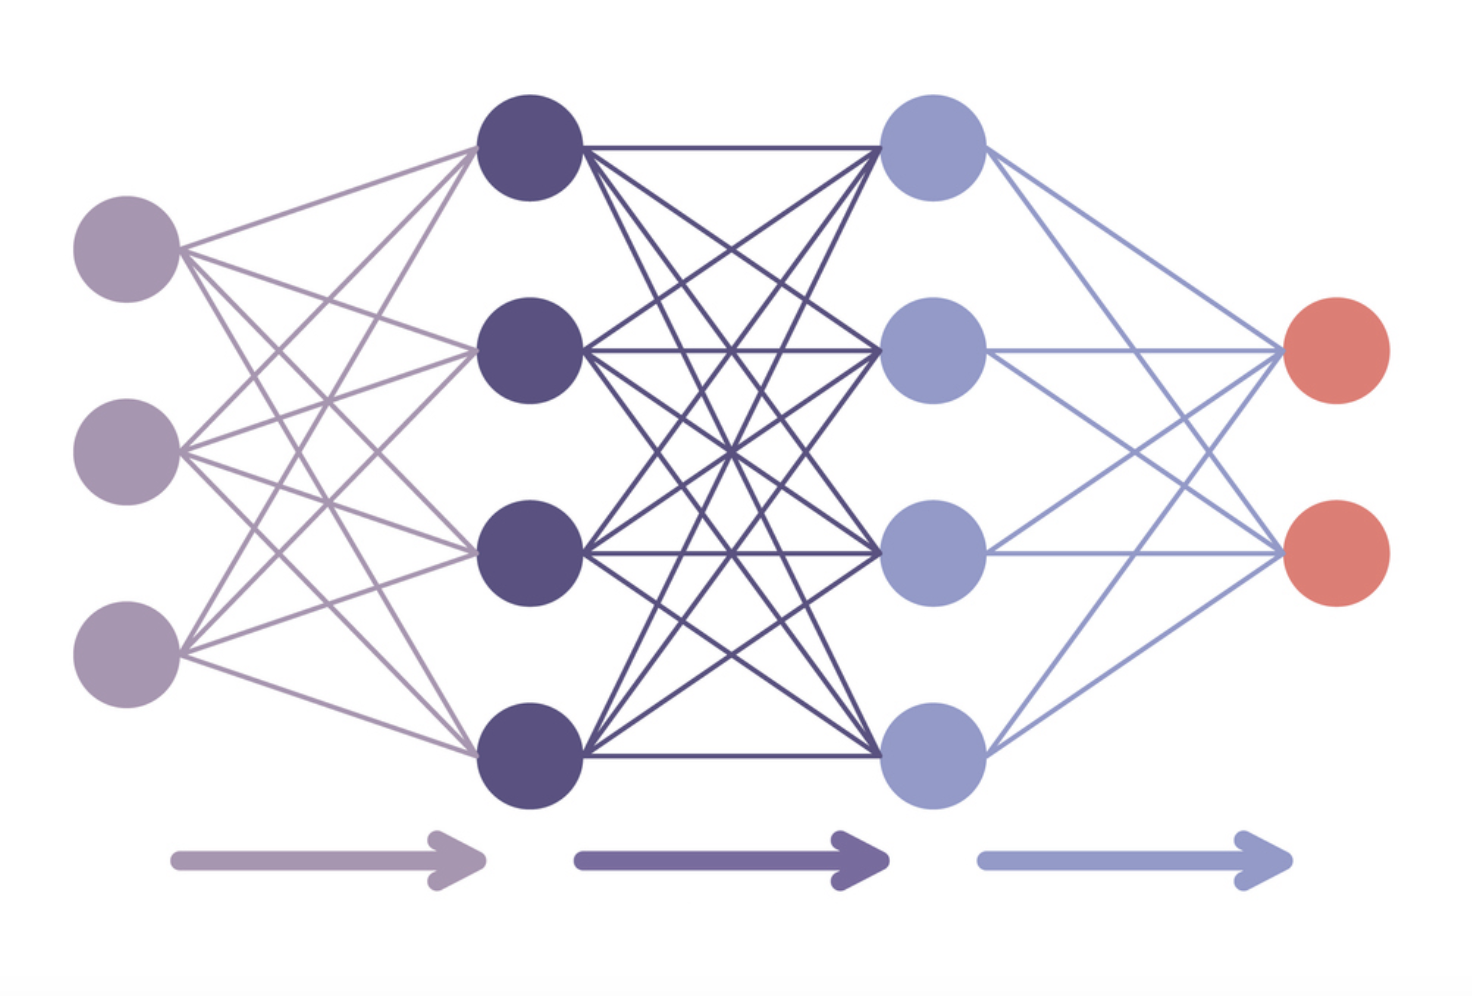
  • Fine-tuning do modelo completo

Ilustração representando uma rede neural.

Reinforcement Learning from Human Feedback (RLHF)

Fine-tuning eficiente em parâmetros

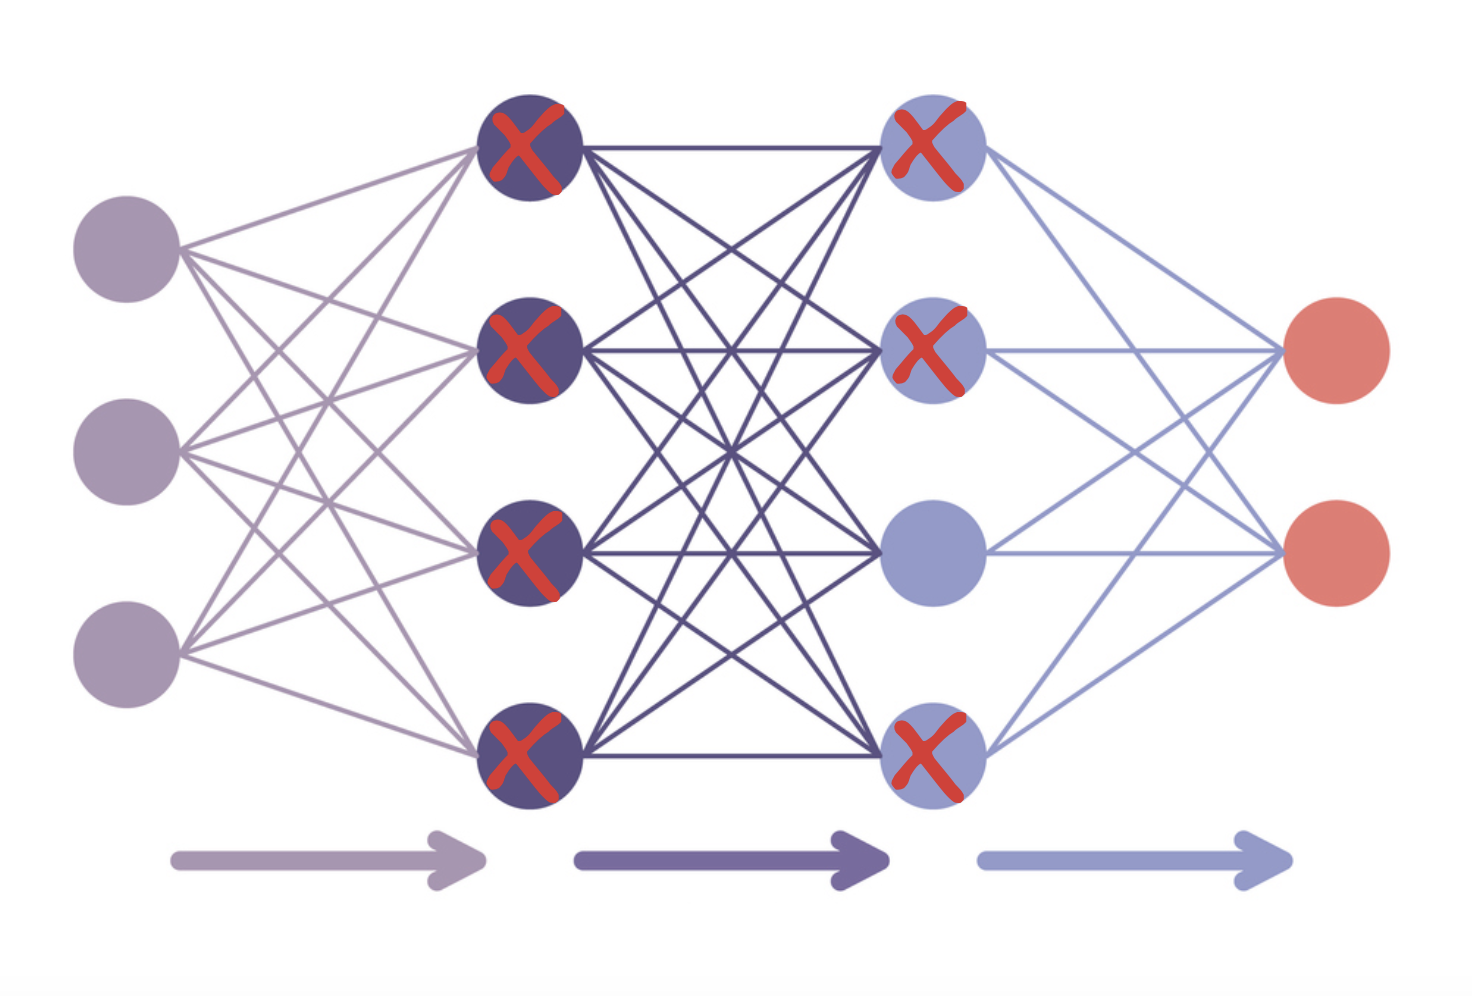
  • Fine-tuning com PEFT

Ilustração representando uma rede neural com a maior parte dos parâmetros congelados.

  • LoRA: ajusta só algumas camadas
  • Quantização: reduz a precisão do tipo de dado
Reinforcement Learning from Human Feedback (RLHF)

Passo 1: carregar seu modelo ativo em precisão de 8 bits

from peft import prepare_model_for_int8_training

pretrained_model = AutoModelForCausalLM.from_pretrained( model_name, load_in_8bit=True )
pretrained_model_8bit = prepare_model_for_int8_training(pretrained_model)
Reinforcement Learning from Human Feedback (RLHF)

Passo 2: adicionar adaptadores treináveis com peft

from peft import LoraConfig, get_peft_model


config = LoraConfig(
r=32, # Rank das matrizes de baixa ordem
lora_alpha=32, # Fator de escala para as atualizações LoRA
lora_dropout=0.1, # Taxa de dropout nas camadas LoRA
bias="lora_only"# Atualiza só os termos de bias nas camadas LoRA; os demais ficam congelados
)
lora_model = get_peft_model(pretrained_model_8bit, config) model = AutoModelForCausalLMWithValueHead.from_pretrained(lora_model)
Reinforcement Learning from Human Feedback (RLHF)

Passo 3: usar um modelo para logits de referência e ativos

ppo_trainer = PPOTrainer(
    config, # A config que acabamos de definir
    model, # Nosso modelo PPO
    ref_model=None, 
    tokenizer=tokenizer, 
    dataset=dataset, 
    data_collator=collator, 
    optimizer=optimizer
)
Reinforcement Learning from Human Feedback (RLHF)

Vamos praticar!

Reinforcement Learning from Human Feedback (RLHF)

Preparing Video For Download...