Introdução a RLHF

Reinforcement Learning from Human Feedback (RLHF)

Mina Parham

AI Engineer

Bem-vindo/a ao curso!


  • Instrutora: Mina Parham


  • Engenheira de IA
  • Large Language Models (LLMs)
  • Reinforcement Learning from Human Feedback (RLHF)


  • Tema: Reinforcement Learning from Human Feedback (RLHF)
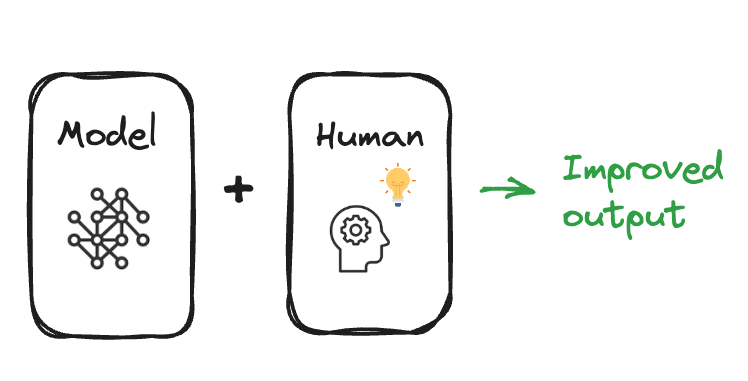
Um diagrama representando um modelo de IA com uma etapa extra envolvendo um humano.

Reinforcement Learning from Human Feedback (RLHF)

Bem-vindo/a ao curso!


  • Instrutora: Mina Parham


  • Engenheira de IA
  • Large Language Models (LLMs)
  • Reinforcement Learning from Human Feedback (RLHF)


  • Tema: Reinforcement Learning from Human Feedback (RLHF)

Um diagrama representando um modelo de IA com uma etapa extra envolvendo um humano, levando a melhores resultados.

Reinforcement Learning from Human Feedback (RLHF)

Revisão de aprendizado por reforço
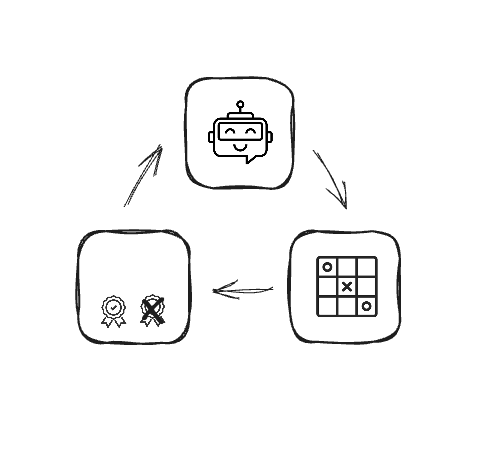
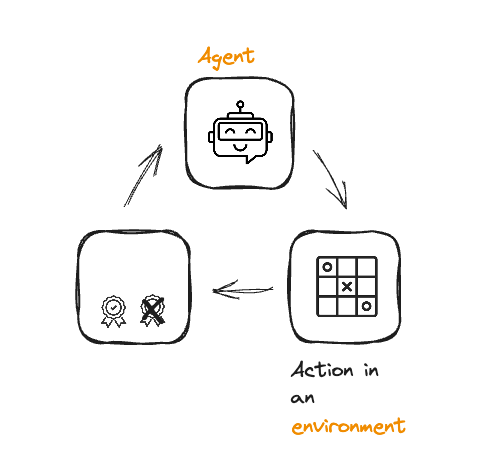
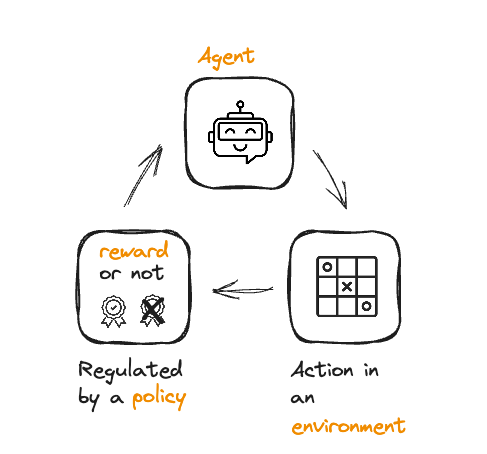
Um diagrama mostrando um ícone de agente, uma ação e uma política de recompensa em ciclo, representando o processo de aprendizado por reforço.

Reinforcement Learning from Human Feedback (RLHF)

Revisão de aprendizado por reforço

Um diagrama mostrando um ícone de agente, uma ação e uma política de recompensa em ciclo, representando o processo de aprendizado por reforço.

Reinforcement Learning from Human Feedback (RLHF)

Revisão de aprendizado por reforço

Um diagrama mostrando um ícone de agente, uma ação e uma política de recompensa em ciclo, representando o processo de aprendizado por reforço.

Reinforcement Learning from Human Feedback (RLHF)

Revisão de aprendizado por reforço

Um diagrama mostrando um ícone de agente, uma ação e uma política de recompensa em ciclo, representando o processo de aprendizado por reforço.

Reinforcement Learning from Human Feedback (RLHF)

De RL a RLHF


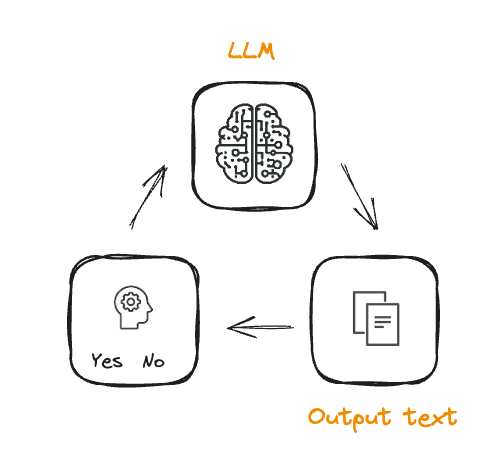
  Um diagrama com um ícone de LLM, uma saída de texto e um avaliador humano, representando parte do ciclo de aprendizado por reforço com feedback humano.

Reinforcement Learning from Human Feedback (RLHF)

De RL a RLHF


  Um diagrama com um ícone de LLM, uma saída de texto e um avaliador humano, representando parte do ciclo de aprendizado por reforço com feedback humano.

Reinforcement Learning from Human Feedback (RLHF)

De RL a RLHF

  • Treinar o modelo de recompensa
  • Alinhar às preferências humanas

Um diagrama com um ícone de LLM, uma saída de texto e um avaliador humano, representando parte do ciclo de aprendizado por reforço com feedback humano.

Reinforcement Learning from Human Feedback (RLHF)

Ajuste fino de LLM em RLHF


Um ícone de um large language model.

Reinforcement Learning from Human Feedback (RLHF)

Ajuste fino de LLM em RLHF

  • Treinar o LLM inicial

Um ícone de um large language model ajustado com um conjunto de dados de entrada.

Reinforcement Learning from Human Feedback (RLHF)

O processo completo de RLHF

Um prompt perguntando "Who wrote Romeo and Juliet" entrando em um LLM.

Reinforcement Learning from Human Feedback (RLHF)

O processo completo de RLHF

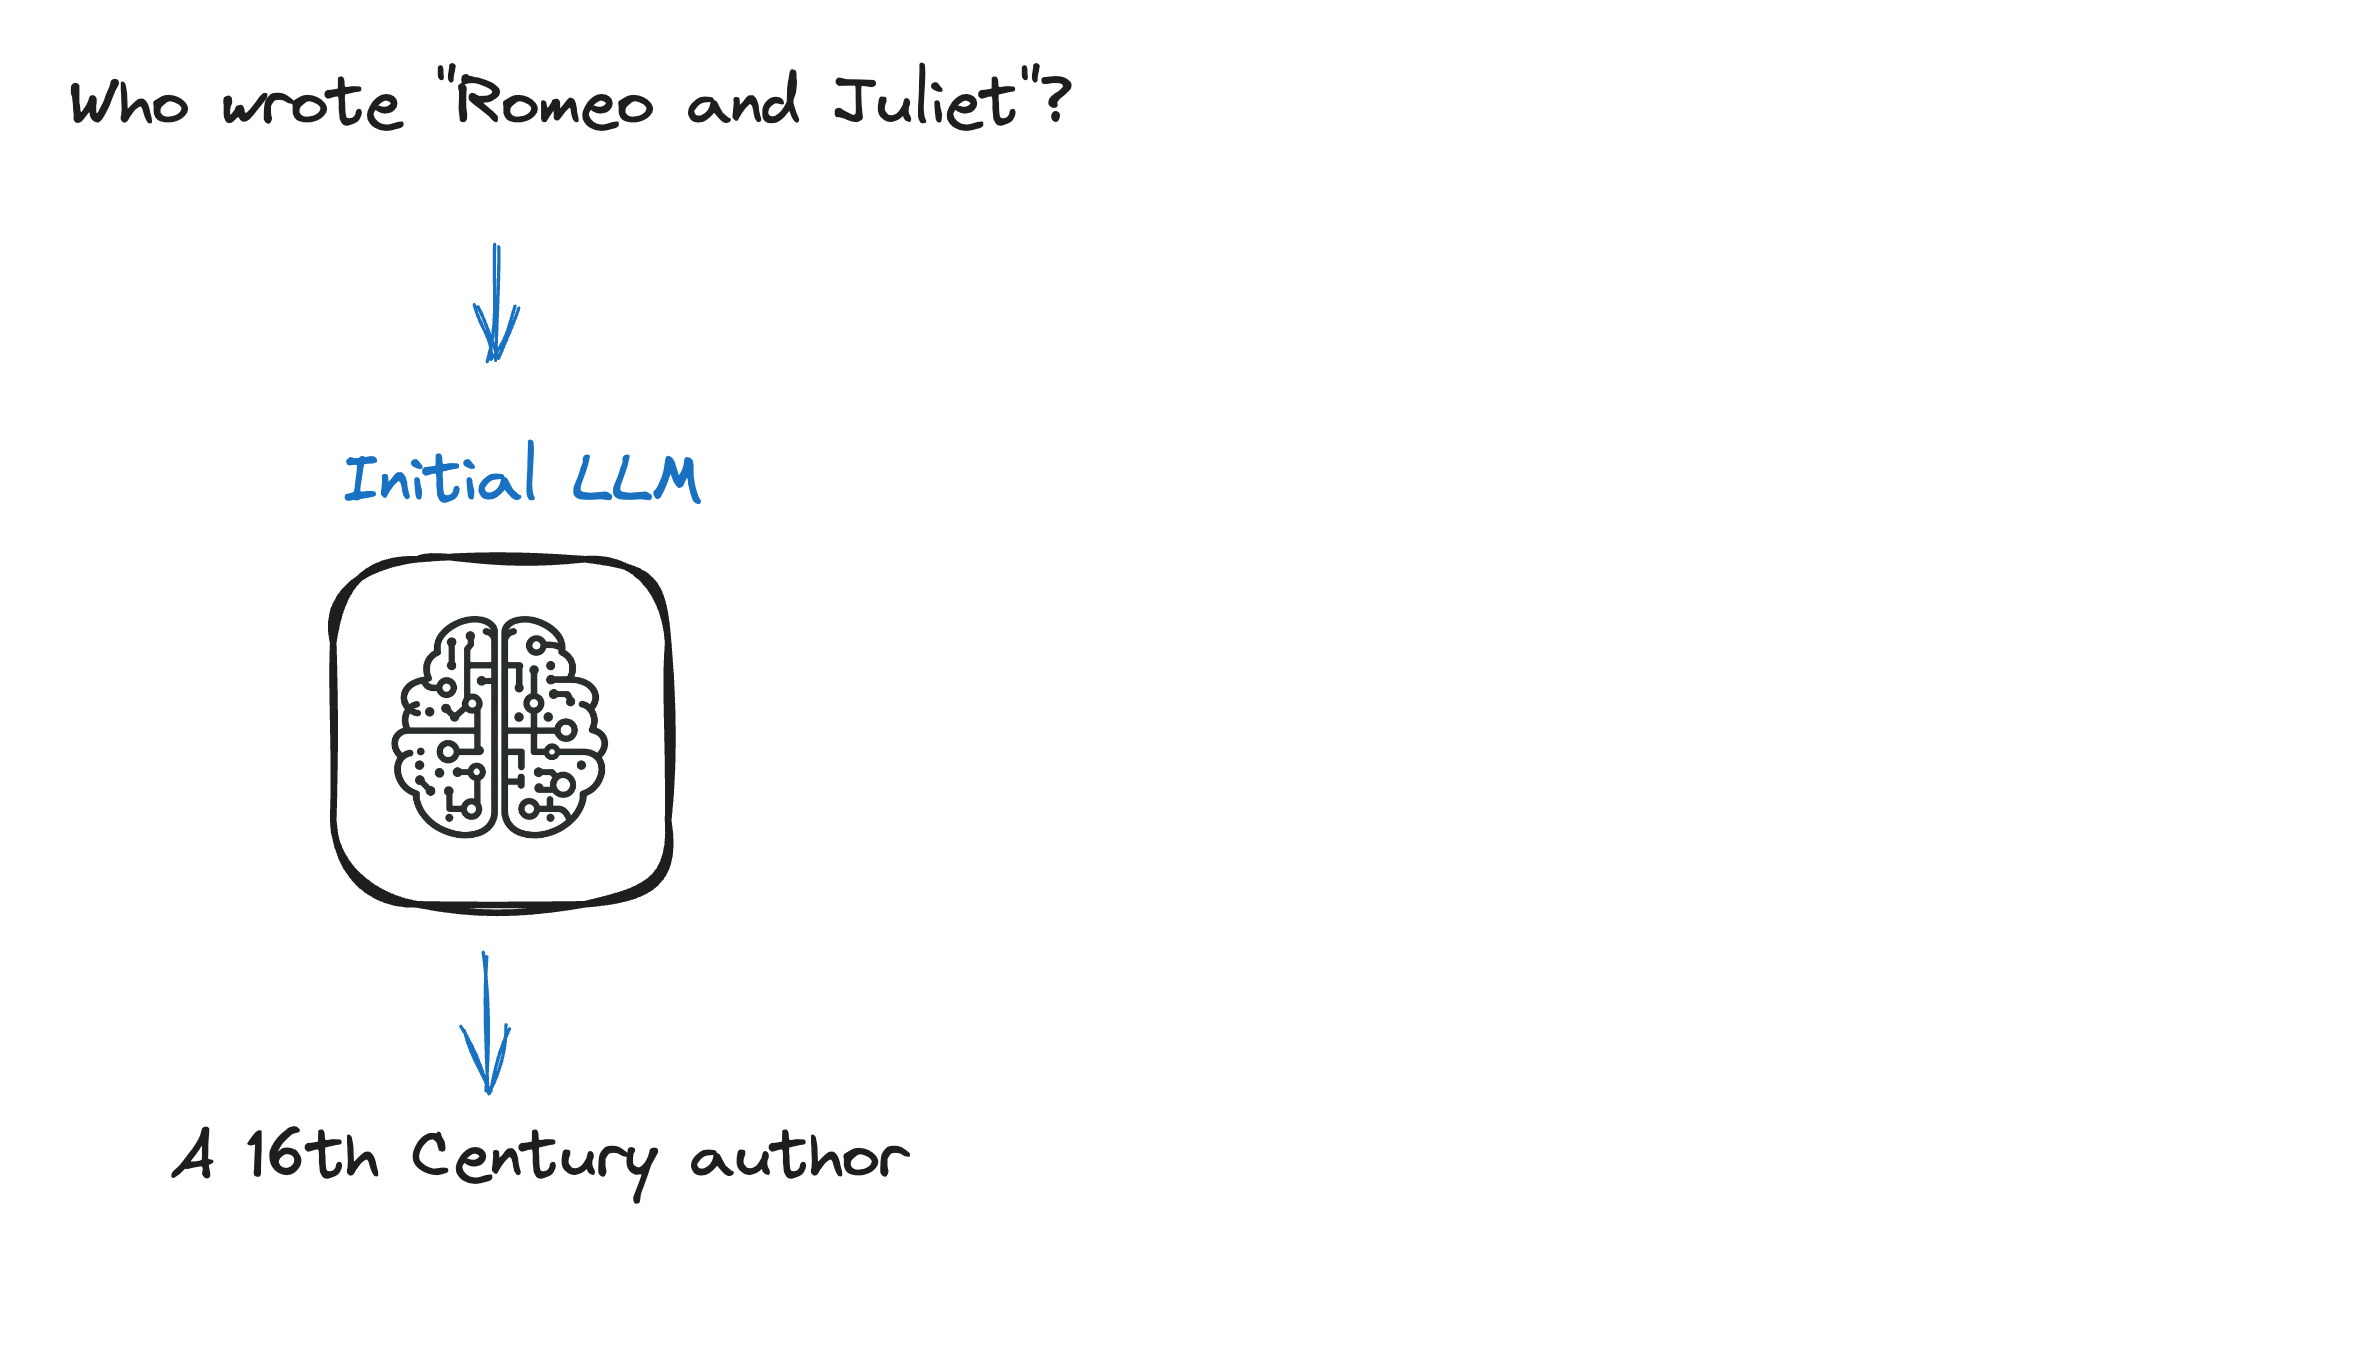
Um prompt perguntando "Who wrote Romeo and Juliet" com um LLM respondendo: "a 16th Century author".

Reinforcement Learning from Human Feedback (RLHF)

O processo completo de RLHF

Um prompt perguntando "Who wrote Romeo and Juliet" com um LLM respondendo: "a 16th Century author", e um modelo adicional, um modelo de política, recebendo o prompt.

Reinforcement Learning from Human Feedback (RLHF)

O processo completo de RLHF

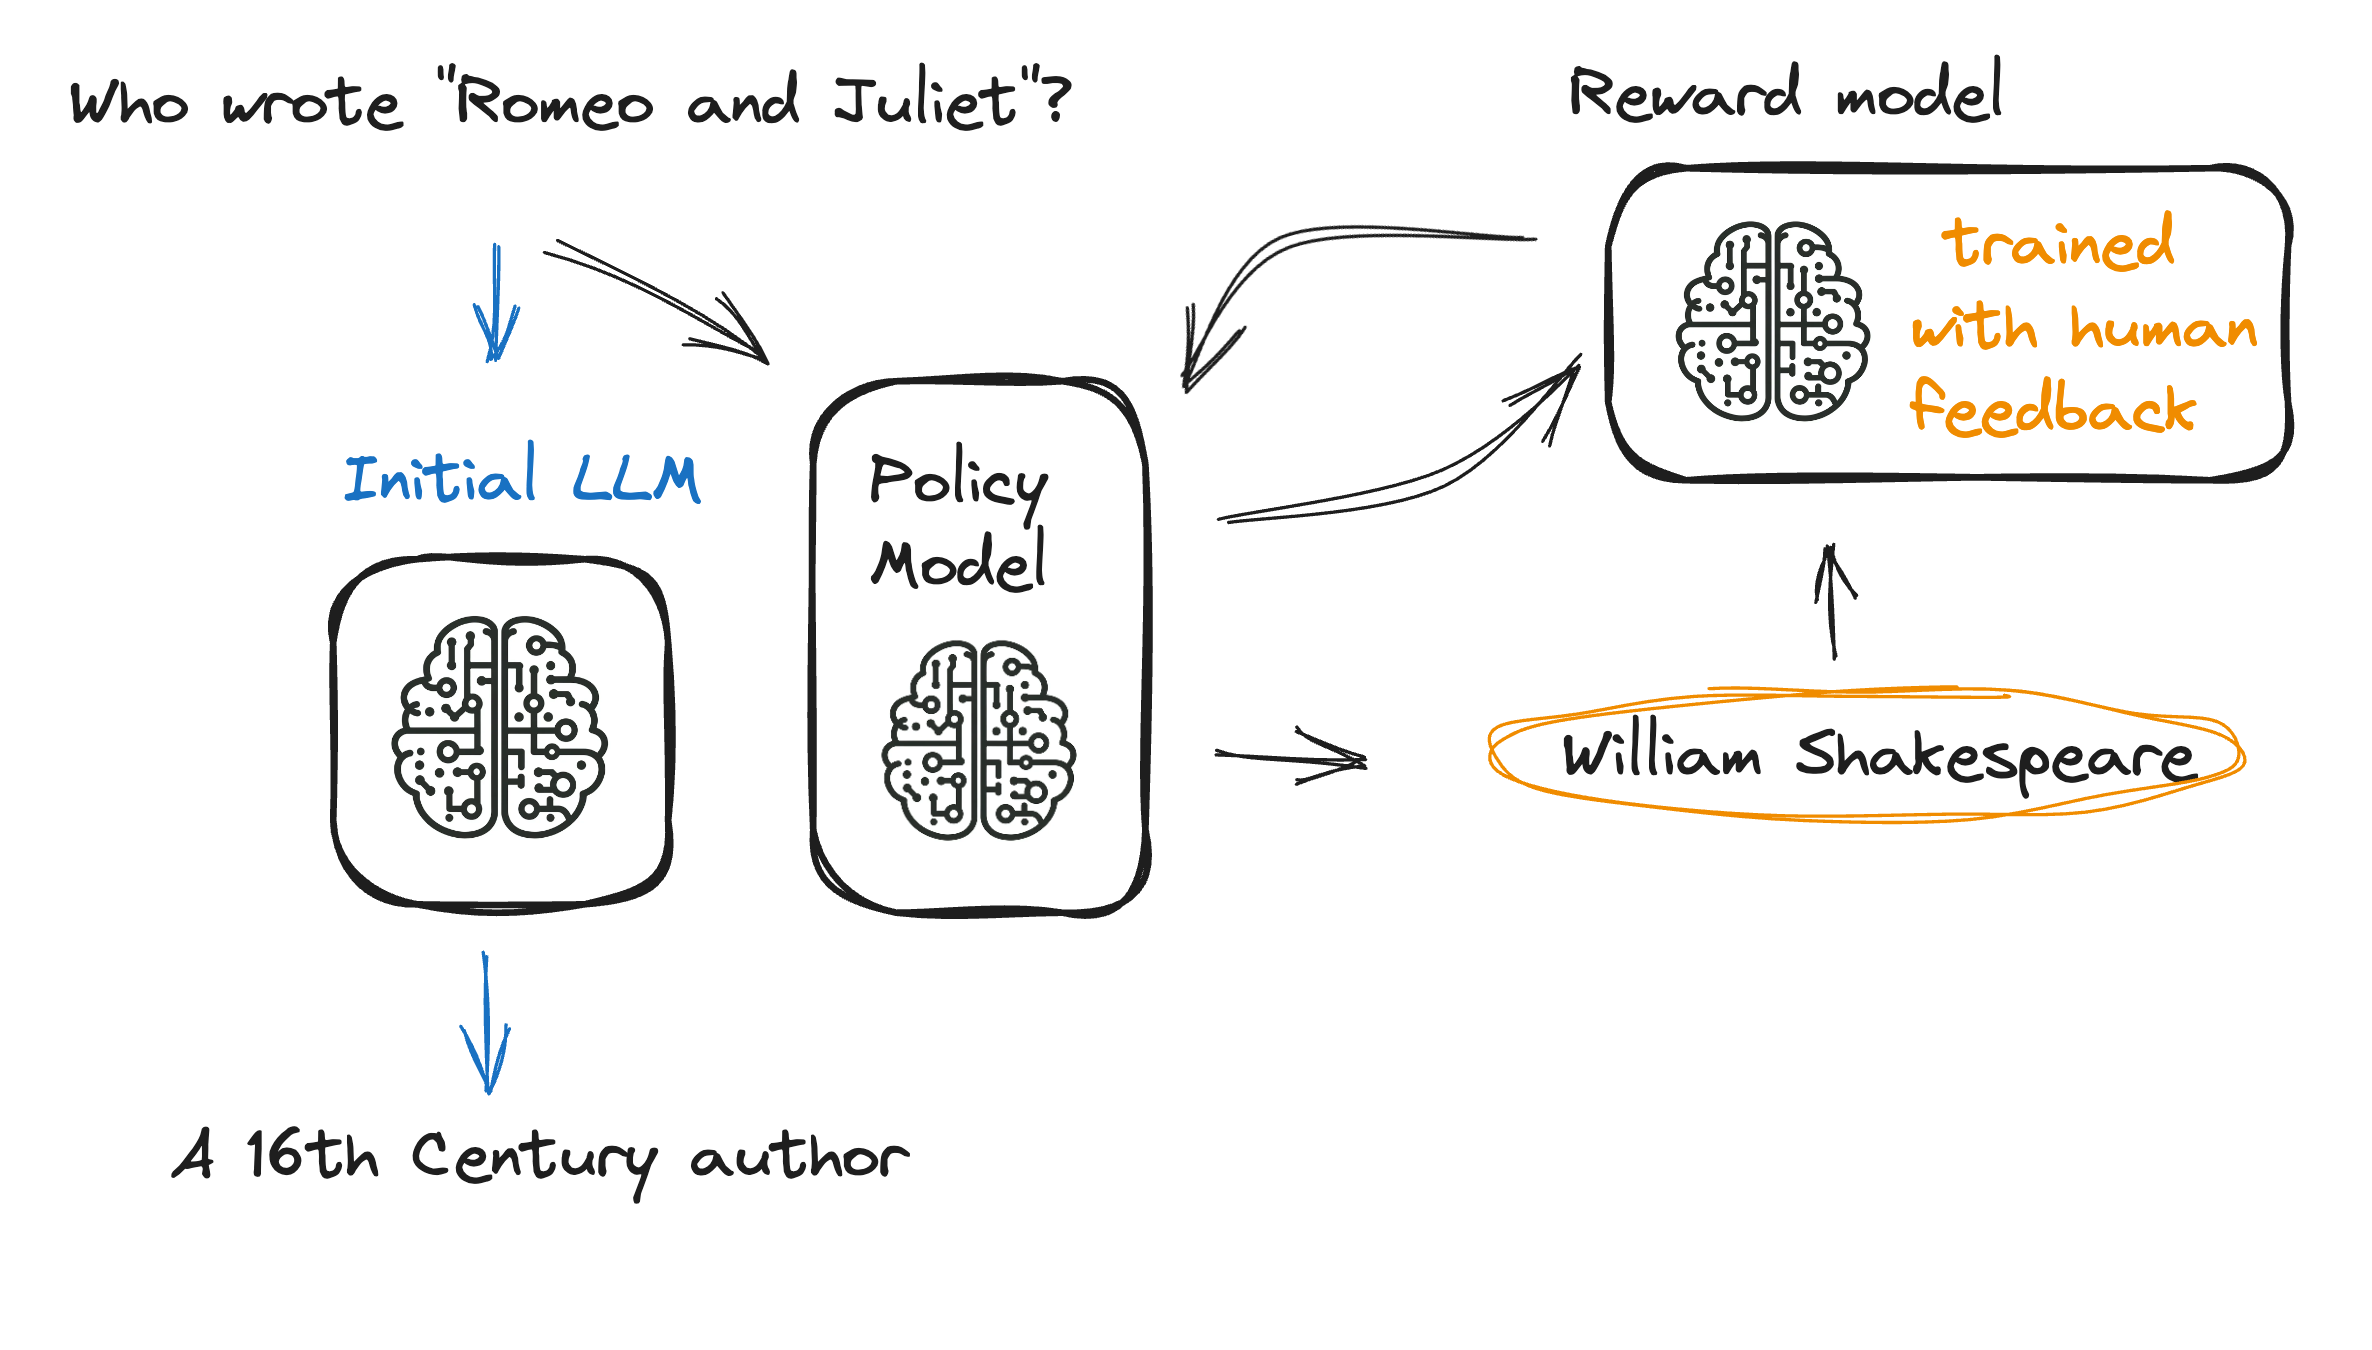
Um prompt perguntando "Who wrote Romeo and Juliet" com um LLM respondendo: "a 16th Century author", e um modelo adicional, um modelo de política, recebendo o prompt e sendo treinado usando um modelo de recompensa.

Reinforcement Learning from Human Feedback (RLHF)

O processo completo de RLHF

Um prompt perguntando "Who wrote Romeo and Juliet" com um LLM respondendo: "a 16th Century author", e um modelo adicional, um modelo de política, sendo treinado com um modelo de recompensa, dando a resposta "William Shakespeare".

Reinforcement Learning from Human Feedback (RLHF)

O processo completo de RLHF

Um prompt perguntando "Who wrote Romeo and Juliet" com um LLM respondendo: "a 16th Century author", e um modelo adicional, um modelo de política, sendo treinado com um modelo de recompensa, dando a resposta "William Shakespeare", e uma verificação entre os dois resultados.

Reinforcement Learning from Human Feedback (RLHF)

Interagindo com LLMs ajustados por RLHF

  • Modelos RLHF pré-treinados no Hugging Face 🤗
from transformers import pipeline

text_generator = pipeline('text-generation', model='lvwerra/gpt2-imdb-pos-v2')
# Provide a review prompt review_prompt = "This is definitely a" # Generate the continuation output = text_generator(review_prompt, max_length=50) #Print the generated text print(output[0]['generated_text'])
This is definitely a crucial improvement.
Reinforcement Learning from Human Feedback (RLHF)

Interagindo com LLMs ajustados por RLHF

from transformers import pipeline, AutoModelForSequenceClassification, AutoTokenizer


# Instantiate the pre-trained model and tokenizer model = AutoModelForSequenceClassification.from_pretrained("lvwerra/distilbert-imdb") tokenizer = AutoTokenizer.from_pretrained("lvwerra/distilbert-imdb")
# Use pipeline to create the sentiment analyzer sentiment_analyzer = pipeline('sentiment-analysis', model=model, tokenizer=tokenizer) # Pass the text to the sentiment analyzer and print the result sentiment = sentiment_analyzer("This is definitely a crucial improvement.")
print(f"Sentiment Analysis Result: {sentiment}")
positive
Reinforcement Learning from Human Feedback (RLHF)

Vamos praticar!

Reinforcement Learning from Human Feedback (RLHF)

Preparing Video For Download...