Treinando com PPO

Reinforcement Learning from Human Feedback (RLHF)

Mina Parham

AI Engineer

Fine-Tuning com aprendizado por reforço
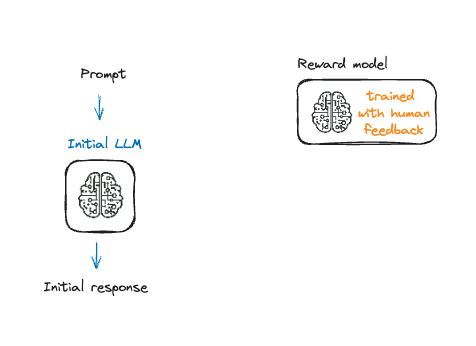
O LLM inicial e o modelo de recompensa no processo de RLHF.

Reinforcement Learning from Human Feedback (RLHF)

Fine-Tuning com aprendizado por reforço
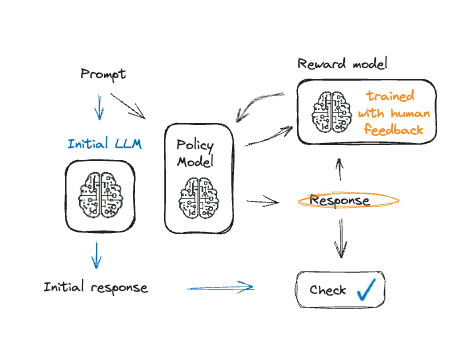
Todo o processo de RLHF.

Reinforcement Learning from Human Feedback (RLHF)

Ajuste fino de um Language Model com PPO
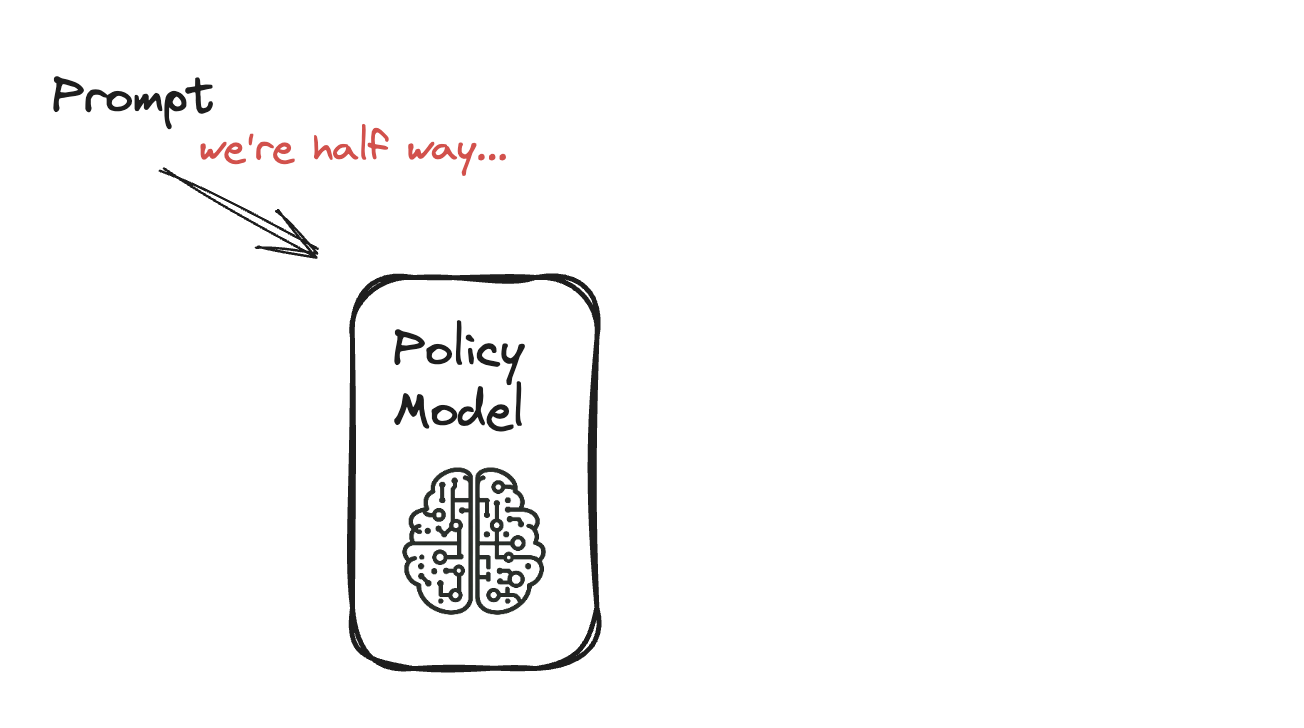
 

Um diagrama de uma consulta dada a um LLM para gerar uma continuação com base nela.

Reinforcement Learning from Human Feedback (RLHF)

Ajuste fino de um Language Model com PPO
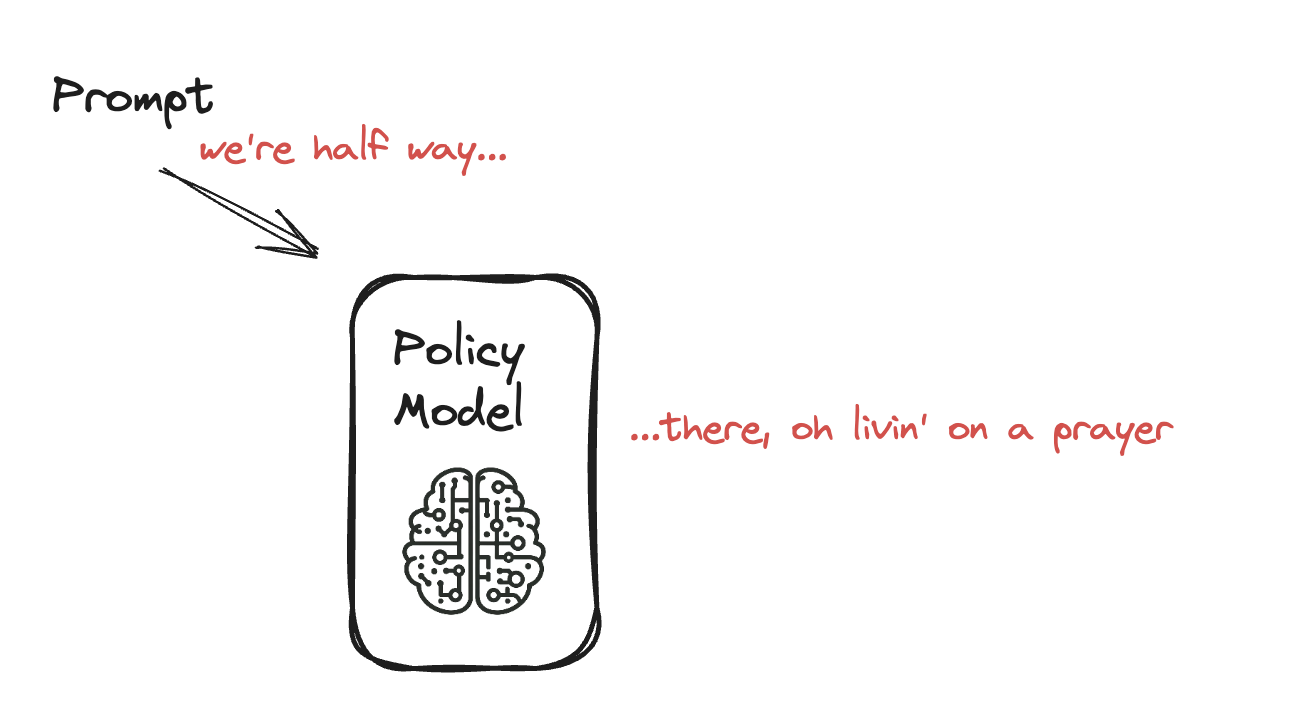
 

Um diagrama de uma consulta dada a um LLM, que completa a consulta: 'we're half way there, oh livin' on a prayer'.

Reinforcement Learning from Human Feedback (RLHF)

Ajuste fino de um Language Model com PPO
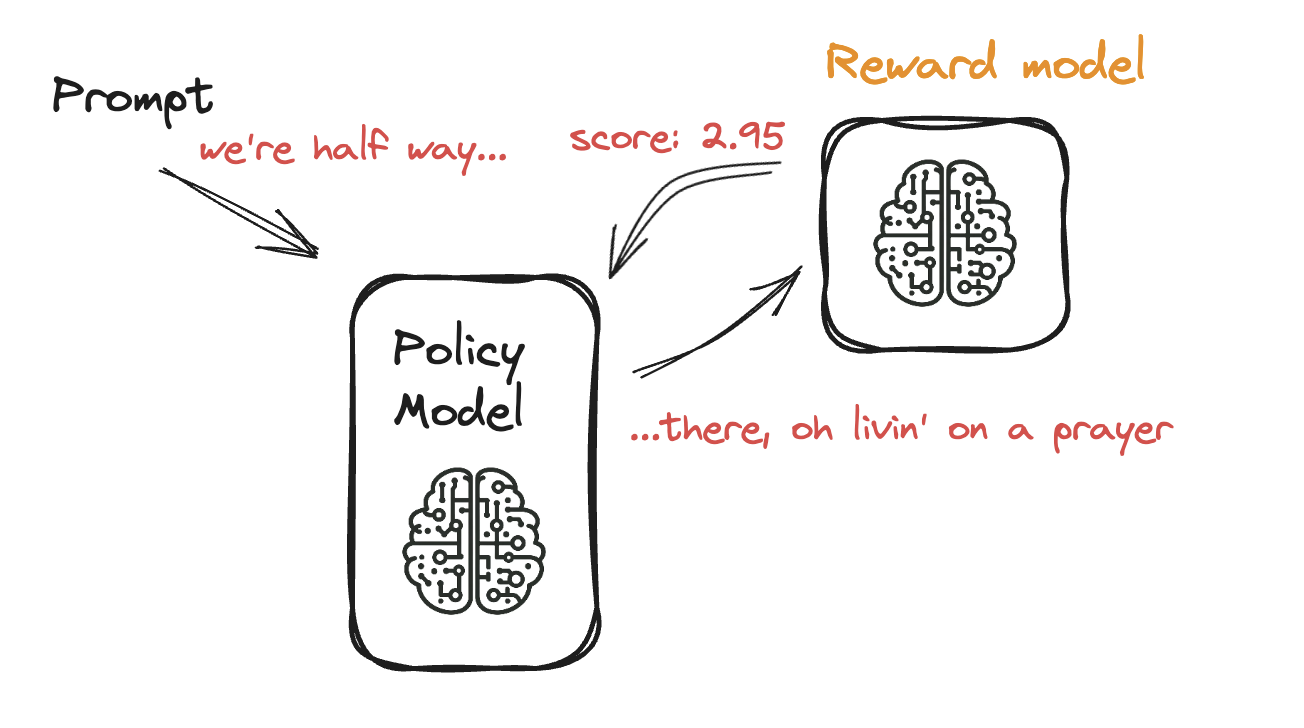
 

Um diagrama de uma consulta dada a um LLM, que completa a consulta: 'we're half way there, oh livin' on a prayer', com outro LLM avaliando a resposta.

Reinforcement Learning from Human Feedback (RLHF)

Ajuste fino de um Language Model com PPO

  • PPO: ajuste gradual do modelo
  • Evita overfitting ao feedback

Um robô e um caracol representando a melhoria lenta do algoritmo.

Reinforcement Learning from Human Feedback (RLHF)

Implementando PPOTrainer com TRL

from trl import PPOConfig
config = PPOConfig(model_name="gpt2",learning_rate=1.4e-5)
from trl import AutoModelForCausalLMWithValueHead
model = AutoModelForCausalLMWithValueHead.from_pretrained(config.model_name)
tokenizer = AutoTokenizer.from_pretrained(config.model_name)
from trl import PPOTrainer
ppo_trainer = PPOTrainer(model=model,config=config,dataset=dataset,
                         tokenizer=tokenizer)
Reinforcement Learning from Human Feedback (RLHF)

Iniciando o loop de treino

for epoch in tqdm(range(10), "epoch: "):


for batch in tqdm(ppo_trainer.dataloader):
# Get responses response_tensors = ppo_trainer.generate(batch["input_ids"])
batch["response"] = [tokenizer.decode(r.squeeze()) for r in response_tensors]
# Compute reward score texts = [q + r for q, r in zip(batch["query"], batch["response"])]
rewards = reward_model(texts)
stats = ppo_trainer.step(query_tensors, response_tensors, rewards) ppo_trainer.log_stats(stats, batch, rewards)
Reinforcement Learning from Human Feedback (RLHF)

Vamos praticar!

Reinforcement Learning from Human Feedback (RLHF)

Preparing Video For Download...