Métricas e ajustes de modelo

Reinforcement Learning from Human Feedback (RLHF)

Mina Parham

AI Engineer

Por que usar um modelo de referência?
  • Saídas sem sentido

Uma sequência de emojis.

Reinforcement Learning from Human Feedback (RLHF)

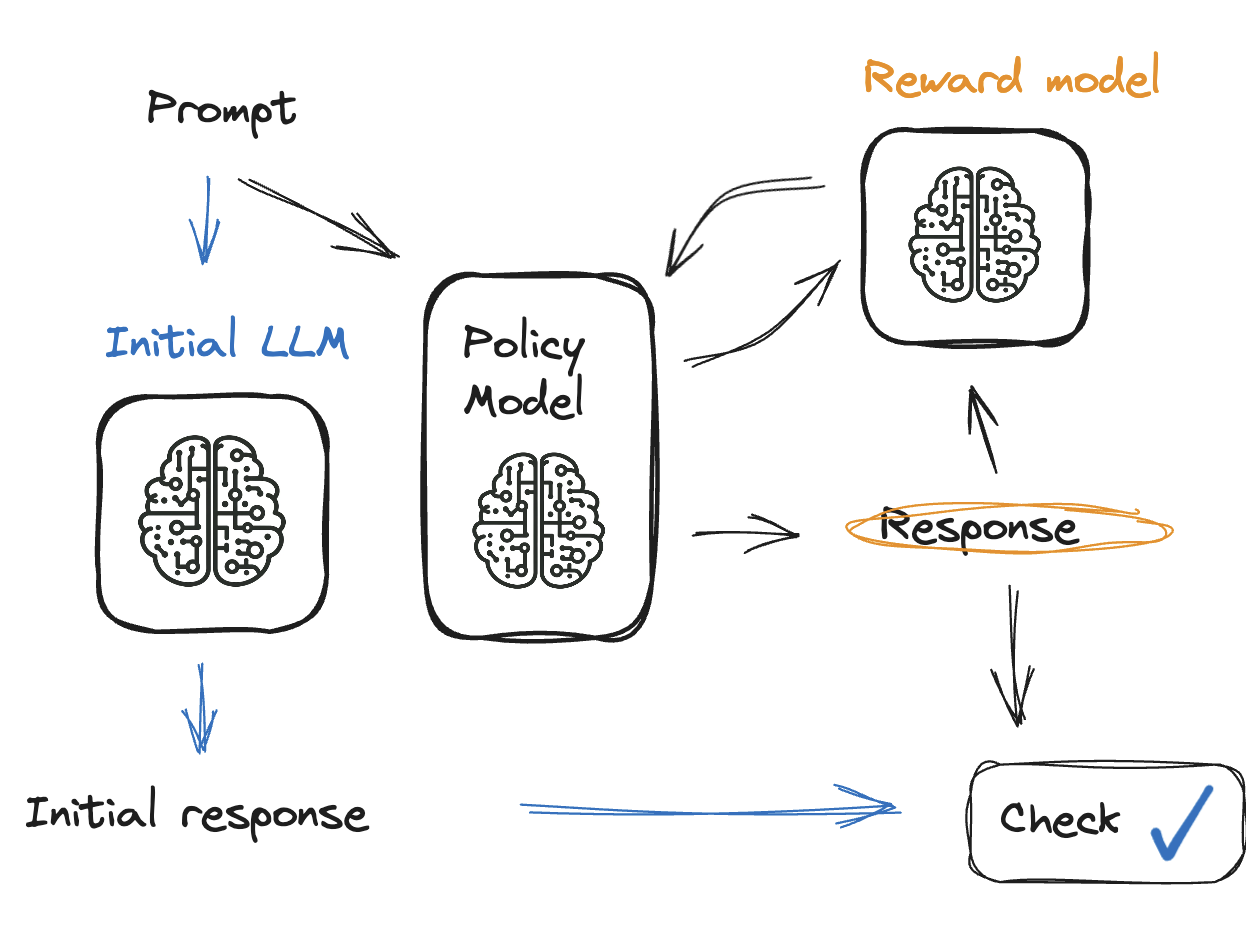
Verificando a saída do modelo

Diagrama do processo de RLHF com verificação da resposta.

Reinforcement Learning from Human Feedback (RLHF)

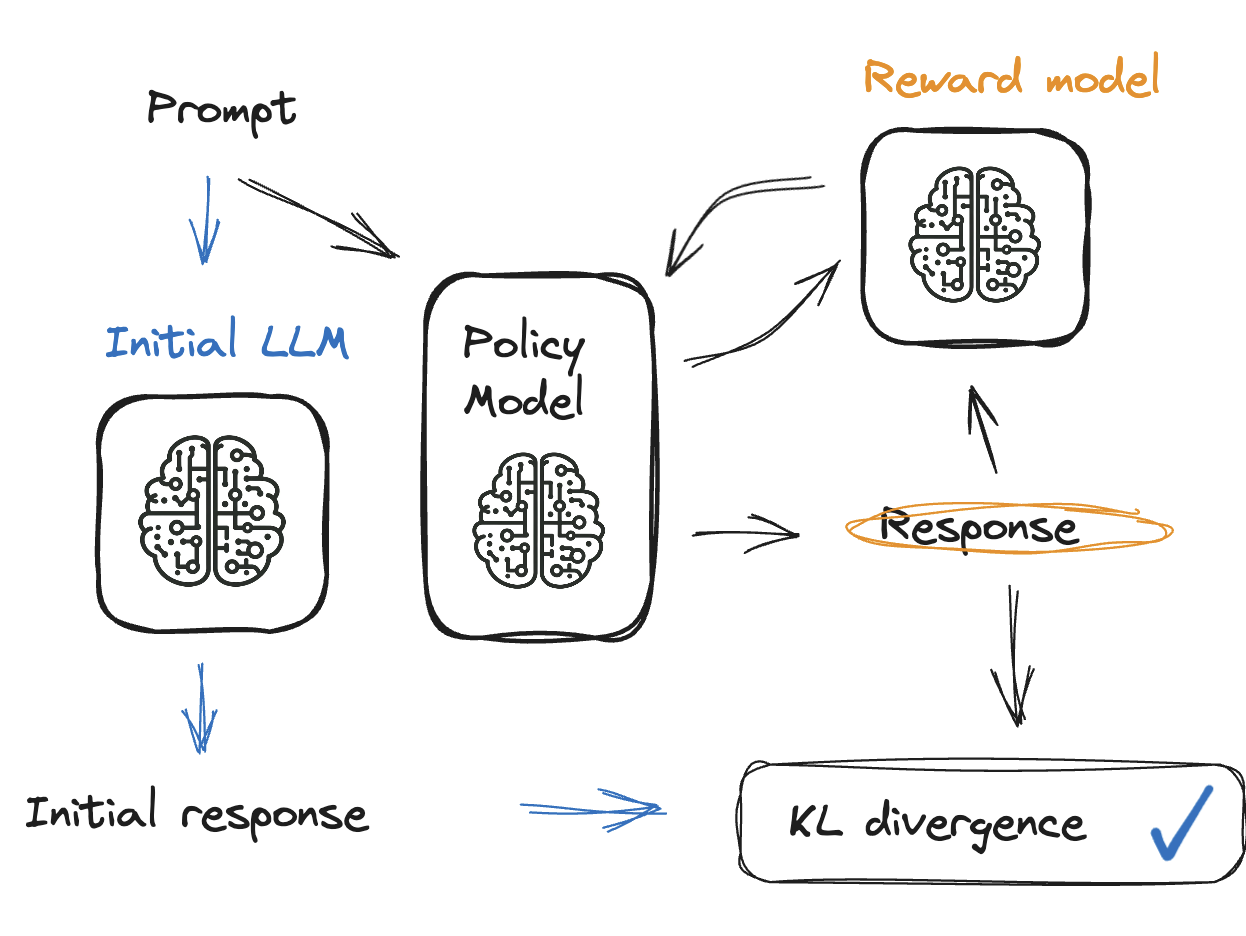
Solução: divergência KL

Diagrama do processo de RLHF com divergência KL.

Reinforcement Learning from Human Feedback (RLHF)

Solução: divergência KL

  • Penalidade é adicionada ao modelo de recompensa
  • A penalidade redireciona o modelo se gerar saídas sem relação
  • Divergência KL compara o modelo atual e o de recompensa
Um ícone representando uma balança.

  • Entre 0 e 10, e nunca negativa
Reinforcement Learning from Human Feedback (RLHF)

Ajustando parâmetros

generation_kwargs = {

"min_length": -1, # don't ignore the EOS token
"top_k": 0.0, # no top-k sampling
"top_p": 1.0, "do_sample": True, "pad_token_id": tokenizer.eos_token_id, "max_new_tokens": 32}


  • Parâmetros são passados para o modelo de política
Reinforcement Learning from Human Feedback (RLHF)

Verificando o modelo de recompensa

  • Verificando o modelo de recompensa

  • Verificando a saída (recompensa)

reward_model_results.head()
|ID | Comment                                     |Sentiment |Reward|
|---|---------------------------------------------|----------|------|
| 1 | This event was lit! So much fun!            | Positive |  0.9 |
| 2 | Terrible experience, never attending again. | Negative | -0.8 |
| 3 | It was okay, nothing extraordinary.         | Neutral  |  0.2 |
| 4 | The event was poorly organized and chaotic. | Negative | -0.85|
| 5 | Had an amazing time with great people!      | Positive |  0.95|
Reinforcement Learning from Human Feedback (RLHF)

Verificando o modelo de recompensa

  • 👍 👎 Verifique casos extremos
    extreme_positive = reward_model_results[reward_model_results['Reward'] >= 0.9]
    extreme_negative = reward_model_results[reward_model_results['Reward'] <= -0.8]
    
  • 🧘 Garanta um conjunto de dados balanceado

    sentiment_distribution = reward_model_results['Sentiment'].value_counts()
    
  • 📊 Normalize o modelo de recompensa

    from sklearn.preprocessing import MinMaxScaler
    scaler = MinMaxScaler(feature_range=(-1, 1))
    scaler.fit_transform(reward_model_results[['Reward']])
    
Reinforcement Learning from Human Feedback (RLHF)

Vamos praticar!

Reinforcement Learning from Human Feedback (RLHF)

Preparing Video For Download...