Incorporando fontes diversas de feedback

Reinforcement Learning from Human Feedback (RLHF)

Mina Parham

AI Engineer

Melhor generalização do modelo
 

  • Representa diferentes pontos de vista e contextos
  • Generaliza preferências e valores

Uma imagem de mãos com diferentes balões de fala representando opiniões diversas.

Reinforcement Learning from Human Feedback (RLHF)

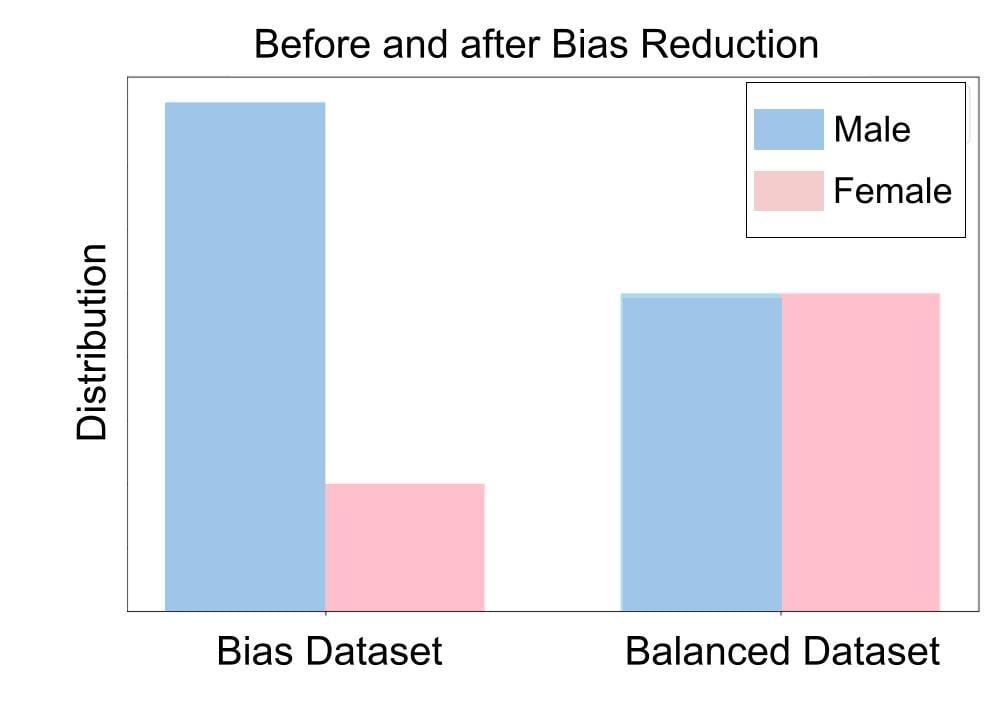
Viés reduzido

  • Atenua vieses individuais
  • Gera saídas mais equilibradas e justas

Um gráfico de barras mostrando a diferença entre um conjunto de dados enviesado para o grupo masculino e um conjunto equilibrado com distribuição igual para homens e mulheres

Reinforcement Learning from Human Feedback (RLHF)

Melhor alinhamento com valores humanos
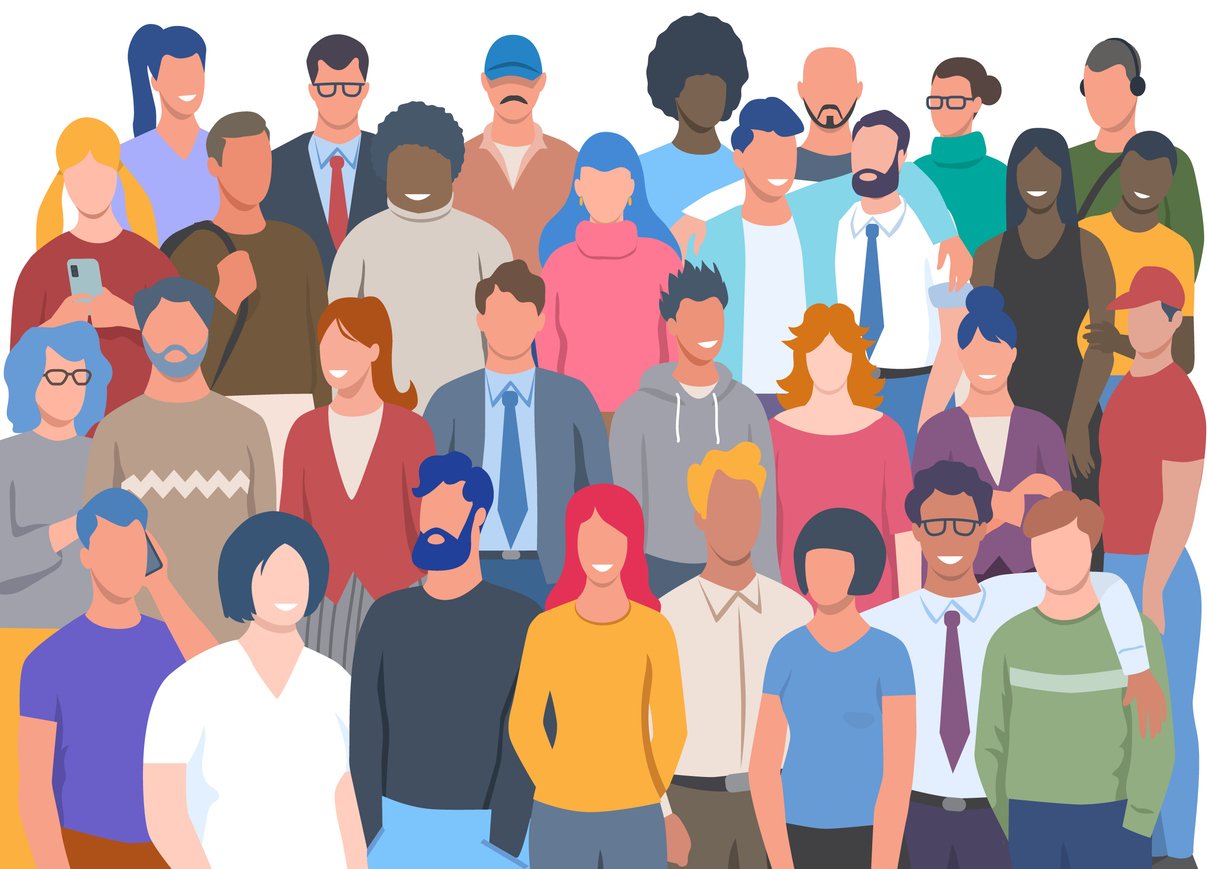
  • Preferências humanas complexas
  • Culturas e origens representadas

Ícones representando um grupo diverso de pessoas

Reinforcement Learning from Human Feedback (RLHF)

Maior adaptabilidade

  • O modelo responde a uma gama maior de necessidades e preferências
  • Representa diferentes pontos de vista

Um ícone mostrando uma pessoa com emojis indicando diferentes pontos de vista.

Reinforcement Learning from Human Feedback (RLHF)

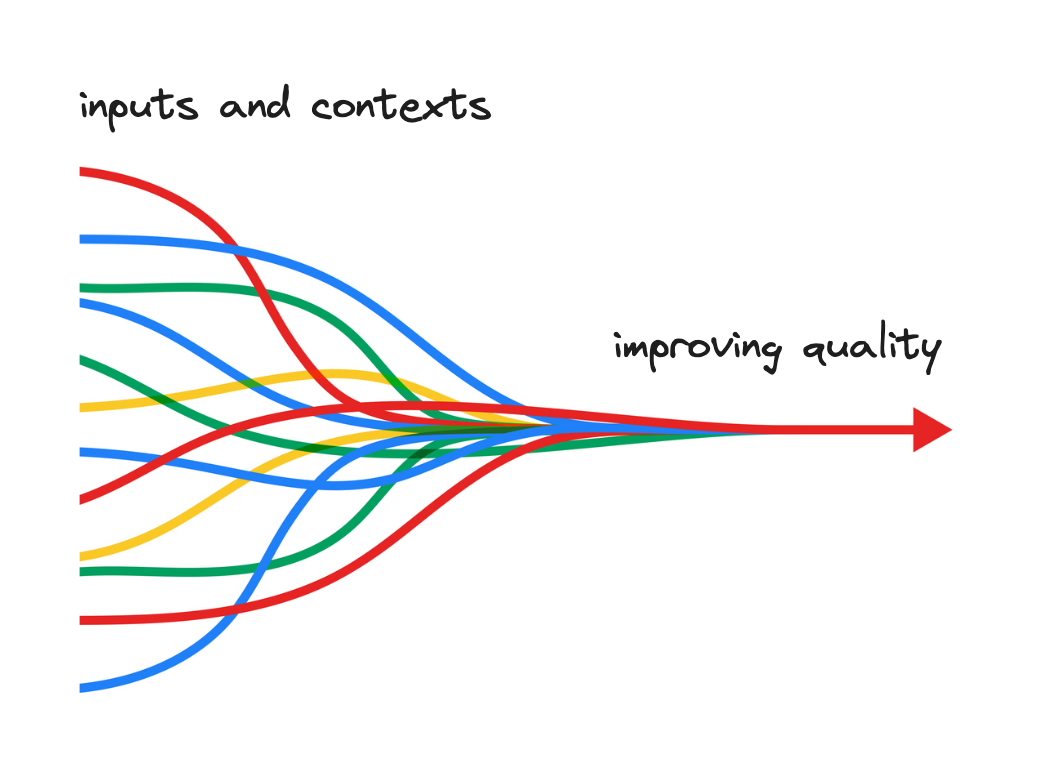
Maior robustez

  • Resiliente a diferentes tipos de entrada
  • Melhorando seu desempenho

Um diagrama mostrando qualidade aprimorada graças a diferentes entradas e contextos.

Reinforcement Learning from Human Feedback (RLHF)

Integração de dados de preferência de múltiplas fontes

Dados de preferência preference_df com fontes 'Journalist', 'Social Media Influencer' e 'Marketing Professional':
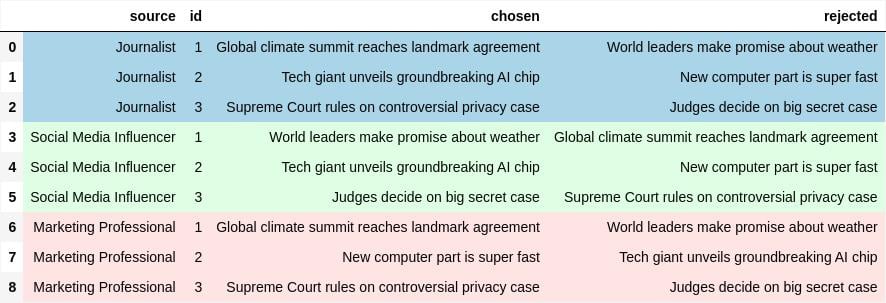
Uma tabela mostrando dados estruturados de três fontes diferentes

Reinforcement Learning from Human Feedback (RLHF)

Votação por maioria

Este exemplo pode ser integrado facilmente agrupando por 'id':

df_majority = preference_df.groupby(['id']).apply(majority_vote)

Em seguida, usando votação por maioria:

from collections import Counter

def majority_vote(df):
    votes = Counter(zip(df['chosen'], df['rejected'])) 
    return max(votes, key=votes.get)
Reinforcement Learning from Human Feedback (RLHF)

Fontes de dados de preferência não confiáveis

Dados de preferência preference_df2 com os mesmos três especialistas:
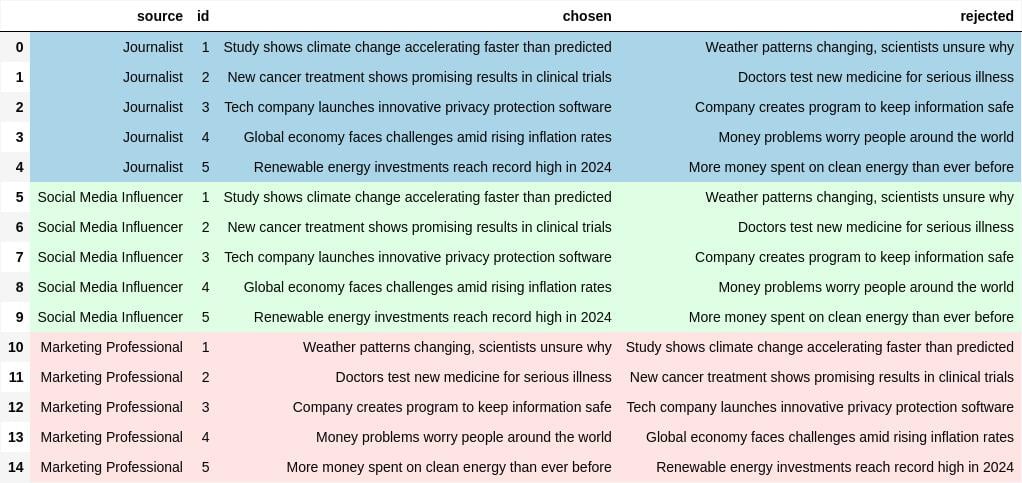
Uma tabela mostrando dados estruturados de três fontes diferentes

Reinforcement Learning from Human Feedback (RLHF)

Fontes de dados de preferência não confiáveis

  • Iterando pelas linhas de preference_df2 para identificar fontes não confiáveis:
df_majority = preference_df2.groupby('id').apply(majority_vote)

disagreements = {source: 0 for source in preference_df2['source'].unique()}
for _, row in preference_df2.iterrows(): if (row['chosen'], row['rejected']) != df_majority[row['id']]: disagreements[row['source']] += 1
detect_unreliable_source = max(disagreements, key=disagreements.get)
Reinforcement Learning from Human Feedback (RLHF)

Vamos praticar!

Reinforcement Learning from Human Feedback (RLHF)

Preparing Video For Download...