Avaliando modelos RLHF

Reinforcement Learning from Human Feedback (RLHF)

Mina Parham

AI Engineer

Métricas de automação


  • Tarefa de classificação: Acurácia, F1-score
classification_results.head(3)
| ID | Feedback_Text                         | True_Category | Predicted_Category |
|----|---------------------------------------|---------------|--------------------|
| 1  | "Arrived on time and works great."    | Positive      | Positive           |
| 2  | "I had issues with customer service." | Negative      | Neutral            |
| 3  | "The website is easy to navigate."    | Positive      | Positive           |
Reinforcement Learning from Human Feedback (RLHF)

Métricas de automação


  • Geração de texto, sumarização: ROUGE, BLEU
text_generation.head(3)
| ID | Prompt               | True_Completion  | Pred_Completion   |
|----|----------------------|------------------|-------------------|
| 1  | "Customer service"   | "can help you."  | "will assist."    |
| 2  | "To get a refund,"   | "contact us."    | "reach out."      |
| 3  | "Support team is"    | "here 24/7."     | "available 24/7." |
Reinforcement Learning from Human Feedback (RLHF)

Métricas de automação


Declaração de referência:

  • RLHF melhora o alinhamento do modelo com valores humanos.


Pontuação ROUGE: 0,83


Declaração para comparar:

  • RLHF alinha modelos com valores humanos.
Reinforcement Learning from Human Feedback (RLHF)

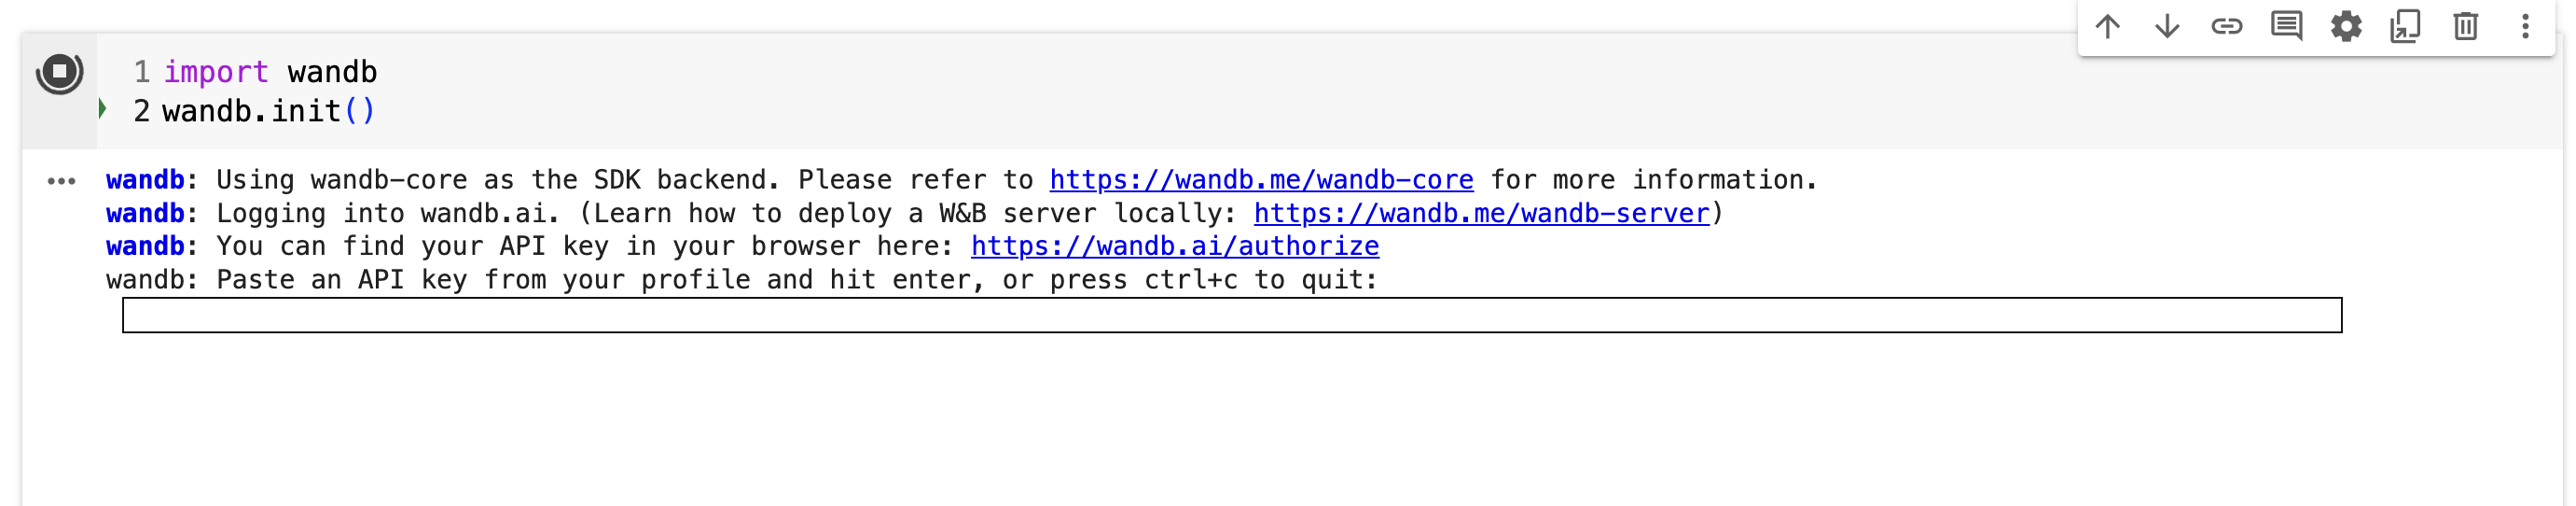
Curvas de artefatos

config = PPOConfig(
    model_name="lvwerra/gpt2-imdb",learning_rate=1.41e-5, log_with="wandb")
import wandb
wandb.init()

Uma captura de tela da saída do terminal no Weights and Biases.

Reinforcement Learning from Human Feedback (RLHF)

Curvas de artefatos

  • A recompensa aumenta conforme o modelo aprende.
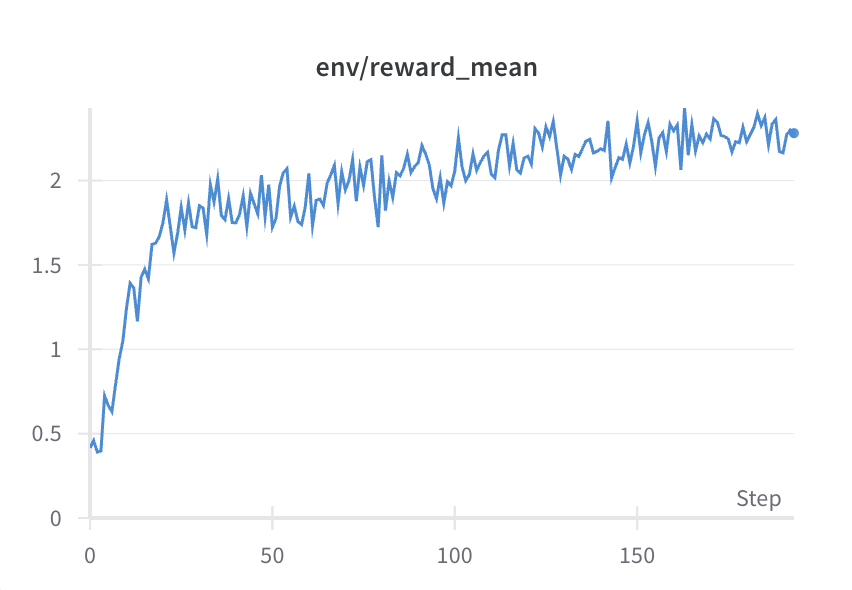
Uma curva mostrando tendência de alta na recompensa, indicando que o modelo está melhorando.

  • A curva de KL deve subir gradualmente.
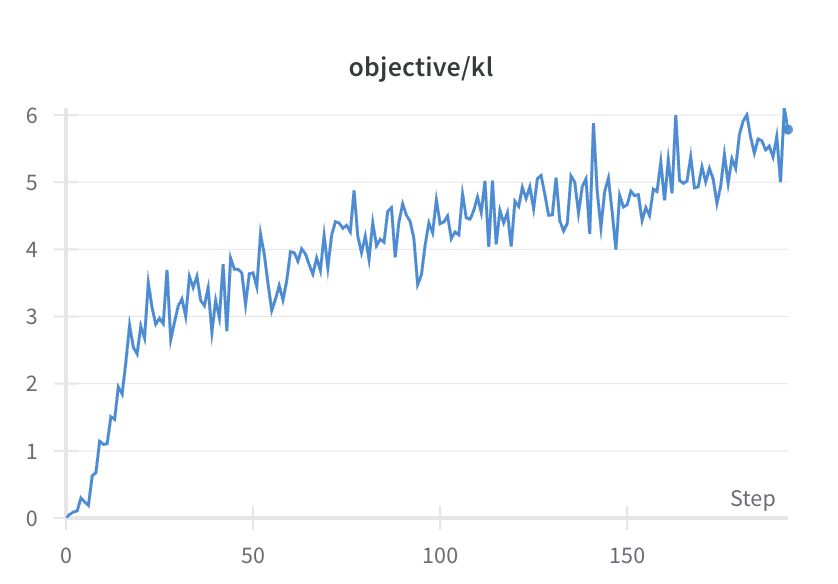
Uma curva mostrando uma tendência gradual de alta na perda KL.

Reinforcement Learning from Human Feedback (RLHF)

Avaliação centrada no humano

  • Avaliação humana: julgamentos subjetivos ou entendimento profundo de contexto
Uma avaliadora humana usando o laptop.

  • Avaliação por modelos: escalabilidade e consistência
Um robô com balões de fala representando um avaliador de modelos.

Reinforcement Learning from Human Feedback (RLHF)

Vamos praticar!

Reinforcement Learning from Human Feedback (RLHF)

Preparing Video For Download...