Noções básicas de spaCy

Processamento de Linguagem Natural com spaCy

Azadeh Mobasher

Principal Data Scientist

Pipeline de NLP do spaCy

import spacy

nlp = spacy.load("en_core_web_sm")
doc = nlp("Here's my spaCy pipeline.")
  • Importe spaCy
  • Use spacy.load() para obter nlp, uma classe Language
    • O objeto Language é o pipeline de processamento de texto
  • Aplique nlp() em qualquer texto para obter um contêiner Doc
Processamento de Linguagem Natural com spaCy

Pipeline de NLP do spaCy


spaCy aplica algumas etapas de processamento usando sua classe Language:
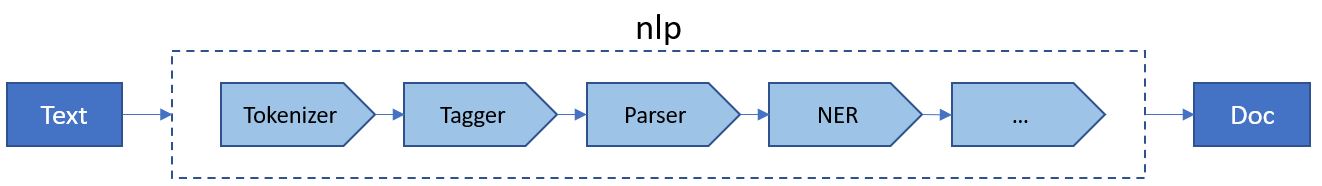
Pipeline da classe Language do spaCy

Processamento de Linguagem Natural com spaCy

Objetos contêiner no spaCy

  • Há várias estruturas de dados para representar texto no spaCy:


Nome Descrição
Doc Contêiner para acessar anotações linguísticas do texto
Span Um recorte de um objeto Doc
Token Um token individual: palavra, pontuação, espaço etc.
Processamento de Linguagem Natural com spaCy

Componentes do pipeline

  • O pipeline de processamento do spaCy sempre depende do modelo carregado e seus recursos.


Componente Nome Descrição
Tokenizer Tokenizer Segmenta o texto em tokens e cria o objeto Doc
Tagger Tagger Atribui tags de classe gramatical
Lemmatizer Lemmatizer Reduz palavras às suas formas base
EntityRecognizer NER Detecta e rotula entidades nomeadas
Processamento de Linguagem Natural com spaCy

Componentes do pipeline


  • Cada componente tem recursos únicos para processar texto

    • Language
    • DependencyParser
    • Sentencizer
Processamento de Linguagem Natural com spaCy

Tokenização

  • Sempre a primeira operação
  • Todas as outras operações precisam de tokens
  • Tokens podem ser palavras, números e pontuação
import spacy
nlp = spacy.load("en_core_web_sm")

doc = nlp("Tokenization splits a sentence into its tokens.")

print([token.text for token in doc])
['Tokenization', 'splits', 'a', 'sentence', 'into', 'its', 'tokens', '.']
Processamento de Linguagem Natural com spaCy

Segmentação de sentenças

  • Mais complexa que a tokenização
  • É parte do componente DependencyParser
import spacy
nlp = spacy.load("en_core_web_sm")

text = "We are learning NLP. This course introduces spaCy."
doc = nlp(text)

for sent in doc.sents: print(sent.text)
We are learning NLP.
This course introduces spaCy.
Processamento de Linguagem Natural com spaCy

Lematização

  • Um lema é a forma base de um token
  • O lema de eats e ate é eat
  • Melhora a precisão de modelos de linguagem
import spacy
nlp = spacy.load("en_core_web_sm")
doc = nlp("We are seeing her after one year.")

print([(token.text, token.lemma_) for token in doc])
[('We', 'we'), ('are', 'be'), ('seeing', 'see'), ('her', 'she'), 
('after', 'after'), ('one', 'one'), ('year', 'year'), ('.', '.')]
Processamento de Linguagem Natural com spaCy

Vamos praticar!

Processamento de Linguagem Natural com spaCy

Preparing Video For Download...