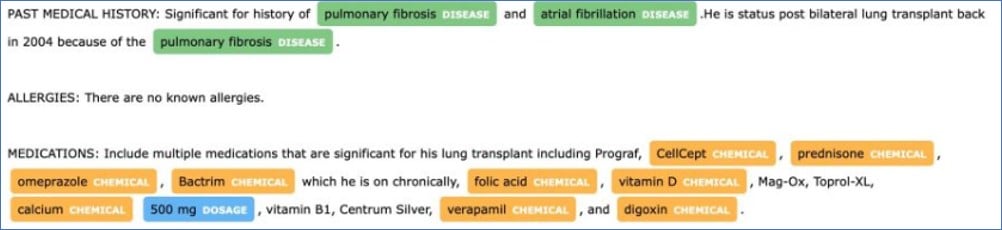
Encerramento
Processamento de Linguagem Natural com spaCy

Azadeh Mobasher
Principal data scientist
Capítulo 1 - Introdução a NLP e spaCy
- Use os pipelines de processamento de texto do
spaCypara extrair recursos linguísticos:
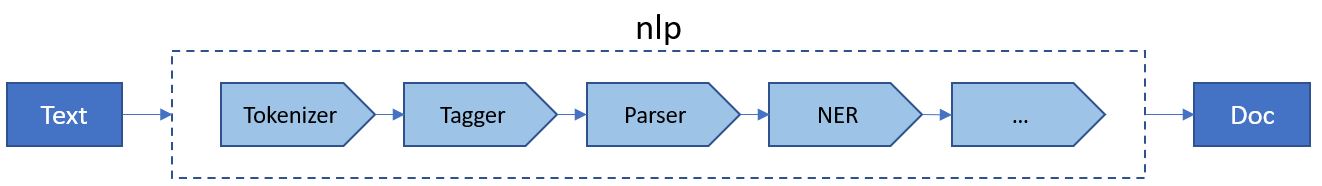
Capítulo 2 - Anotações linguísticas do spaCy e vetores de palavras
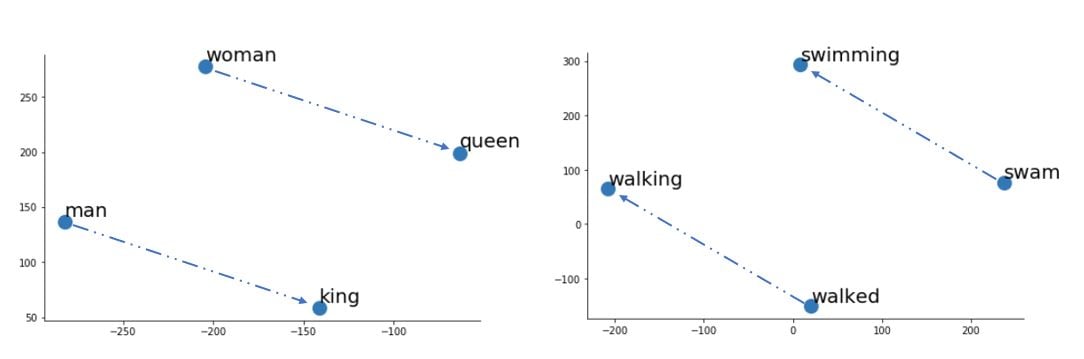
- Trabalhe com classes do
spaCy, comoDoc,TokeneSpan, e preveja similaridades semânticas usando vetores de palavras:
Capítulo 4 - Personalizando modelos do spaCy
- Anote e prepare os dados para treinamento
- Treine modelos do
spaCye use-os na inferência