Medindo similaridade semântica com spaCy

Processamento de Linguagem Natural com spaCy

Azadeh Mobasher

Principal Data Scientist

O método de similaridade semântica


  • Processo de analisar textos para identificar semelhanças
  • Classifica textos em categorias predefinidas ou detecta textos relevantes
  • Pontuação de similaridade mede o quão parecidos são dois textos


What is the cheapest flight from Boston to Seattle?
Which airline serves Denver, Pittsburgh and Atlanta?
What kinds of planes are used by American Airlines?
Processamento de Linguagem Natural com spaCy

Pontuação de similaridade

  • Uma métrica definida sobre textos
  • Para medir similaridade, use similaridade do cosseno e vetores de palavras
  • Similaridade do cosseno é um número entre 0 e 1
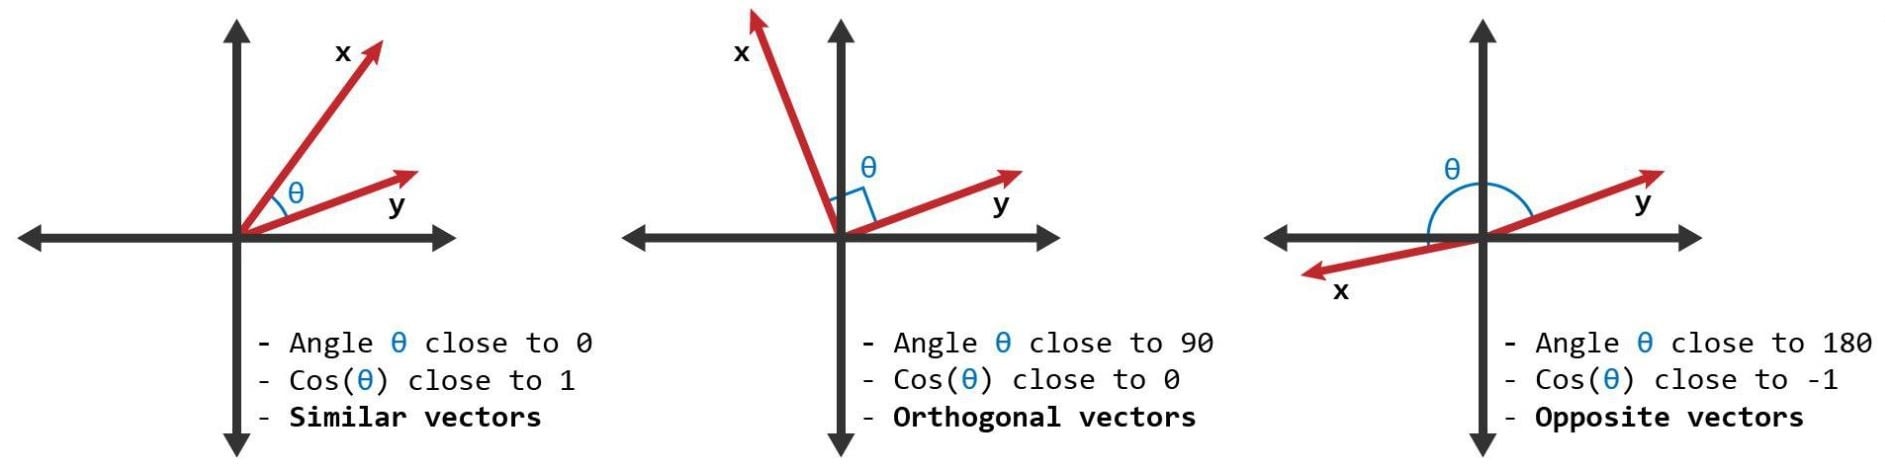
Similaridade do cosseno e vetores

Processamento de Linguagem Natural com spaCy

Similaridade entre tokens

  • spaCy calcula pontuações de similaridade entre objetos Token
nlp = spacy.load("en_core_web_md")
doc1 = nlp("We eat pizza")
doc2 = nlp("We like to eat pasta")

token1 = doc1[2] token2 = doc2[4] print(f"Similarity between {token1} and {token2} = ", round(token1.similarity(token2), 3))
>>> Similarity between pizza and pasta =  0.685
Processamento de Linguagem Natural com spaCy

Similaridade entre spans

  • spaCy calcula a similaridade semântica de dois objetos Span
doc1 = nlp("We eat pizza")
doc2 = nlp("We like to eat pasta")

span1 = doc1[1:]
span2 = doc2[1:]

print(f"Similarity between \"{span1}\" and \"{span2}\" = ", round(span1.similarity(span2), 3))
>>> Similarity between "eat pizza" and "like to eat pasta" =  0.588
print(f"Similarity between \"{doc1[1:]}\" and \"{doc2[3:]}\" = ",
        round(doc1[1:].similarity(doc2[3:]), 3))
>>> Similarity between "eat pizza" and "eat pasta" =  0.936
Processamento de Linguagem Natural com spaCy

Similaridade entre Docs

  • spaCy calcula a similaridade entre dois documentos
nlp = spacy.load("en_core_web_md")

doc1 = nlp("I like to play basketball")
doc2 = nlp("I love to play basketball")
print("Similarity score :", round(doc1.similarity(doc2), 3))
>>> Similarity score : 0.975
  • Alta similaridade do cosseno indica conteúdos muito semelhantes
  • Vetores Doc são, por padrão, a média dos vetores de palavras
Processamento de Linguagem Natural com spaCy

Similaridade entre sentenças

  • spaCy encontra conteúdo relevante para uma palavra-chave
  • Encontrando perguntas de clientes semelhantes à palavra price:
sentences = nlp("What is the cheapest flight from Boston to Seattle? 
                 Which airline serves Denver, Pittsburgh and Atlanta? 
                 What kinds of planes are used by American Airlines?")

keyword = nlp("price")

for i, sentence in enumerate(sentences.sents): print(f"Similarity score with sentence {i+1}: ", round(sentence.similarity(keyword), 5))
>>> Similarity score with sentence 1:  0.26136
Similarity score with sentence 2:  0.14021
Similarity score with sentence 3:  0.13885
Processamento de Linguagem Natural com spaCy

Vamos praticar!

Processamento de Linguagem Natural com spaCy

Preparing Video For Download...