Regressão e previsão

Análise de Dados Bayesiana em Python

Michal Oleszak

Machine Learning Engineer

Regressão linear

$$y = \beta_0 + \beta_1x_1 + \beta_2x_2 + ...$$

$$\text{sales} = \beta_0 + \beta_1\text{marketingSpending}$$


  • Inferência frequentista:

    • $\text{sales} = \beta_0 + \beta_1\text{marketingSpending} + \varepsilon$

    • $\varepsilon \sim \mathcal{N} (0, \sigma)$


  • Inferência Bayesiana:

    • $\text{sales} \sim \mathcal{N} (\beta_0 + \beta_1\text{marketingSpending}, \sigma)$
Análise de Dados Bayesiana em Python

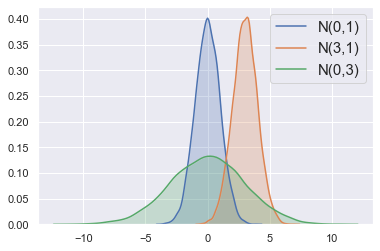
Distribuição normal

normal_0_1 = np.random.normal(0, 1, size=10000)


sns.kdeplot(normal_0_1, shade=True, label="N(0,1)") plt.show()

Uma densidade da distribuição normal padrão, com pico em 0 e simétrica.

Análise de Dados Bayesiana em Python

Distribuição normal

normal_0_1 = np.random.normal(0, 1, size=10000)
normal_3_1 = np.random.normal(3, 1, size=10000)


sns.kdeplot(normal_0_1, shade=True, label="N(0,1)")
sns.kdeplot(normal_3_1, shade=True, label="N(3,1)")


plt.show()

Uma densidade da normal com pico em 3 e simétrica.

Análise de Dados Bayesiana em Python

Distribuição normal

normal_0_1 = np.random.normal(0, 1, size=10000)
normal_3_1 = np.random.normal(3, 1, size=10000)
normal_0_3 = np.random.normal(0, 3, size=10000)

sns.kdeplot(normal_0_1, shade=True, label="N(0,1)")
sns.kdeplot(normal_3_1, shade=True, label="N(3,1)")
sns.kdeplot(normal_0_3, shade=True, label="N(0,3)")

plt.show()

Uma densidade da distribuição normal padrão, com pico em 0 e simétrica.

Análise de Dados Bayesiana em Python

Definição do modelo de regressão Bayesiana

$$\text{sales} \sim \mathcal{N} (\beta_0 + \beta_1\text{marketingSpending}, \sigma)$$

$$\beta_0 \sim \mathcal{N} (5, 2)$$

$$\beta_1 \sim \mathcal{N} (2, 10)$$

$$\sigma \sim \mathcal{Unif} (0, 3)$$


  • Esperamos $5000$ vendas sem nenhum marketing.
  • Esperamos aumento de $2000$ vendas para cada $1000$ a mais em gasto.
  • Prior uniforme para o desvio padrão, pois não sabemos seu valor.
Análise de Dados Bayesiana em Python

Estimando parâmetros da regressão

  • Aproximação por grade   →   impraticável com muitos parâmetros
  • Escolher priors conjugados e simular de uma posterior conhecida   →   priors pouco intuitivos
  • Terceira via: simular da posterior mesmo com priors não conjugados!
  • Por ora, assuma que os sorteios dos parâmetros são dados
Análise de Dados Bayesiana em Python

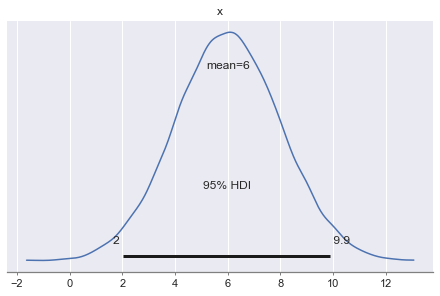
Plotar a posterior

$$\text{sales} = \beta_0 + \beta_1\text{marketingSpending}$$

print(marketing_spending_draws)
array([9.6153, 8.9922, ..., 4.59565])
import pymc3 as pm

pm.plot_posterior(
  marketing_spending_draws, 
  hdi_prob=0.95
)

Um gráfico de densidade com a média e o intervalo crível marcados.

Análise de Dados Bayesiana em Python

Análise dos sorteios da posterior

posterior_draws_df = pd.DataFrame({
    "intercept_draws": intercept_draws,
    "marketing_spending_draws": marketing_spending_draws,
    "sd_draws": sd_draws
})

print(posterior_draws_df)
       intercept_draws  marketing_spending_draws      sd_draws
count     10000.000000              10000.000000  10000.000000
mean          2.972130                  5.999146      1.337621
std           3.008565                  2.020708      0.471723
min          -8.562093                 -2.842438      0.029643
25%           0.972832                  4.621807      1.003229
50%           3.002940                  5.975067      1.427617
75%           5.020615                  7.362572      1.736310
max          15.228549                 13.258955      1.999834
Análise de Dados Bayesiana em Python

Distribuição preditiva

Quanto de vendas esperar se gastarmos $1000$ em marketing?
$\text{sales} \sim \mathcal{N} (\beta_0 + \beta_1\text{marketingSpending}, \sigma)$

# Obter estimativas pontuais dos parâmetros
intercept_mean = intercept_draws.mean()
marketing_spending_mean = marketing_spending_draws.mean()
sd_mean = sd_draws.mean()


# Calcular a média da distribuição preditiva predictive_mean = intercept_mean + marketing_spending_mean * 1000
# Simular da distribuição preditiva prediction_draws = np.random.normal(predictive_mean, sd_mean, size=10000)
Análise de Dados Bayesiana em Python

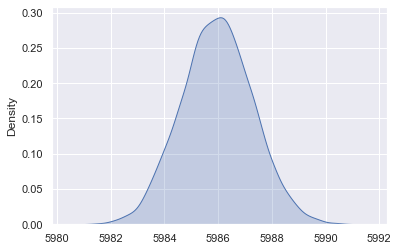
Distribuição preditiva

Quanto de vendas esperar se gastarmos $1000$ em marketing?

Uma densidade em forma de sino das vendas previstas com pico em ~5986.

Análise de Dados Bayesiana em Python

Vamos regredir e prever!

Análise de Dados Bayesiana em Python

Preparing Video For Download...