Text mining to detect fraud

Detecção de Fraudes em Python

Charlotte Werger

Data Scientist

Limpando seus dados de texto

O que fazer ao trabalhar com texto:

  1. Tokenização

  2. Remover todas as stopwords

  3. Lematizar as palavras

  4. Aplicar stemming

Detecção de Fraudes em Python

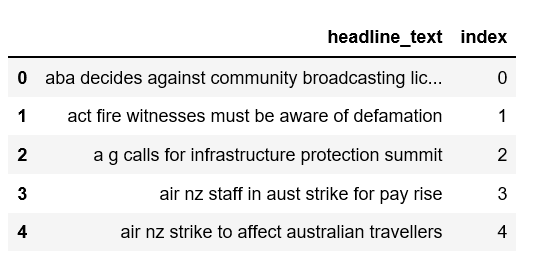
Ir disto...

Detecção de Fraudes em Python

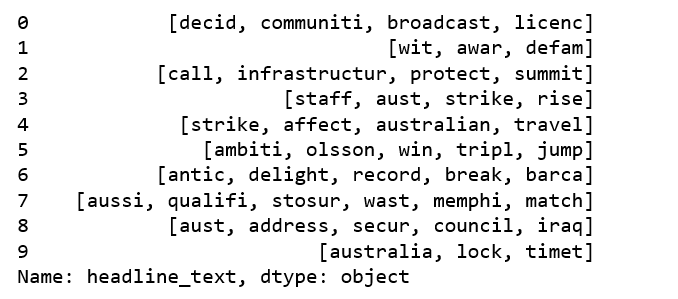
Para isto...

Detecção de Fraudes em Python

Pré-processamento de dados — parte 1

# 1. Tokenization
from nltk import word_tokenize
text = df.apply(lambda row: word_tokenize(row["email_body"]), axis=1)
text = text.rstrip()
text = re.sub(r'[^a-zA-Z]', ' ', text)
# 2. Remove all stopwords and punctuation
from nltk.corpus import stopwords 
import string
exclude = set(string.punctuation)
stop = set(stopwords.words('english'))
stop_free = " ".join([word for word in text 
           if((word not in stop) and (not word.isdigit()))])
punc_free = ''.join(word for word in stop_free 
           if word not in exclude)
Detecção de Fraudes em Python

Pré-processamento de dados — parte 2

# Lemmatize words
from nltk.stem.wordnet import WordNetLemmatizer
lemma = WordNetLemmatizer()
normalized = " ".join(lemma.lemmatize(word) for word in punc_free.split())

# Stem words from nltk.stem.porter import PorterStemmer porter= PorterStemmer() cleaned_text = " ".join(porter.stem(token) for token in normalized.split())
print (cleaned_text)
['philip','going','street','curious','hear','perspective','may','wish','offer','trading','floor','enron',
 'stock','lower','joined','company','business','school','imagine','quite','happy','people','day', 
 'relate','somewhat','stock','around','fact','broke','day','ago','knowing','imagine','letting',
 'event','get','much','taken','similar','problem','hope','everything','else','going','well','family',
 'knee','surgery','yet','give','call','chance','later']
Detecção de Fraudes em Python

Vamos praticar!

Detecção de Fraudes em Python

Preparing Video For Download...